HTTP2Shellとは ―Node.jsやPythonに広がるBrotli脆弱性の影響と対策

Share
HTTP2Shell(CVE-2026-111497)とは?影響製品と対策を解説アイキャッチ画像

WebサイトやAPIの安全性を確認する際は、外部からのリクエストだけでなく、アプリケーションが受信するレスポンスにも注意が必要です。HTTP2Shell(CVE-2026-111497)は、GoogleのBrotliデコーダーに存在する脆弱性で、細工された圧縮データの展開によって、情報漏洩や任意コード実行につながるおそれがあります。Node2Shellとも呼ばれるこの問題は、Node.jsに加え、Python関連パッケージやBun、Envoyなど幅広い製品に影響します。本記事では、主な攻撃経路、影響を受ける製品、修正版と対策を解説します。

HTTP2ShellとNode2Shellの関係

Brotliは、Webコンテンツなどのデータを小さくするために使われる圧縮方式です。HTTP通信では、本文がBrotli形式で圧縮されていることをContent-Encoding: brというヘッダーで示します。本脆弱性は、当初Node.jsへの影響が注目されたことから「Node2Shell」と呼ばれていました*1。その後、Brotliを利用する複数の製品にも影響が及ぶことが明らかになり、「HTTP2Shell」という呼称も使われるようになりました。なお、名称にHTTPが含まれていますが、HTTP/2通信に限定された脆弱性ではありません。

問題があるのは、圧縮されたデータを元に戻すデコーダーです。不正なデータの処理を打ち切るべき場面で処理が続き、内部バッファの範囲を超えて書き込むことがあります。結果として、プロセスの停止やメモリ内の情報漏洩、条件によっては遠隔からの任意コード実行(RCE)につながります。

Googleが登録したCVEレコードの評価はCVSS v4.0で9.2、深刻度はCriticalです。一方、Node.jsの公式告知ではHighに分類されています*2。確認すべきなのは、脆弱なBrotliデコーダーを使用し、攻撃者が用意したデータがそこに届くかどうかです。

HTTPリクエストとレスポンスの両方が攻撃経路になる

受信側では、WebアプリケーションがBrotli圧縮されたリクエスト本文を展開する経路が問題になります。Impervaは、Express 5やbody-parser 2系でBrotli圧縮された本文を展開する構成で、細工したデータがNode.jsに内包されるデコーダーへ渡るケースを検証しています*3。⁠

もう一つは、アプリケーションがHTTPクライアントとして通信する経路です。Node.jsの組み込みfetchがBrotli圧縮された応答を展開すると、接続先のサーバーが返したデータがデコーダーに届きます。公開APIへの入力対策とあわせて、外部サイトから情報を取得する機能にも目を向ける必要があります。

図1:HTTP2Shellで確認する二つの攻撃経路
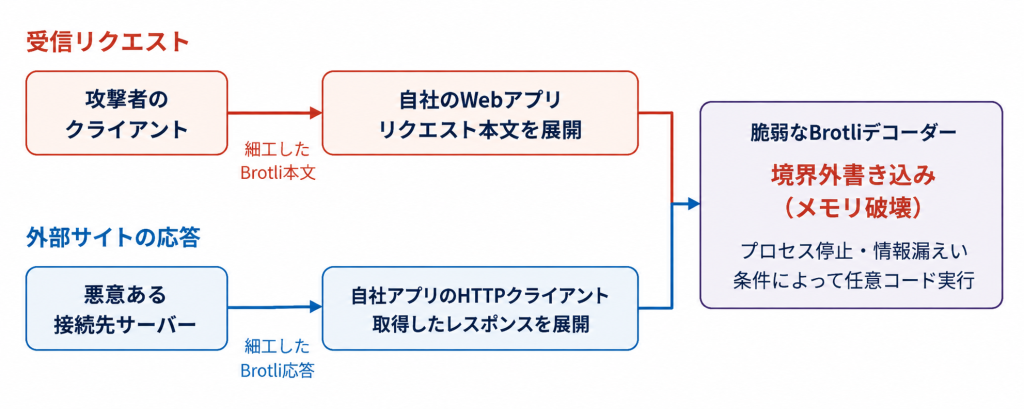
脆弱なBrotliデコーダーに細工されたデータが届く二つの攻撃経路を示した概念図
出典:Imperva, Inc.、Bunプロジェクトの公開情報をもとに作成。
※任意コード実行の成立条件は製品や構成によって異なります。

影響を受ける製品と修正版

影響調査では、開発言語の名前だけで範囲を区切らないことが大切です。Pythonの場合は、Python本体全体の問題として扱うのではなく、Brotliやbrotlicffiといったパッケージの導入状況を調べます。urllib3やrequestsなどは、これらのパッケージが利用できる環境でBrotli応答を自動展開するため、アプリケーションのコードにBrotliの呼び出しが見当たらなくても確認が必要です。

表1:主要コンポーネントの修正版と確認する条件

コンポーネント修正版確認する条件
Google Brotli1.0.10/1.1.1/1.2.11.0.3~1.0.9、1.1.0、1.2.0
Node.js22.23.4/24.22.1/26.12.1各系列の未修正版。内包するデコーダーの利用経路を確認
Python関連パッケージBrotli 1.2.1
brotlicffi 1.2.1.0
仮想環境やコンテナーごとの導入状況を確認
Bun1.4.41.0.21以上1.4.4未満。コンパイル済み実行ファイルも確認
Envoy1.40.0/1.39.3/1.38.6/1.37.8/1.36.12Brotli展開フィルターを設定した環境
Istio1.31.2/1.30.6/1.29.9Brotli展開を有効にした環境。1.29系はサポート終了
出典:Google LLC、Node.jsプロジェクト、GitHub Advisory Database、Bunプロジェクト、Envoy Proxyプロジェクト、Istioプロジェクトをもとに作成。
※主要コンポーネントの修正版と確認条件を整理しています。バージョン番号は各開発元の公表値です。影響製品を網羅したものではなく、利用環境に応じて各製品の公式情報を確認してください。

EnvoyではBrotliの展開フィルターを設定した環境、IstioではEnvoyFilterなどを使ってBrotli展開を有効にした環境が確認対象です。製品名が一致するだけで、すべての構成が同じ攻撃経路を持つとは限りません。反対に、別製品に内包されたライブラリは、アプリケーションの依存パッケージ一覧だけでは見落とすおそれがあります。

コード実行の実証と実際の攻撃を分けて読む

Impervaは、公式のNode.js 24.22.0のLinux arm64イメージを用いた実験で、細工したBrotliデータによるコード実行を報告しています。修正版の24.22.1では同じ入力が拒否されました。ただし、実験環境では成功まで複数回の試行を要しています。この結果を、すべてのOSや構成で同じ攻撃が成立するという意味に広げることはできません。

また、研究環境での実証は、実際の組織に対する攻撃成功の報告とは別です。CVEレコードに収録されたCISAの評価では、2026年10月23日時点のExploitation(悪用状況)が「none」とされています。ただし、これは評価時点の情報であり、その後の悪用の有無を保証するものではありません。修正の優先順位は、被害報告の有無だけでなく、自社環境で攻撃者が用意したデータが脆弱な展開処理へ届くかどうかを踏まえて判断する必要があります。

Go向けBrotli実装にも関連する報告があります。Sweet Securityはv1.2.6でpanicと接続切断を再現しましたが、その実験ではアプリケーション全体は動作を続けていました。Go実装で任意コード実行やプロセス全体の停止が実証されたわけではありません*4。メンテナーは10月23日に修正コミット33c2a98による対応を報告しています*5。

更新する対象を実行環境まで追う

Node.jsを使う環境では、Brotliを内包するNode.jsランタイムそのものを更新する必要があります。Pythonでは仮想環境ごとにパッケージを確認し、コンテナーを使っている場合は、更新後の構成でイメージを再ビルドして再配置します。管理画面に表示された設定値だけでなく、稼働中のプロセスに修正が反映されていることまで確認します。

Bunでは、bun build –compileで作成した実行ファイルにランタイムが埋め込まれます。開発端末のBunを更新しても、すでに配布した実行ファイルは自動では直りません。公式告知はBun 1.4.4への更新と、該当する実行ファイルの再ビルドを求めています*6。製品に組み込まれたBrotliを修正するには、製品側の更新が必要になる点に注意してください。

図2:影響確認から修正の反映までの流れ
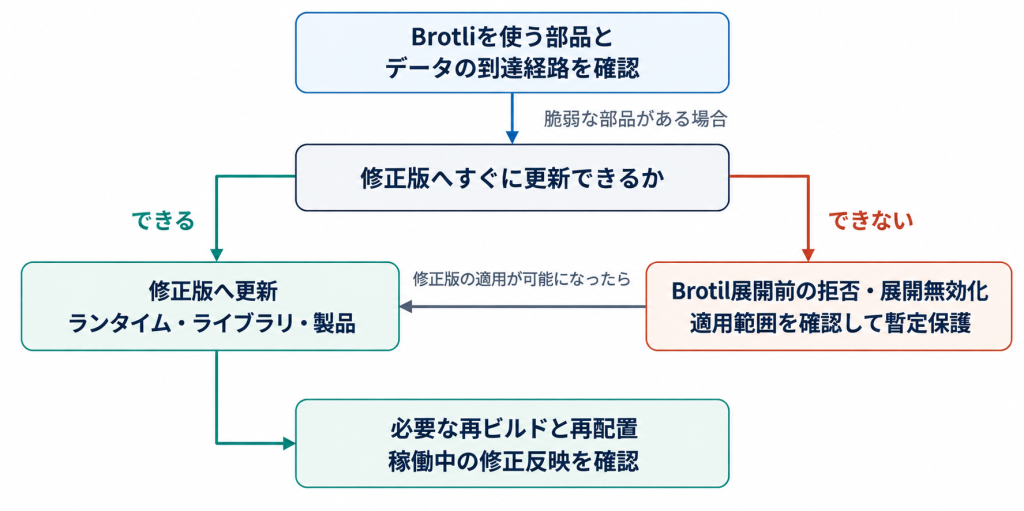
影響確認から修正版の適用までの対応を整理した概念図
出典:Node.jsプロジェクト、Aikido Security BV、Bunプロジェクト、Envoy Proxyプロジェクトの公開情報をもとに作成。
※暫定対策は修正版への更新を代替するものではありません。

更新までの暫定対策では展開前に止める

すぐに更新できない場合は、脆弱なデコーダーにBrotli圧縮データが渡らないようにすることが暫定対策となります。受信リクエストでは、Brotli形式の本文を展開する前に拒否する方法があります。外部サイトからのレスポンスについても、Brotli展開を無効にするか、展開前に拒否できるかを確認します。送信するAccept-Encodingからbrを削除するだけでは、接続先がBrotli圧縮されたレスポンスを返す可能性を排除できません。

回避策の設定方法は製品によって異なります。Bunの公式告知では、fetchの呼び出しにdecompress: falseを指定する方法が示されていますが、その呼び出しだけに適用される設定です。ほかのBrotli展開処理まで一括して無効になるわけではありません。回避策の対象範囲を確認したうえで修正版へ更新してください。

HTTP2Shellへの対応では、公開Webサーバーの点検に加え、外部と通信するアプリケーションや製品内の依存ライブラリまで確認を進めます。Brotliを含む実行環境を洗い出し、攻撃者のデータが届く経路を確認したうえで、稼働中のプロセスに修正が反映されたことまで確かめてください。外部から細工されたBrotliデータを受信・展開する可能性があった環境では、修正版の適用に加え、不審なプロセスの異常終了や関連ログなどを確認し、侵害の兆候がないか調査することも重要です。

Webアプリケーションのセキュリティ対策を見直しませんか?

公開WebサイトやAPIの安全性を維持するには、利用するソフトウェアの更新に加え、アプリケーション全体の脆弱性を継続的に確認することが重要です。ブロードバンドセキュリティ(BBSec)では、Webアプリケーションの脆弱性診断を通じて、企業のセキュリティ対策を支援しています。
SQATWebアプリケーション脆弱性診断サービスページバナーリンク

【参考情報】

編集責任:木下

ウェビナー開催のお知らせ

最新情報はこちら

Security NEWS TOPに戻る
バックナンバー TOPに戻る

eMudhraの中間CA秘密鍵が復元可能に ―証明書の信頼問題と企業のTLS対策

Share
eMudhraの中間CA秘密鍵が復元可能に ―証明書の信頼問題と企業のTLS対策アイキャッチ画像

HTTPS通信では、サーバー証明書の検証によって接続先の正当性を確認します。しかし、その信頼の根拠となる認証局の秘密鍵が第三者に悪用されると、なりすましの危険が生じます。2026年10月、認証局eMudhraの中間CA証明書8件に対応する秘密鍵が、第三者でも容易に復元できる状態だったことが明らかになりました。MozillaやGoogleは対象証明書の信頼を遮断する対策を進め、関連ソフトウェアの更新も行われています。企業が確認すべきなのは、自社サイトで使用するSSL/TLS証明書だけではありません。外部サービスへ接続する業務アプリの証明書検証機能も対象です。本記事では、問題の概要と影響範囲、API通信を含むシステムの確認事項を整理します。

※本記事は2026年10月22日時点で公表されている情報を基に作成しています。認証局の調査結果や各ソフトウェアの対応状況は、今後変更される可能性があります。

中間証明書とは サーバー証明書を信頼につなぐ役割

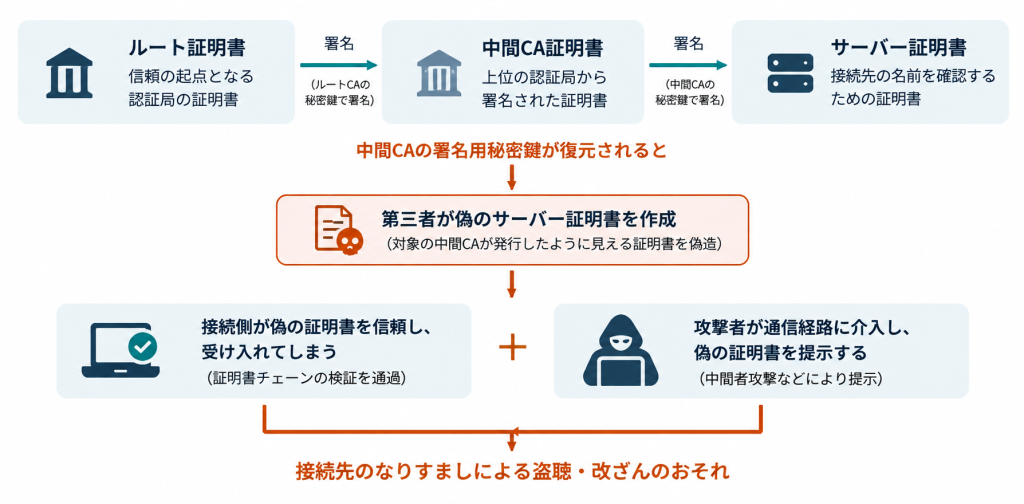
中間証明書は、ルート認証局から個々のサーバー証明書へ信頼をつなぐ証明書です。一般的な証明書チェーンでは、ブラウザやOSなどが信頼するルート証明書を起点に、中間CA証明書、その下のサーバー証明書へと署名の関係が続きます。接続する側はこの関係などを検証し、相手の証明書を受け入れてよいか判断します。

Webサイトの運営者が持つ秘密鍵と、中間CAが証明書に署名するための秘密鍵は役割が異なります。後者を第三者が使用できる状態になると、攻撃者は対象の中間CAが正規に発行したかのように見える証明書を偽造できるおそれがあります。今回、問題となったのはこの署名用の秘密鍵です。通信経路に介入できる攻撃者が偽の証明書を提示し、接続側が受け入れると、通信内容を読み取られたり書き換えられたりするおそれがあります。

図1:中間CAの秘密鍵とサーバー証明書の信頼の関係

中間CAの秘密鍵とサーバー証明書の信頼の関係
出典:株式会社インターネットイニシアティブ「サーバ証明書の仕組みに関すること」、Mozilla Corporation(Firefox Security Team)「Protecting Firefox users following the compromise of eMudhra intermediate certificates」、Mozilla Foundation(Bugzilla)「eMudhra: Private key compromise of Intermediate Certificates(Bug 2083449)」を基に弊社作成。
※TLSの証明書チェーンと攻撃成立の条件を簡略化した概念図です。実際には複数の中間CAやクロス署名が存在する場合があります。秘密鍵の復元だけで通信の盗聴・改ざんが成立することを示すものではありません。

eMudhraの中間CAで秘密鍵の生成に問題が発覚

Mozillaの調査記録によると、対象8件のうち6件はTLS用、2件はコード署名用です。Mozillaは2026年10月17日20時06分(UTC)に報告を受け、通常設定のFirefox向けには同日22時59分までにOneCRLによる遮断を配信しました。日本時間では10月18日5時06分の受領から、同日7時59分までの対応です。対象の鍵は楕円曲線暗号P-384を使っていましたが、秘密鍵の値はすべて256未満の整数でした。独立して検証した研究者Scott Helme氏も、公開証明書から対象の鍵をノートPCで1秒未満に復元できたと報告しています。十分なランダム性を持つ値が必要なところ、極端に小さな値が使われていたことが問題であり、適切に生成されたP-384の鍵まで容易に復元できるという話ではありません。

eMudhraは、2025年4月30日の鍵生成作業で、鍵を移送するためのwrap/unwrap工程に問題があり、正常な鍵とは別に弱い鍵が生成されたと説明しています。同社はHSM(ハードウェアセキュリティモジュール)を使用していたとしていますが、10月21日の更新時点で正確な根本原因は確定していません。現段階では、同社が説明する作業工程の問題と、今後の調査で確定する原因を分けて捉える必要があります。

ブラウザだけでなく業務アプリの証明書検証も確認

Chromeは10月17日に対象TLS中間CAの公開鍵をCRLSetで遮断しました。Googleによると、その遮断前に対象の中間CA配下のTLS証明書はCertificate Transparency(CT)のログに登録されていませんでした。このため、CTを必須とする標準設定のChromeなどでは、対象CAを使った偽造証明書が信頼される状態ではなかったと説明しています。

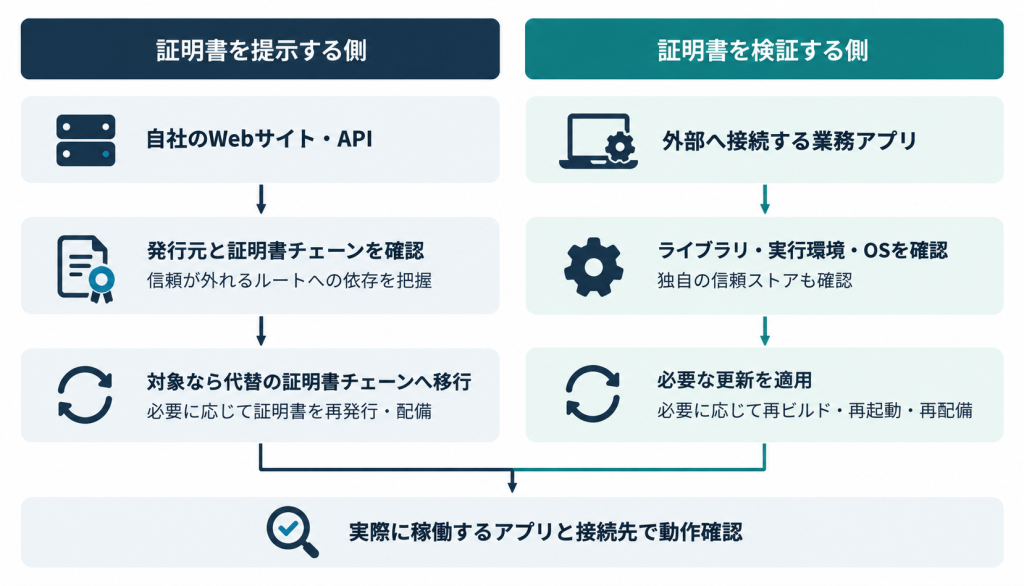
CTは、証明書の発行を公開ログで検証できるようにする仕組みです。認証局が証明書を失効させたという情報や、ブラウザ独自のブロックリストとは役割が異なります。失効情報やブロックリストを受け取らないアプリに、ブラウザと同じ対策が自動的に行き渡るとは限りません。業務アプリで証明書を検証するのは、HTTPライブラリやOS、独自の信頼ストアなどです。SDKだけの更新で対策が済むとは限りません。自社サイトの証明書の発行元が別でも、外部APIへ接続するアプリが対象CAを信頼する場合は確認が必要です。

図2:証明書を提示する側と検証する側の確認範囲

証明書を提示する側と検証する側の確認範囲
出典:Mozilla Foundation(Bugzilla)「eMudhra: Private key compromise of Intermediate Certificates(Bug 2083449)」、Google LLC(Chrome Root Program)「Compromised eMudhra Intermediate Certificatesへの公式投稿」、Cloudflare, Inc.「8 eMudhra certificates are compromised. Here’s what you need to know」を基に編集部作成。
※企業における確認対象を整理した概念図です。記載したすべての製品や環境が影響を受けることを示すものではありません。対応の要否は、実際の証明書チェーン、検証機能の実装、ソフトウェアの更新状況によって異なります。

中間CA証明書の失効とルートCAの信頼取り消し

eMudhraは、問題の8件の中間CAからエンドユーザー向け証明書を発行していなかったと説明しています。ただし、それだけで第三者による偽造の可能性がなくなるわけではありません。誰かが秘密鍵を復元し、認証局の正規の発行手続きを経ずに証明書を作ることが問題だからです。

Mozillaは、中間CAだけを個別に拒否する仕組みを持たないソフトウェアも保護するため、上位のルート証明書「emSign ECC Root CA – G3」の信頼を緊急に取り消す方針を示しました。GoogleもChrome Root Store v43で同ルートを削除する予定です。Googleが示した安定版への反映予定は、10月27日午前の米国太平洋夏時間で、10月22日時点では今後の対応に当たります。

ルートの信頼が外れると、問題の弱い鍵を使っていない別の中間CA配下であっても、そのルートにつながる正規のサーバー証明書が検証に失敗する場合があります。eMudhraは当初、移行が必要な証明書を約3万件と見積もりました。この数字は被害件数やWebサイト数ではありません。対象の階層を利用している場合は、有効期限を待たず、提供元の案内に沿って代替の証明書チェーンへ移行する必要があります。

FirefoxやGoなどの修正版と適用時の注意

Mozillaは10月20日、OneCRLの更新を受け取れない設定の利用者も保護するため、Firefox 158.0.1、Firefox ESR 115.43.1/153.5.1を公表しました。さらにAndroid版は10月21日に158.0.2が公開され、起動時に同梱のOneCRLブロックリストを適用する処理が修正されています。Android版では158.0.1だけを確認して対応済みとせず、この追加修正を含む更新を適用します。

Go 1.27.3および1.26.10では、対象の中間CA証明書を含む証明書チェーンを検証時に拒否する処理が追加されました。Goの脆弱性情報ではCVE-2026-111943、GO-2026-6809として管理されています。Go製アプリを運用する場合は、修正を取り込んだ製品版の有無を確認し、自社開発なら修正版でビルドした実行ファイルを配備することが対応になります。CloudflareはWARPなどのクライアントとcloudflaredの更新を公開しています。コンテナやアプリの依存関係も確認し、必要な再起動・再配備まで行います。

証明書の期限管理に検証経路の管理を加える

まず、WebサイトやAPIが提示する証明書チェーンを把握し、信頼が取り消される階層に依存していないかを確認します。同時に、外部のサービスへ接続する業務アプリについて、使用している証明書の検証機能と信頼ストアを調べます。証明書を提示する側と検証する側を分けると、証明書の交換が必要なのか、ソフトウェアやCA証明書の更新が必要なのかを整理できます。更新後は、実際の業務アプリで動作を確認します。ブラウザでの確認結果を、別の検証機能を使うバッチ処理やAPIクライアントの安全性の根拠にはできません。証明書エラーが出ても検証を無効にせず、チェーンや設定の原因を調べます。

今回の事案は、サーバー証明書が有効期限内であっても、認証局に対する信頼の変更によって証明書の交換やソフトウェアの更新が必要になることを示しています。企業には、証明書の発行元や有効期限だけでなく、証明書チェーンや検証に使用するソフトウェア、更新の管理体制まで把握し、継続的に確認することが求められます。


関連記事|TLS通信の安全性を確認するために

TLS通信の安全性を維持するには、証明書の信頼性に加え、暗号設定やTLSバージョンの適切な管理も重要です。基本的な仕組みから具体的な確認方法まで、以下の記事で紹介しています。

【参考情報】

編集責任:木下

ウェビナー開催のお知らせ

最新情報はこちら

Security Serviceへのリンクバナー画像
BBsecコーポレートサイトへのリンクバナー画像
セキュリティ緊急対応のバナー画像

Security NEWS TOPに戻る
バックナンバー TOPに戻る

国内で相次ぐ不正アクセス、企業が点検すべきAPIと業務システム

Share
国内で相次ぐ不正アクセス、企業が点検すべきAPIと業務システムアイキャッチ画像

不正アクセスに関する注意喚起を受け、自社で利用している製品を確認するだけでは、点検すべき範囲を見落とす可能性があります。Webサービスの裏側で動くAPIや、限られた従業員だけが使う業務システムまで含め、公開範囲と操作権限を確認することが重要です。

JPCERT/CCは2026年10月8日、国内組織で相次ぐ不正アクセスについて注意喚起を公表し、翌9日に情報を追加しました*7。本記事では、注意喚起のうちAPIや業務システムに関する内容を中心に、OWASPの技術資料も踏まえながら、企業が実施すべき点検方法を解説します。

今回の注意喚起で確認されていること

JPCERT/CCが取り上げているのは、2026年9月前後に国内組織で相次いだ、個人情報等の漏えいにつながる不正アクセスです。既知の脆弱性の探索・悪用やAPI経由の不正操作、BIツール「Metabase」の脆弱性を悪用した攻撃などが報告されています。また、一般利用者向けのサービスだけでなく、BIツールや従業員向け管理システムも被害対象となっています。10月9日の更新では、公開Webサーバーからアクセス可能なアプリケーションサーバーにWebシェルが設置された事案が追加されました。

ただし、公表された事案を一つの原因で説明することはできませんJPCERT/CCは、攻撃に関する技術的な情報の共有が十分でない状況を説明し、把握している情報について「限定的かつ断片的」としています※。

出典:JPCERT/CC「直近で相次いでいる国内組織における不正アクセスに関する注意喚起」(2026年10月8日公開、10月9日更新)(https://www.jpcert.or.jp/at/2026/at260030.html)I. 概要より一部引用。

こうした状況を踏まえ、以降はAPIや業務システムのセキュリティ対策について、企業が確認すべきポイントを解説します。

画面に表示されないAPIも点検が必要

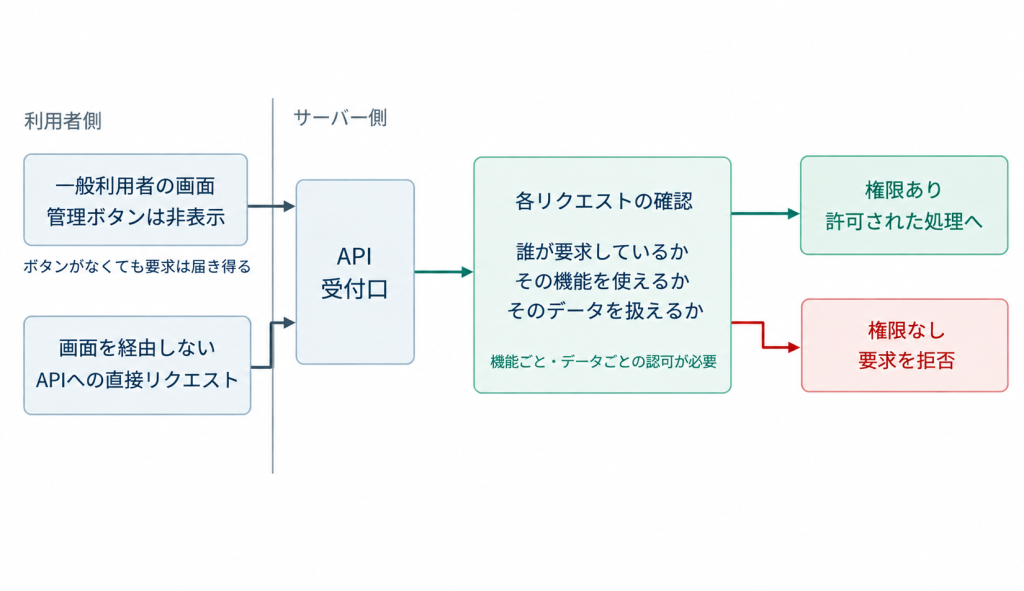
APIは、アプリケーション同士がデータや機能をやり取りするための仕組みです。スマートフォンアプリやWeb画面でボタンを押すと、その裏側でAPIに要求が送られ、サーバーが処理する構成があります。画面の表示と、サーバーが要求を受け付ける条件は、それぞれ確認する必要があります。例えば、一般利用者には管理ボタンを表示しない設計でも、それだけで管理用APIへの要求を防げるわけではありません。要求を受けたサーバーが利用者の権限を確認しなければ、本来許可されていない機能を実行されるおそれがあります。OWASPは、こうした問題を機能レベルの認可の不備として整理しています*2。

認証は利用者が誰かを確認すること、認可はその利用者が何をしてよいかを判断することです。ログイン済みであっても、すべての顧客情報を閲覧してよいとは限りません。同じ閲覧機能でも、自分の契約に属するデータだけを扱えるよう、対象データごとに権限を確認する必要があります。

図:画面の表示制御とAPIの権限確認

画面の表示制御とAPIの権限確認
出典: OWASP「API Security Top 10 2023」(API1:2023、API5:2023)および「REST Security Cheat Sheet」を参考に弊社作成。
注記: 一般的なAPIの認証・認可の仕組みを示した模式図であり、今回の不正アクセス事案を再現したものではありません。

管理用や内部利用を想定したAPIであっても、適切なアクセス制御は欠かせません。OWASPの「REST Security Cheat Sheet」では、非公開のRESTサービスについても、各APIエンドポイントでアクセス制御を実施することを求めています。APIのURLが一般に知られていないことだけを安全性の根拠とせず、アクセス元の制限や利用者の認証・認可を適切に設定する必要があります。

自社で確認すべき6つの点検項目

公開中のシステムとAPIを把握しているか

まず、運用担当者や開発委託先に、現在動いているシステムとAPIの一覧を確認します。サービス名だけでなく、利用目的、管理担当者、接続先、扱うデータ、利用を許可する相手まで整理すると、見直すべき範囲がはっきりします。仕様書と実際の稼働環境に差がないかも確認したいところです。特に確認したいのは、更新前のAPI、試験用の環境、保守用の機能です。OWASPは、管理から漏れた古いAPIや不要な公開環境をリスクとして挙げています*3。本番のAPIを修正しても、同じデータに接続する旧版が動き続けていれば、点検は完了していません。廃止の判断には利用状況を確認し、停止する担当者と日程まで決めておきます。

また、公開Webサーバーから内部のアプリケーションサーバーや管理システムへ、どのような通信が許可されているかも確認します。外部公開していないシステムであっても、公開サーバーを経由して到達できる場合があります。業務上必要な通信に限定されているか、不要な接続経路が残っていないかを点検することが重要です。

利用者ごとの操作権限は適切か

権限の確認では、誰に、どの機能を、どのデータに対して許可するのかを明文化します。例えば「担当者は自分の担当顧客を閲覧できるが、他部署の顧客情報の出力はできない」といった業務上の条件です。一般利用者と管理者の区別に加えて、所属部署や契約先などの境界も整理します。そのうえで、許可された操作が成功することと、許可されていない操作が拒否されることの両方を確認します。機能単位の権限と、データ単位の権限は別々の観点です。実機での確認は、システム所有者と対象範囲を合意し、検証用アカウントやテストデータを用意して進めます。

APIキーやトークンを失効できるか

APIキーやアクセストークンの管理では、発行済みのものを把握できるかに加え、漏えいが疑われた際に失効させられるかを確認します。どのシステムが使い、どこまでの操作を許可し、誰が更新するのかが分からなければ、緊急時の判断が遅れます。OWASPも、秘密情報への最小限の権限付与と、更新・失効・有効期限を含む管理を示しています*4。実務では、鍵の値そのものを点検表に転記せず、識別子と用途、管理先を記録すると扱いやすくなります。更新後に古い認証情報が使えなくなるか、連携先の設定変更が必要かも確かめます。APIキーの所持だけを機密性の高い処理の許可条件とせず、システムの用途や扱う情報に応じて、適切な認証・認可の仕組みを組み合わせることが重要です。

APIの大量実行を制限できるか

操作権限の確認とあわせて、短時間に繰り返される要求への制限も確認します。検索やパスワード再設定など、機能ごとに通常の利用量を把握し、実行回数や一度に返すデータ件数に適切な上限を設けます。OWASPも、業務に応じたレート制限や応答件数の制限を推奨しています*5。ただし、回数を制限しても、権限のない操作が一度でも通る問題は解消しません。認可の点検と並行して進めます。

脆弱性の修正と暫定措置を管理できるか

既知の脆弱性への対応は、利用製品や部品のバージョンを把握することから始まります。開発委託先に確認する場合も、「対応済み」という回答だけで終えず、修正した対象と反映日、残っている課題を共有してもらいます。更新による業務影響が心配な場合は、検証環境で機能を確認したうえで反映します。すぐに更新できなければ、提供元の回避策や機能制限などの適用可否を検討します。OWASPも、修正版の検証と、修正できない場合の暫定的な緩和策を分けて扱っています*6。暫定措置には担当者と見直し期限を設定し、恒久対応まで追跡することを勧めます。

不審な操作をログで追跡できるか

ログの点検では、記録の有無に加えて、利用者と操作内容を結び付けて調べられるかを確認します。認証や権限確認の失敗、権限変更、アカウント作成、データ出力といった操作は、調査に役立つ手掛かりになります。OWASPのログ管理資料でも、これらの記録が取り上げられています*7。例えば、通常と異なる時間帯に大量の出力が行われた場合、操作した主体、対象データ、実行結果を追えるでしょうか。担当者が一件の操作を実際にたどってみると、記録項目や保存先の不足を見つけやすくなります。一方、パスワードやアクセストークンをそのままログに残すと、記録自体が漏えいの原因になり得ます。必要な情報を選び、秘密情報は記録から除外・マスキングする設計が必要です。

点検結果を改善と初動対応につなげる

点検で見つかった問題は、対応する人と完了を確かめる方法まで決めて初めて管理できます。本記事では、点検結果に「対象」「確認できた事実」「業務への影響」「対応担当者」「期限」「再確認の方法」を残す運用を勧めます。判断材料が不足する項目は、問題なしとして閉じず、未確認の内容を明らかにして担当者へ引き継ぎます。例えば、使われていない公開APIが見つかったなら、利用状況を確認して公開を止め、実際に外部から利用できなくなったかを確認します。権限の不備を修正したなら、許可されない操作が拒否されることと、正規の業務が継続できることを再度確かめます。修正作業の完了と、安全性の確認を対応記録の中で結び付けることが大切です。

不正アクセスが疑われる場合の対応

すでに不審な操作が確認されている場合は、予防目的の点検だけでなく、インシデント対応の担当者へ速やかに連絡します。原因調査に必要なログや設定情報などを保全し、証拠を失わないよう注意しながら、被害の拡大を抑える措置を検討します。平時から、夜間や休日の連絡先と、システムの利用停止を判断する責任者を決めておくことも重要です。

脆弱性診断を相談する前に整理しておきたい情報

専門家に相談する際には、対象URLの一覧に加え、API仕様書、利用者の権限区分、重要な業務機能、扱う情報を整理しておくと、確認したい範囲が伝わりやすくなります。顧客向けの画面だけを対象にするのか、管理機能やAPIも含めるのかを、依頼段階で明確にしておきましょう。自社のAPIや管理機能について、どこまでを診断対象に含めるべきか判断が難しい場合は、システムの構成や業務上の権限を共有したうえでご相談ください。運用中のシステムを定期的に点検する機会としては、脆弱性診断を活用できます。


Webアプリケーションの脆弱性を把握し、適切な対策につなげる

ブロードバンドセキュリティ(BBSec)の「Webアプリケーション脆弱性診断」では、Webアプリケーションの脆弱性を診断し、リスクの深刻度と推奨対策をご報告します。管理機能やAPIを含む診断範囲についても、お気軽にご相談ください。

【関連記事】

APIの脅威と対策について知りたい方は、「OWASP API Security Top 10とは?APIの脅威と対策を知ろう」もあわせてご覧ください。

公開範囲と権限を確かめることから始める

今回の注意喚起を自社の対策につなげるには、現在公開しているシステムを把握し、誰がどの情報を扱えるのかを確かめることが出発点になります。まずは主要な業務システムを一つ選び、APIの一覧、権限の設計、操作ログを担当者と確認してみてください。確認できない部分が見つかれば、そこから次の調査や改善につなげられます。

【参考情報】

編集責任:木下

ウェビナー開催のお知らせ

最新情報はこちら

Security NEWS TOPに戻る
バックナンバー TOPに戻る

タイムズカーで約660万アカウントの情報漏洩 ―本人確認書類の保管とWebセキュリティを考える

Share
タイムズカーで約660万アカウントの情報漏洩アイキャッチ画像

2026年9月、タイムズカーのWebシステムが不正アクセスを受け、約660万アカウントの情報漏洩が確認されました。続報では、運転免許証画像などの本人確認書類が漏洩したアカウント数が約160万件と公表されています。本記事では、公式発表をもとに被害の範囲と利用者への案内を整理し、会員情報を扱う企業が見直したいデータ管理とWebセキュリティについて考えます。

※本記事は2026年10月5日時点までで確認できる公表資料に基づき作成しています。

2026年9月にタイムズカーで何が起きたのか

タイムズカーは9月25日9時07分に不正アクセスを検知し、同日の第1報で個人情報漏洩の可能性を発表しました。翌26日7時25分までに侵入経路と攻撃元からの通信を遮断し、遮断後にアクセスできないことを確認したとしています。その後、28日の第2報で第三者による情報取得を確認したと公表し、調査の進展に伴って発表内容を更新しました。公式発表では、具体的な侵入手法や悪用された脆弱性の詳細は示されていません。同社は外部専門機関による原因・影響範囲の調査を進め、再発防止策は続報で公表する方針です。また、サービス提供への影響は確認されず、通常どおり継続していると説明しています。サービスの稼働状況と個人情報への影響は、それぞれ確認する必要があります。

約660万件と約160万件、それぞれの対象範囲

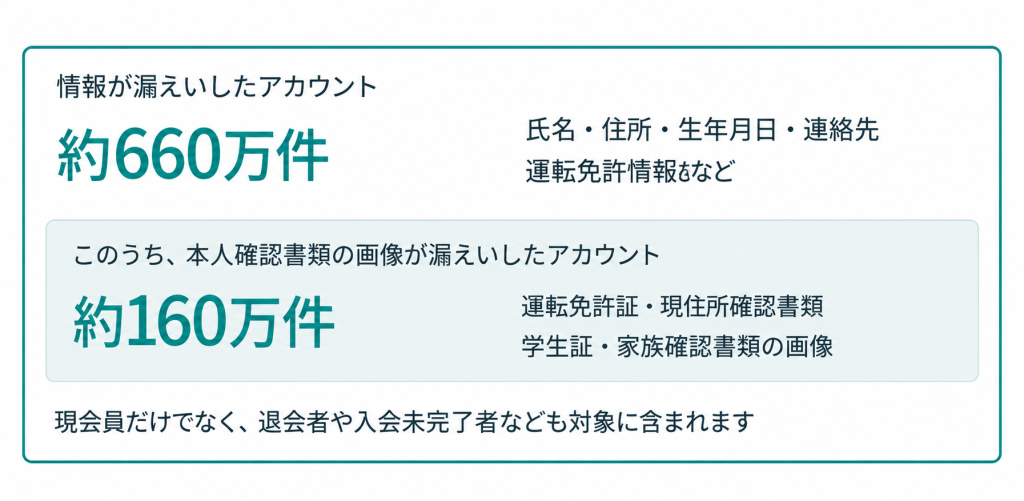
第2報の約660万件は、漏洩したアカウントの数です。対象にはタイムズカーの会員と退会者、入会手続きが完了していない申込者のほか、タイムズビジネスサービスの会員と退会者も含まれます。現在利用している会員だけの人数として受け取らないことが大切です。漏洩した情報の項目については、公式FAQでも詳細が示されています。氏名、住所、生年月日、電話番号、メールアドレスに加え、法人会員の所属部署名、運転免許情報、本人確認書類情報、パスワード、連携サービスIDが挙げられています。一方、クレジットカード情報は保有しておらず、今回の対象には含まれないと説明しています。

9月29日の第3報で示された約160万件は、運転免許証画像などの本人確認書類が漏洩したアカウント数です。書類には現住所確認書類、学生プランの学生証、家族プランの家族確認書類の画像も含まれます。約660万件と約160万件は数えている情報の範囲が異なるため、単純に足して被害規模を示すことはできません。同社はパスワードを復元できない形式で保存していたと説明し、パスワードそのものが第三者に認識できる状態で漏えいした事実は確認していないとしています。不特定多数への情報公開や、本件に起因する不正利用も公表時点では未確認です。これらは同社が示した調査状況として読み、今後の更新も確認する必要があります。

図:タイムズカーで確認された情報漏洩の範囲

タイムズカーで確認された情報漏洩の範囲
出典:タイムズモビリティ株式会社 第2報(2026年9月28日)・第3報(2026年9月29日)をもとに作成
※約160万件は約660万件に含まれます。いずれもアカウント数で、対象となる情報は利用者によって異なります。

利用者は個別通知と公式窓口を確認する

本人確認書類の漏えいが確認された会員への個別メールは9月29日から始まりました。第3報では、詳細について外部専門機関の調査結果を踏まえ、2週間程度を目途に改めて案内する方針を示しています。その後、10月1日にはFAQと退会者向けの問い合わせ案内が追加され、退会者への通知も同日から順次開始されたと説明されています。

同社は、会社を装ったメールやSMS、電話への警戒を求めています。心当たりのない連絡に含まれるリンクや添付ファイルを開かず、パスワード、認証コード、クレジットカード情報を入力しないことが基本です。通知の内容や対象かどうかに疑問がある場合は、公式発表から問い合わせ先を確認してください。同社がメール、SMS、電話でパスワードやカード情報を尋ねることはないと案内しています。

本人確認書類は保有目的とアクセス権限を一緒に見直す

ここからは本件の原因を推定するものではなく、今回の事例を踏まえて、個人情報を扱う企業が確認したい一般的な対策を整理します。本人確認のために受け取る画像についても、会員台帳と同様に、何を、どこで、何のために保有しているかを把握することが出発点になります。退会や申込中断を含む業務の各段階とデータの保管場所を対応させ、取扱責任者や閲覧できる担当者まで確認すると、見直す対象が具体的になります。

10月1日の公式FAQでは、タイムズカーは氏名・住所・生年月日を税法等に基づき7年間、運転免許情報と画像をなりすまし対策や問い合わせ対応のため7年間保管すると説明しています。保有データを点検する際は、このように項目ごとに保管の理由を確認する視点が必要です。退会情報があることだけで、個別企業の保管の適否や漏えい原因を判断することはできません。

一方、個人情報の保存期間について、個人情報保護委員会のFAQでは、個人情報保護法が一律の保存期間や廃棄時期を定めているわけではないと説明しています。そのうえで、利用する必要がなくなった個人データは遅滞なく消去するよう努める必要があるとしています。自社では、保存の根拠と業務上の必要性を確かめ、期限を決めるだけで終わらせず、削除の対象を抽出して処理できる運用になっているか確認したいところです。

保管が必要なデータには、業務に応じたアクセス制御が欠かせません。個人情報保護委員会の通則編ガイドラインも、担当者や取り扱うデータの範囲を限定すること、正当なアクセス権を持つ従業者を識別・認証することを求めています。本人確認担当、問い合わせ担当、システム管理担当で必要な権限を整理し、画像を閲覧・取得できる範囲が過大になっていないか点検することが、企業向けの具体的な確認例になります。

個人情報を扱うWeb機能を継続して点検する

保存ルールや社内権限の確認に加え、利用者からデータへ至る機能も検証する必要があります。会員登録、ログイン、登録情報の変更、書類のアップロードなど、個人情報を扱う処理を洗い出し、どの処理を点検済みか整理します。APIを利用している場合は、その通信や処理も対象に含めます。本件でAPIが悪用されたと確認されたわけではなく、ここで挙げるのは自社システムを点検する際の観点です。

たとえば、本人がログインできることと、その本人に許可された情報だけを閲覧できることは、確認すべき内容が異なります。ログイン時の認証、ログイン状態を維持するセッション、ユーザー権限、重要情報の取り扱いを関連づけて確認することで、画面の通常操作だけでは見えにくい問題の検証につながります。本人確認画像を扱う機能を追加・変更したときにも、その機能を含めて診断範囲を見直すことが考えられます。

点検は新規公開時だけで完了するものではありません。個人情報保護委員会のガイドラインは、システムの設計段階で安全性を確保し、継続して見直すことを対策の例に挙げています。自社の改修予定と診断計画を合わせ、見つかった課題の担当者と修正予定を決め、修正後の確認まで行う運用に結びつけることが重要です。

個人情報の管理とWebの安全性をあわせて見直す

ここまで挙げたWeb側の確認を自社だけで行うことが難しい場合は、外部の脆弱性診断を活用する方法もあります。ブロードバンドセキュリティ(BBSec)では、「Webアプリケーション脆弱性診断」を提供しています。同サービスは、自動診断と技術者による手動診断を組み合わせ、検出した問題の深刻度と推奨対策を報告するサービスです。Webアプリケーションに加え、APIもオプションとして診断できます。会員登録やログイン、登録情報の変更、書類のアップロードなど、個人情報を扱う機能を含め、どこまでを診断対象とするかについてサービスページから相談できます。

個人情報を扱う体制や運用から整理したい企業には、「自己問診型 個人情報に関わる情報セキュリティアセスメント」も用意されています。オンラインの自己問診をもとにコンサルタントが評価し、課題や優先順位、対策案を示すサービスです。データを保有する理由と扱い方を整理する作業を、Web機能の技術的な点検と併せて進めることで、自社で優先すべき改善を具体化できるでしょう。

【参考情報】


個人情報を扱うWebサイトのセキュリティや、情報管理の体制・運用に課題を感じている場合は、現在の対策状況に応じた確認方法をご案内します。まずはお気軽にご相談ください。

編集責任:木下

ウェビナー開催のお知らせ

最新情報はこちら

Security NEWS TOPに戻る
バックナンバー TOPに戻る

イエローハットに不正アクセス、最大約180万人分の個人情報漏えいの可能性―企業が学ぶべき対策とは

Share
イエローハットに不正アクセス、最大約180万人の個人情報漏えいの可能性アイキャッチ画像

2026年8月、カー用品大手のイエローハットが運営する「イエローハットWEB作業予約システム」が不正アクセスを受け、最大約180万人分の個人情報が漏えいした可能性があることが公表されました。本記事では、イエローハットの公式発表をもとに事案の概要を整理するとともに、企業が同様の被害に備えるために見直しておきたいセキュリティ対策について解説します。

※本記事は2026年9月4日時点で確認できる公表資料に基づき作成しています。

イエローハットの不正アクセスで何が起きたのか

株式会社イエローハットは2026年8月28日、「イエローハットWEB作業予約システム」が不正プログラムによる攻撃を受け、一部会員の個人情報が外部へ漏えいした可能性が判明したと発表しました*8。漏えいの可能性がある対象者は最大1,801,499名で、対象情報は氏名、電話番号、メールアドレス、会員番号とされています。同社は8月18日朝に不正アクセスを検知し、直ちにシステムの外部接続を遮断するなどの緊急措置を実施しました。その後、影響範囲などの調査を進める過程で、一部の会員情報が外部へ漏えいした可能性があることが判明したとしています。

公表時点でシステム上の対策は完了しており、個人情報保護委員会への報告と警察への相談も行われました。一方、クレジットカード情報、パスワード、車両情報は当該システムで保持していないため、同社は、これらの情報の漏えいはないと説明しています。また、グループ他社は異なる独自の管理システムを利用しているため、他ブランド店舗の利用者への影響もないとしています。

現時点で原因や侵入経路は公表されていない

今回のイエローハットの不正アクセスについて、攻撃者、侵入経路、悪用された脆弱性、攻撃手法の詳細は、2026年8月28日の公式発表では明らかにされていません。「Webシステムの脆弱性が悪用された」「認証情報が突破された」「ランサムウェアによる攻撃だった」などと原因を推測することはできません。また、公表された1,801,499名は、個人情報の漏えいが確認された人数ではなく、漏えいした可能性がある対象者の最大人数です。同社は今後新たな事実が判明した場合には、ホームページで公表するとしています。

利用者が注意すべき二次被害

イエローハットは、対象となる会員に対し、電子メール、SMS、電話または書面で順次連絡するとしています。同時に、心当たりのないメールやSMSなどに注意し、メールの開封、不審なリンクへのアクセス、添付ファイルの開封を避けるよう呼びかけています。氏名や連絡先、会員番号を組み合わせると、実在する企業やサービスを装った連絡に説得力を持たせやすくなります。ただし、今回の情報が実際にフィッシング等へ悪用されたとの事実は公表されていません。利用者は不安をあおる連絡に反応せず、案内の真偽をイエローハットの公式サイトや公式窓口で確認することが重要です。

2りんかんの不正アクセスとは別事案

イエローハットグループでは、株式会社2りんかんイエローハットも2026年4月に会員専用サーバーへの不正アクセスを公表しています*2。6月19日の最終報では、アプリの仕組みであるAPIを悪用した不正アクセスにより、3,179,454名分の会員データが取得されたことが特定されました。

ただし、2りんかんの事案と今回のイエローハット本体の事案を同じ原因によるものとみなすことはできません。今回対象となった「WEB作業予約システム」はグループ他社とは異なる独自管理システムであり、攻撃者や原因の共通性も公表されていません。企業が注目すべきなのは、二つの事案を安易に結び付けることではなく、グループ内でインシデントが発生した際に、類似する公開システムや利用技術、委託先などに同様のリスクがないか横断的に点検することです。

Web予約システムがサイバー攻撃の対象になり得る理由

Web予約システムは、顧客がインターネットから利用できる利便性の高い窓口である一方、外部に常時公開されるシステムでもあります。予約受付だけでなく、会員情報との連携、通知、店舗側の管理機能など、複数のシステムや機能とつながっているケースもあります。また、氏名や電話番号、メールアドレスなどの個人情報を扱うことも多いため、不正アクセスを受けた場合には情報漏えいにつながる可能性があります。そのため、公開前のセキュリティ確認だけでなく、運用開始後も継続的にリスクを管理することが重要です。

企業が見直すべき5つのセキュリティ対策

公開しているIT資産を把握し、管理責任を明確にする

最初に必要なのは、自社とグループ会社がインターネット上に公開しているWebサイト、予約システム、API、クラウド環境などを洗い出すことです。古いキャンペーンサイトや管理部門が不明確なシステムが残っていれば、脆弱性情報の確認や修正が遅れる原因になります。資産ごとに管理責任者、使用技術、保守委託先、個人データの有無を整理し、不要な公開資産は閉鎖する必要があります。

WebアプリケーションとAPIを継続的に点検する

Webシステムは公開前に確認して終わりではありません。機能追加、設定変更、ミドルウェアやライブラリの更新によってリスクは変化します。IPAは、Webサイトの新規公開前や既存ページの変更時の確認に加え、構成するソフトウェアやCMSを把握し、最新状態を保つことを推奨しています。システムの重要度や変更頻度に応じて、定期的な脆弱性診断やセキュリティ点検を実施することが有効です。

ログを『保存するだけ』にせず、検知と調査に使える状態にする

不正アクセスを早期に捉え、発生後に原因や影響範囲を調べるには、アクセスログや認証ログなどが欠かせません。ただし、ログが分散したまま、確認する担当者やルールが決まっていなければ、異常の発見につながりません。監視対象、検知条件、通知先、保管期間、時刻同期、改ざん防止を定め、異常を検知した際に調査へ移れる運用を整備することが重要です。

保有する個人データを最小化し、アクセスを必要な範囲に絞る

攻撃を完全に防ぐことは困難ですが、侵害された場合の影響を抑えることはできます。予約や会員サービスに本当に必要なデータだけを取得し、保存期限を過ぎた情報を削除し、業務上必要な担当者だけがアクセスできるようにします。決済情報を外部の専用システムで扱うなど、重要な情報を分離する設計も被害範囲を限定するうえで有効です。なお、これは一般的な推奨策であり、今回の事案に過剰保有やアクセス制御の不備があったことを示すものではありません。

インシデント対応手順を整え、グループ横断で訓練する

不正アクセスを検知した直後は、遮断、証拠保全、影響範囲の特定、経営層への報告、外部専門家や関係機関との連携、顧客への説明を並行して進めなければなりません。平時から責任者と連絡網を決め、初動手順を文書化し、机上演習で判断の遅れや役割の抜けを確認しておくことが重要です。グループ企業で事案が発生した場合は、当該システムの復旧だけで終わらせず、他社・他サービスへ横展開して点検する仕組みも必要です。

公開システムのセキュリティ対策を見直すには

Web予約システムのセキュリティ対策では、脆弱性を見つけて修正する予防策、攻撃の兆候を早期に捉える監視、被害が疑われた際の初動対応を分断しないことが重要です。どれか一つを導入するだけでは、継続的に変化する公開システムのリスクには対応しきれません。

BBSecでは、公開システムの脆弱性診断から、セキュリティログの分析・監視、インシデント発生時の緊急対応・フォレンジック調査までと、「予防」・「検知」・「対応」の各段階を支援しています。自社やグループ会社の公開システムをどこから見直すべきか判断に迷う場合は、現在の対策状況を整理したうえで、各段階での不足部分を補うことが有効です。

まとめ

イエローハットの不正アクセスでは、WEB作業予約システムに保存されていた最大約180万人分の個人情報が漏えいした可能性が公表されました。現時点では侵入経路や具体的な攻撃手法は明らかにされていないため、今後の調査結果や追加発表を確認する必要があります。企業にとって重要なのは、こうした事案を一過性のニュースとして捉えるのではなく、自社の対策を見直す機会とすることです。公開IT資産の把握、WebアプリケーションやAPIの継続的な点検、ログ監視、個人データの適切な管理、インシデント対応体制の整備を一連の取り組みとして進めることが、被害の予防と早期収束につながります。

【参考情報】

編集責任:木下


BBSecの脆弱性診断・セキュリティ対策支援サービス

BBSec(ブロードバンドセキュリティ)では、WebアプリケーションやAPIの脆弱性診断をはじめ、セキュリティログの分析・監視、インシデント発生時の緊急対応・フォレンジック調査など、予防・検知・対応の各段階を支援しています。公開システムのセキュリティ対策や、情報漏えい・不正アクセスへの備えを見直したい場合は、お気軽にご相談ください。


ウェビナー開催のお知らせ

最新情報はこちら

Security Serviceへのリンクバナー画像
BBsecコーポレートサイトへのリンクバナー画像
セキュリティ緊急対応のバナー画像

Security NEWS TOPに戻る
バックナンバー TOPに戻る

DDoS攻撃を受けたらどうする?―初動対応から復旧までの流れを解説―

Share
DDoS攻撃を受けたらどうする?アイキャッチ画像

DDoS攻撃では、事前の対策だけでなく、攻撃を受けた際の迅速な初動対応が重要です。対応が遅れると、サービス停止だけでなく、売上機会の損失や顧客対応の混乱につながるおそれがあります。本記事では、DDoS攻撃を受けた場合の初動対応から、ISP・クラウド事業者との連携、復旧、再発防止までの流れを解説します。

DDoS攻撃の基本的な仕組みや種類、被害、対策については、「DDoS攻撃とは?仕組み・被害・対策を企業向けに解説」もあわせてご覧ください。

DDoS攻撃を受けたときに想定される影響

DDoS攻撃を受けると、大量の通信やリクエストによってWebサイトやサービスの応答が遅延し、場合によっては利用できなくなります。影響はサービス停止だけでなく、決済・予約・受発注などの業務停止、顧客・取引先からの問い合わせ増加などにも及ぶ可能性があります。

また、DDoS攻撃による混乱に乗じて、不正アクセスや情報窃取など別の攻撃が行われる可能性も考慮する必要があります。そのため、単なる通信障害と判断せず、セキュリティインシデントとして状況を確認することが重要です。DoS攻撃が単一または少数の攻撃元から行われるのに対し、DDoS攻撃は多数の端末などを悪用して分散的に行われるため、攻撃元の特定や単純な遮断が難しくなります。

DoS攻撃とDDoS攻撃の仕組みや違いについて詳しくは、「DoS攻撃とDDoS攻撃の違いとは 仕組み・被害・対策を比較解説」をご覧ください。

DDoS攻撃を受けたときの対応の流れ

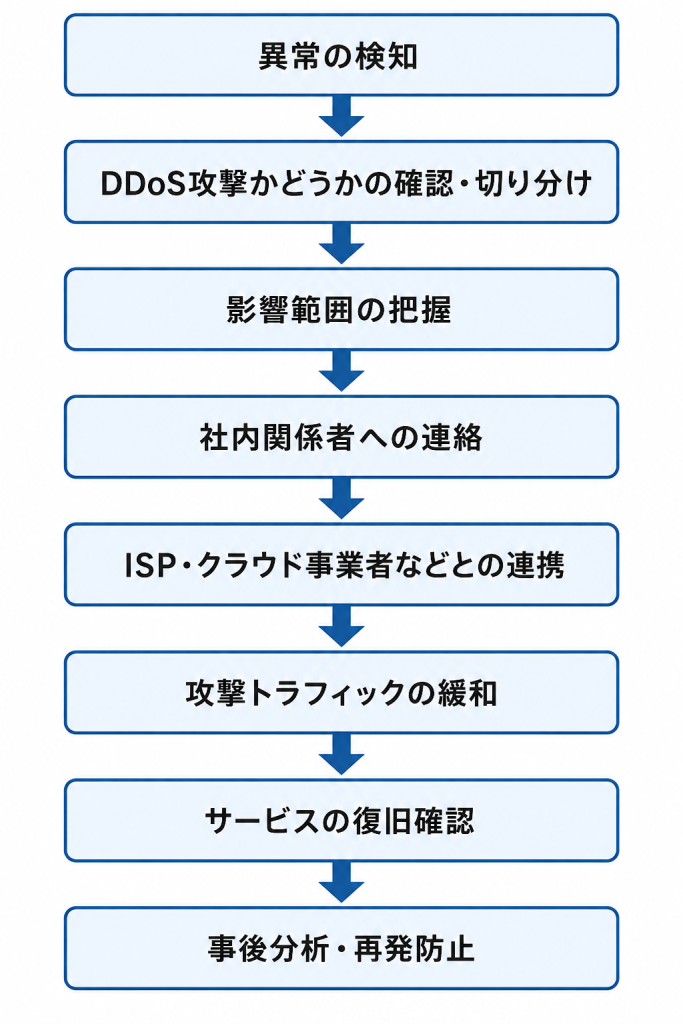
DDoS攻撃が疑われる場合、場当たり的に設定変更や機器の再起動を行うのではなく、状況を確認しながら段階的に対応することが重要です。基本的な流れは、次のとおりです。

実際の対応方法は、攻撃の種類や規模、システム構成、利用しているクラウド・ネットワークサービスなどによって異なります。重要なのは、技術担当者だけで対応を完結させようとせず、必要に応じて社内外の関係者と連携できる体制を整えることです。

初動対応で最初に行うべきこと

DDoS攻撃を受けた場合、最初に必要なのは、慌てて機器の再起動や設定変更を行うことではありません。まず、発生している事象がDDoS攻撃によるものなのか、通常のアクセス増加やシステム障害なのかを切り分ける必要があります。初初動対応では、攻撃の有無を確認し、被害範囲を把握し、関係者へ連絡するとともに、可能な範囲でログなどの証跡を保全します。

攻撃発生を確認する

最初に、どのような異常が発生しているかを確認します。Webサイトの応答遅延、タイムアウト、サーバーエラー、CPUやメモリ使用率の急上昇、ネットワーク帯域の逼迫、特定URLへのリクエスト集中などが確認ポイントになります。

アクセス解析、サーバーログ、WAFログ、ロードバランサーのメトリクス、クラウド監視サービス、ネットワーク機器のトラフィック情報を確認し、通常時と比べて異常な増加がないかを調べます。平時のトラフィック量やピーク時の傾向を把握していれば、DDoS攻撃なのか、キャンペーンやニュース掲載などによる正規アクセスの増加なのかを判断しやすくなります。

ただし、DDoS攻撃は必ずしも大量通信だけとは限りません。アプリケーション層を狙う攻撃では、一見すると通常のHTTPリクエストに見える通信が集中し、検索機能、ログイン画面、APIなど特定の処理に負荷がかかることがあります。そのため、通信量だけでなく、アクセス先、リクエスト頻度、送信元の分布、レスポンスコードの変化なども確認します。

被害範囲を把握する

次に、どのサービスが影響を受けているかを把握します。コーポレートサイトだけなのか、ECサイトや会員サイトも影響を受けているのか、社内ネットワークや業務システムにも影響があるのかを整理します。被害範囲を確認する際は、外部からの疎通確認だけでなく、社内からの接続状況、監視アラート、問い合わせ件数、取引先からの連絡内容なども確認します。攻撃対象が特定のドメイン、IPアドレス、ポート、URL、APIなどに集中していることがわかれば、後続のトラフィック制御やCDN・WAF設定の調整にも役立ちます。

また、DDoS攻撃による負荷によってログ出力や監視自体が遅延している可能性もあります。一つの監視画面だけで判断せず、複数の情報源を突き合わせて状況を確認することが重要です。

関係者へ連絡する

DDoS攻撃の可能性がある場合は、社内の関係者へ速やかに連絡します。情報システム部門、セキュリティ担当、ネットワーク担当、Webサイト運用担当、カスタマーサポート、広報、法務、経営層など、影響範囲に応じて必要な関係者へ情報を共有します。サービス停止が顧客や取引先に影響する場合は、技術的な復旧だけでなく、問い合わせ対応や外部への説明も必要になります。復旧の見通しが立っていない段階でも、「現在確認している事象」「影響を受けているサービス」「現在実施している対応」などを社内で共有しておくことで、対応の混乱を抑えられます。あわせて、契約しているISP、クラウド事業者、CDN、WAF、セキュリティ監視サービス、運用保守ベンダーへの連絡準備も進めます。

ログを保全する

DDoS攻撃への対応では、復旧作業と並行して、可能な範囲でログなどの証跡を保全することも重要です。負荷軽減を優先する過程で設定を変更したり、ログローテーションによって過去のログが上書きされたりすると、後から攻撃状況を確認できなくなる可能性があります。保全対象としては、Webサーバーログ、WAFログ、ロードバランサーログ、DNSログ、ファイアウォールログ、クラウド監視メトリクス、ネットワーク機器のトラフィック情報、アラート履歴などが考えられます。

これらの情報は、攻撃の種類や影響範囲を分析するだけでなく、DDoS攻撃の前後に不正アクセスなど別の事象が発生していなかったかを確認する際にも役立ちます。

ISP・クラウド事業者と連携する

DDoS攻撃への対応では、自社だけで完結しようとしないことが重要です。攻撃トラフィックが自社回線に到達してから遮断しようとしても、すでに回線帯域が逼迫していれば、正規利用者の通信も届かなくなる可能性があります。そのため、攻撃の種類や規模に応じて、ISP、クラウド事業者、CDN、DDoS対策サービスなどと連携し、上流側でトラフィックを制御することが重要になります。

ISPへの連絡

オンプレミス環境や自社回線でサービスを公開している場合、ISPへの連絡が必要になることがあります。自社のファイアウォールで遮断する前に回線が逼迫している場合には、上流側でのフィルタリングや経路制御などの対応が必要になる可能性があるためです。

ISPへ連絡する際は、攻撃を受けているグローバルIPアドレス、影響を受けているサービス、発生時刻、観測している通信量、主なプロトコルやポート、送信元の傾向、現在発生している障害内容を整理して伝えます。また、契約内容によっては、DDoS緩和サービスや緊急時のトラフィック制御オプションが提供されている場合があります。攻撃が発生してから確認するのではなく、平時から連絡窓口、受付時間、必要情報、対応範囲などを把握しておくことが望まれます。

CDN・WAFの活用

WebサイトやWebアプリケーションを公開している場合、CDNやWAFを活用して攻撃トラフィックを緩和できる場合があります。CDNはアクセスを分散し、オリジンサーバーへの負荷を軽減するために利用できます。WAFでは、HTTPリクエストの特徴やアクセス頻度などに応じて、不審なアクセスを制御することが可能です。ただし、CDNやWAFを導入しているだけで、すべてのDDoS攻撃を防げるわけではありません。DNSが適切にCDN経由になっているか、オリジンサーバーへ直接アクセスできる状態になっていないか、必要な防御機能が有効になっているかなどを確認する必要があります。

攻撃中にアクセス制御を強化する場合は、正規利用者まで遮断してしまう可能性にも注意が必要です。ログやトラフィックの状況を確認しながら、段階的に調整します。

クラウド事業者との連携

クラウド環境でサービスを運用している場合は、利用しているクラウド事業者が提供するDDoS対策機能やサポートサービスを確認します。主要なクラウド事業者では、ネットワークレベルのDDoS対策機能や、契約内容に応じたサポートが提供されています。攻撃発生時に支援を受けられるよう、対象リソース、攻撃状況、アプリケーションの正常性、WAFやロードバランサーのログなどを共有できる状態にしておくことが重要です。また、クラウド環境ではスケールアウトによって一時的に処理能力を増やせる場合がありますが、攻撃トラフィックに応じてリソースを増やし続ければ、利用料金が増大する可能性があります。CDN、WAF、ロードバランサー、オートスケーリング、DDoS対策機能などを組み合わせて対応することが重要です。

復旧時に確認すべきポイント

DDoS攻撃の通信量が減少し、Webサイトやサービスが再び利用できるようになっても、すぐに「復旧完了」と判断するのは危険です。攻撃が一時的に弱まっている可能性や、緊急対応として行った設定変更がサービスに影響している可能性があります。また、DDoS攻撃と同時に別の攻撃が行われていなかったかも確認する必要があります。

サービスが正常に利用できるか

Webサイトへアクセスできることだけでなく、ログイン、検索、決済、予約、API連携など、主要な機能が正常に動作しているかを確認します。サーバーやネットワーク機器のCPU・メモリ・帯域使用率、エラー発生状況なども確認し、通常時に近い状態へ戻っているかを確認します。また、攻撃が再開する可能性も考慮し、一定期間はトラフィックやアラートを継続して監視することが重要です。

二次被害が発生していないか

DDoS攻撃への対応中は、大量のアラートやサービス障害への対応に注意が集中します。そのため、同じ時間帯に不審なログインや脆弱性を狙ったアクセスなど、別の不審な事象が発生していなかったかを確認します。WAF、認証、サーバー、ネットワーク機器、EDRなどのログを確認し、通常とは異なる挙動が確認された場合は、必要に応じて追加調査を行います。

一時的に変更した設定がないか

DDoS攻撃への緊急対応として、IPアドレスや地域によるアクセス制限、WAFルールの変更、レート制限などを実施することがあります。こうした設定を残したままにすると、正規利用者のアクセスや業務に影響する可能性があります。攻撃収束後は、変更した設定とその目的を確認し、継続すべき設定と元に戻す設定を整理します。

顧客や取引先への説明

サービス停止などによって顧客や取引先に影響が発生した場合は、必要に応じて障害の発生時刻、影響範囲、復旧状況などを説明します。この段階では、確認できていない原因や被害を断定しないことも重要です。技術部門だけで判断せず、広報、法務、顧客対応部門などと連携して説明内容を整理します。

再発防止に向けて見直すべきこと

サービスを復旧させた後は、今回の攻撃と対応内容を振り返り、次の攻撃に備えます。DDoS攻撃を完全に防ぐことは難しいため、「攻撃を受けないこと」だけではなく、「受けても影響を抑え、早期に復旧できること」が重要です。

攻撃ログやトラフィックの分析

保全したログやトラフィック情報を確認し、攻撃がいつ始まり、どのサービスが狙われ、どのような通信が発生していたのかを整理します。あわせて、検知から関係者への連絡、緩和策の実施、サービス復旧までにどの程度の時間を要したかを振り返ることで、対応上の課題を把握できます。

ネットワーク構成の見直し

まず見直すべきは、ネットワーク構成です。公開サービスが単一の回線や単一拠点に依存していないか、CDNやAnycastを活用できる構成になっているか、オリジンサーバーが直接攻撃を受けやすい状態になっていないかを確認します。また、Webサイト、API、管理画面、社内業務システムなどが同じネットワークに過度に依存している場合、一つの攻撃による影響が複数のサービスや業務へ波及する可能性があります。公開系と管理系の分離や、DNS構成なども含め、攻撃を受けた際に影響が広がりにくい構成になっているかを確認することが重要です。

DDoS攻撃では、回線帯域、ネットワーク機器、DNS、Webアプリケーション、APIなど、攻撃の種類によって影響を受ける箇所が異なります。今回の攻撃でどこがボトルネックになったのかを確認し、その結果をネットワーク構成の見直しに反映することが、次の攻撃による影響を抑えることにつながります。

DDoS対策サービスの導入・見直し

次に、DDoS対策サービスの導入や見直しを検討します。CDN、WAF、DDoSスクラビング、クラウド事業者のDDoS保護機能、ISPのDDoS緩和サービスなど、選択肢は複数あります。重要なのは、自社のサービス特性に合った対策を選ぶことです。静的コンテンツが多いサイトであればCDNによるキャッシュが有効な場合があります。ログインや検索、予約、決済など動的処理が多いサービスでは、WAFやレート制限、アプリケーション層の監視が重要になります。大規模な帯域攻撃が想定される場合は、上流側でのDDoS緩和やスクラビングを検討する必要があります。

また、対策サービスは導入して終わりではありません。緊急時の連絡窓口、対応開始条件、保護対象のIPアドレスやドメイン、ログの取得方法、誤検知時の解除手順、費用条件を事前に確認しておく必要があります。攻撃発生時に初めて管理画面を開く状態では、十分な対応ができないおそれがあります。

DDoS攻撃に備えて平時から準備しておくこと

DDoS攻撃が発生してから対策や連絡体制を検討していては、初動が遅れるおそれがあります。攻撃による影響を抑え、迅速に対応・復旧するためには、ネットワーク構成やDDoS対策サービス、インシデント対応手順などを平時から確認し、実際の攻撃を想定した訓練を行っておくことが重要です。

インシデント対応手順の見直し

対応手順には、攻撃発生時の確認項目、社内連絡先、外部事業者の連絡先、判断権限、ログ保全方法、顧客告知の流れ、復旧判断基準を含めます。特にDDoS攻撃では、技術部門だけでなく、カスタマーサポート、広報、営業、法務、経営層との連携が必要になるため、役割分担を明確にしておくことが重要です。

また、インシデント対応手順は一度作成しただけでは十分ではありません。サービス構成の変更、クラウドへの移行、新しいWAFやCDNの導入、担当者の異動、外部ベンダーの変更などがあれば、それにあわせて手順も更新する必要があります。古い連絡先や現在は利用していないシステム名などが残っていないか、定期的に確認しておきましょう。

DDoS攻撃を含むセキュリティインシデントでは、事前に対応手順を整備しておくことが重要です。関連記事「セキュリティインシデントとは?基礎知識と代表的な事例を解説」もあわせてご覧ください。

訓練の実施

DDoS攻撃への対応力を高めるには、訓練の実施が有効です。実際の攻撃時には、監視アラート、問い合わせ、社内報告、外部事業者との連絡が同時に発生します。手順書を読むだけでは、こうした混乱の中で適切に動けるかは分かりません。

訓練では、「Webサイトの応答が急激に悪化した」「特定APIに大量アクセスが集中している」「ISPから異常トラフィックの連絡があった」など、具体的なシナリオを用意します。そのうえで、誰が最初に状況を確認するのか、どの情報を集めるのか、誰がISPやクラウド事業者へ連絡するのか、どの段階で顧客告知を検討するのかを確認します。

訓練後は、手順の不備や連絡体制の弱点を洗い出し、改善します。DDoS攻撃の対応では、攻撃を完全に止めることだけでなく、被害を限定し、事業への影響を抑え、利用者に適切に説明することが重要です。そのためには、平時からの準備と訓練が欠かせません。

まとめ

DDoS攻撃を受けた場合は、単にサーバーを復旧させるだけでなく、攻撃状況の確認、影響範囲の把握、関係者への連絡、ISP・クラウド事業者などとの連携を並行して進める必要があります。また、通信量が減少したからといって、すぐに対応を終了するのではなく、サービスが正常に利用できることや、DDoS攻撃の前後に別の不審な事象が発生していないことを確認することも重要です。

DDoS攻撃を完全に防ぐことは困難ですが、平時から連絡体制やログ取得、外部事業者との連携方法を整理しておくことで、攻撃発生時の混乱を抑え、サービスへの影響を最小限にすることができます。

【参考情報】

編集責任:木下


資料ダウンロードボタン
年二回発行されるセキュリティトレンドの詳細レポート。BBSecで行われた診断の統計データも掲載。
お問い合わせボタン
サービスに関する疑問や質問はこちらからお気軽にお問合せください。

Security Serviceへのリンクバナー画像
BBsecコーポレートサイトへのリンクバナー画像
セキュリティ緊急対応のバナー画像

Security NEWS TOPに戻る
バックナンバー TOPに戻る

見落としがちなIT資産がセキュリティ事故を招く?企業で起こりやすい5つの管理課題

Share
「見落としがちなIT資産管理の課題5選」アイキャッチ画像

前回記事では、IT資産管理の基本と重要性を解説しました。管理されていない端末やクラウド環境、シャドーIT、サポート終了製品など、見落とされたIT資産が被害につながるケースも少なくありません。今回は、管理が行き届かない場合に実際どのような問題が起こりやすいのか、企業で起こりやすい5つの管理課題を具体的に見ていきます。

IT資産管理の基本について知りたい方は、まず「IT資産管理とは」をご覧ください。
「IT資産管理とは?企業のセキュリティ対策で最初に取り組むべき理由を解説」

セキュリティ事故は、必ずしも高度な攻撃だけで起こるわけではありません。実際には、管理されていない端末、放置されたクラウド環境、退職者のアカウント、サポート終了ソフトウェアなど、見落としがちなIT資産がきっかけになることがあります。IT資産管理が不十分な状態では、脆弱性情報が公開されても対象資産を特定できず、インシデント発生時にも影響範囲をすばやく把握できません。

なぜ管理漏れが起こるのか

IT資産の管理漏れは、担当者の怠慢だけで起こるものではありません。むしろ、事業スピードに管理体制が追いつかないことで発生します。新しいSaaSを部門単位で契約する、検証用にクラウド環境を作成する、テレワーク用に端末を追加する、業務委託先にアカウントを付与する。こうした日常的な業務の中で、台帳更新や承認プロセスが後回しになると、実態とのズレが広がっていきます。

企業で起こりやすい5つの管理課題

台帳が更新されない

IT資産管理で最も起こりやすい課題は、資産台帳が更新されないことです。導入時には正確だった台帳も、ソフトウェア更新やクラウド環境の追加が反映されなければ、すぐに実態とずれていきます。特にExcelやGoogleスプレッドシートで管理している場合、更新担当者が限られ、現場の変更が反映されないまま時間が経過しがちです。その結果、台帳上は存在するのに実際には廃棄済みの機器、逆に台帳にはないが稼働している資産が発生します。インシデント対応時にこの状態だと、影響範囲の特定に時間がかかり、初動対応の遅れにつながります。

シャドーITが増える

シャドーITとは、情報システム部門や管理部門が把握していないIT資産やサービスが、業務目的で利用されている状態を指します。英国のサイバーセキュリティ機関NCSCでは、「シャドーITは悪意によって生まれるとは限らず、従業員が業務を進めるために、承認済みのツールやプロセスでは対応できない課題を解決しようとして発生することが多い」と説明しています。たとえば、ファイル共有が不便だから個人用クラウドストレージを使う、社内承認に時間がかかるため部門でSaaSを契約する、開発検証のために個人名義に近い形でクラウド環境を作る、といった行動です。本人に悪意がなくても、会社のセキュリティポリシー、バックアップ、アクセス制御、監査ログ、退職時のアカウント削除の対象外になるため、情報漏洩や不正アクセスのリスクが高まります。シャドーIT対策で重要なのは、単に禁止することではありません。なぜ現場が非公式な手段を使わざるを得なかったのかを把握し、業務に必要なツールを安全に使える仕組みに変えることです。

クラウド資産が把握できない

クラウド環境では、サーバやストレージ、データベース、コンテナ、API、アカウント、権限設定などが短時間で作成・変更・削除されます。オンプレミス環境のように物理的なサーバーが目に見えるわけではないため、管理対象から漏れやすいのが特徴です。検証用に作ったクラウド環境が放置され、インターネットに公開されたままになる。開発者が一時的に広い権限を付与し、その後も戻されない。ログ設定やバックアップ設定が本番環境と異なる。こうした状態は、クラウド利用が進む企業ほど起こりやすくなります。米国サイバーセキュリティ・インフラストラクチャセキュリティ庁(CISA)の「Cybersecurity Performance Goals」でも、既知の資産だけでなく、未知の資産、シャドー資産、未管理資産を特定し、新たな脆弱性への検知・対応を速めることが目的として示されています。

EOL(End of Life)・EOS(End of Service)を見逃す

サポートが終了したOS、ネットワーク機器、VPN機器、業務アプリケーション、ミドルウェアを使い続けることも、IT資産管理上の大きな課題です。サポートが終了した製品は、脆弱性が発見されても修正プログラムが提供されない可能性があります。資産台帳にサポート期限や保守期限が記録されていなければ、更新計画を立てることもできません。

EOL・EOSについては前回記事でも触れていますので、あわせてご覧ください。

また、ソフトウェア資産の構成管理まで行いたい場合、EOL・EOS対策の延長としてSBOM(ソフトウェア部品表)も重要になります。経済産業省「ソフトウェア管理に向けたSBOMの導入に関する手引 Ver.2.0」では、資産管理台帳だけでは、下位コンポーネントとして利用されるOSSなどに脆弱性が見つかった場合に、間接的な影響を検知できない場合があると説明されています。

SBOMについては、「SBOMとは?ソフトウェア部品表の基本と企業が導入すべき理由」でも解説しています。あわせてご覧ください。

部門ごとに管理している

IT資産管理が部門ごとに分断されていることも、企業でよく見られる課題です。情報システム部門はPCとネットワーク機器を管理し、開発部門はクラウド環境を管理し、総務部門はリース契約を管理し、各事業部がSaaS契約を管理している。このような状態では、全社としてどのIT資産が存在するのかを把握できません。部門ごとの管理は、現場のスピードを保つうえでは便利です。しかし、セキュリティ事故が起きたときには、誰が責任者なのか、どの情報が保存されているのか、どの範囲に影響があるのかが分からなくなります。特に、SaaSやクラウドサービスでは、管理者権限を持つ担当者が異動・退職した後に、契約やアカウントだけが残り続けるケースもあります。

管理課題を解決するポイント

IT資産管理の課題を解決するには、台帳を作るだけでは不十分です。重要なのは、資産が増える、変わる、使われなくなるタイミングで、台帳や管理システムが自然に更新される運用を作ることです。まず、IT資産管理の対象範囲を明確にします。PCやサーバだけでなく、クラウド環境、SaaS、アカウント、ネットワーク機器、ソフトウェア、ライセンスまで含めるかを決めます。次に、資産ごとに管理責任者を定めます。所有者が曖昧な資産は、脆弱性対応や費用管理、廃棄判断が遅れやすくなります。そのうえで、購買、入社、異動、退職、クラウド作成、SaaS契約、機器廃棄といった業務フローにIT資産管理を組み込みます。ツールを導入する場合も、単体で完結させるのではなく、ID管理、EDR、MDM、脆弱性管理、クラウド管理と連携させることで、実態に近い情報を保ちやすくなります。

課題を解決する具体的な運用方法については「IT資産管理を効率化する方法とは?担当者が押さえたい運用のポイント」をご覧ください。

まとめ:見えていないIT資産は、守れない

IT資産管理の課題は、すぐに大きな障害として表面化するとは限りません。しかし、管理漏れ、シャドーIT、クラウド資産の放置、サポートが終了した製品・機器の見逃し、部門ごとの分断が積み重なると、セキュリティ事故の温床になります。

次回は、こうした課題を解決するための具体的な運用方法について解説します。

【参考情報】

編集責任:木下


公開IT資産を可視化してみませんか?

社内で管理しているIT資産と、インターネット上から見える資産は必ずしも一致しません。攻撃者視点で公開資産を可視化する「アタックサーフェス調査サービス」をご紹介します。

BBSecのアタックサーフェス調査サービス

インターネット上で「攻撃者にとって対象組織はどう見えているか」調査・報告するサービスです。攻撃者と同じ観点に立ち、企業ドメイン情報をはじめとする、公開情報(OSINT)を利用して攻撃可能なポイントの有無を、弊社セキュリティエンジニアが調査いたします。


Security Serviceへのリンクバナー画像
BBsecコーポレートサイトへのリンクバナー画像
セキュリティ緊急対応のバナー画像

Security NEWS TOPに戻る
バックナンバー TOPに戻る

脆弱性管理とは?企業が行うべき脆弱性管理の基本と実践手順【2026年版】

Share
「脆弱性管理とは?企業が行うべき脆弱性管理の基本と実践手順」アイキャッチ画像

企業のIT環境は、もはや社内サーバーやネットワーク機器だけで完結しません。業務システムはクラウドへ移行し、開発現場ではOSSの利用が当たり前になり、SaaSやコンテナ、API連携を含めた複雑な構成が一般化しています。こうした環境では、ひとつの脆弱性が単独の問題にとどまらず、情報漏えい、業務停止、サプライチェーン全体への影響へとつながることがあります。だからこそ今、多くの企業にとって重要になっているのが「脆弱性管理」です。

脆弱性管理とは、脆弱性を見つけることそのものではありません。自社にどの資産があり、どこに弱点があり、それがどの程度危険で、いつまでに何を直すべきかを継続的に判断し、実際に改善し続ける運用を指します。本記事では、脆弱性管理の基本から、企業が実務で押さえるべき流れ、ツールの考え方、クラウドやOSS時代に欠かせないSBOMの活用まで、2026年時点の実務に沿って整理します。

脆弱性管理とは

脆弱性管理とは、システムやソフトウェア、クラウド環境、ネットワーク機器などに存在するセキュリティ上の弱点を継続的に把握し、評価し、修正し、再確認する一連の運用です。単発の診断や一度きりの点検ではなく、変化し続けるIT環境に合わせて回し続けることに意味があります。CISAも、脆弱性管理を「脆弱性や悪用可能な状態の発生頻度と影響を減らす取り組み」と位置づけています。

脆弱性管理では、日々公開される脆弱性情報を継続的に確認することが重要です。多くの脆弱性は CVE(Common Vulnerabilities and Exposures) という識別番号で管理されています。CVEの仕組みについては、以下の記事で詳しく解説しています。
「CVEとは?脆弱性情報の共通識別番号を解説」

CVEは、公開されたサイバーセキュリティ上の脆弱性を識別し、共通の参照先として扱うための仕組みです。一方、NVDはそのCVE情報に対してCVSSなどの評価情報や関連データを付与し、脆弱性管理の自動化や優先順位付けに役立つデータベースとして機能しています。つまり実務では、「CVEで対象を識別し、NVDやベンダー情報で内容と深刻度を確認する」という流れが基本になります。

現在の企業システムは、オンプレミス環境だけでなく、AWS・Azure・Google Cloud などのクラウド環境やSaaSサービスを組み合わせて構築されるケースが増えています。そのため、脆弱性管理はサーバーやネットワークだけでなく、クラウド環境やソフトウェアコンポーネントも含めて実施する必要があります。クラウドでは、基盤の一部は事業者が管理していても、設定、アクセス権、ゲストOS、コンテナイメージ、アプリケーションなどは利用企業側の責任範囲に残るためです。AWS、Microsoft、Google Cloudはいずれも共有責任モデルを明示しており、利用者側の継続的な管理を前提にしています。

なぜ企業に脆弱性管理が必要なのか

企業に脆弱性管理が必要な最大の理由は、脆弱性が「見つかっただけの情報」ではなく、「実際に悪用される入口」になっているからです。公開された脆弱性のすべてが直ちに攻撃に使われるわけではありませんが、CISAは実際に悪用が確認された脆弱性を Known Exploited Vulnerabilities(KEV) Catalog として公開し、組織に優先対応を促しています。つまり現代の脆弱性管理では、公開情報を眺めるだけでなく、「いま悪用されているか」「自社に影響するか」を見極めることが重要です。

脆弱性を放置するリスクも明確です。攻撃者は、修正が遅れたVPN機器、公開サーバー、業務アプリケーション、ミドルウェア、コンテナ環境などを足がかりに侵入し、そこから権限昇格や横展開を進めます。問題は、重大な脆弱性があっても、自社資産を把握できていなければ「影響を受けているのに気づけない」ことです。脆弱性管理は、修正作業の前段として、自社に何が存在しているかを見える化する意味でも不可欠です。

さらに、近年はOSS利用の拡大によって、ソフトウェアサプライチェーン全体のリスク管理が重要になっています。NTIAはSBOMを、ソフトウェアを構成する各種コンポーネントとそのサプライチェーン上の関係を記録する正式な記録と説明しています。OSSライブラリや依存パッケージに脆弱性が含まれていた場合、アプリケーション本体に問題がなくても、企業システム全体に影響が及ぶ可能性があります。これが、いわゆるソフトウェアサプライチェーンリスクです。

クラウド利用の拡大も、脆弱性管理の必要性をさらに高めています。クラウド環境では、サーバーを一度構築して終わりではなく、構成変更、イメージ更新、コンテナ再配備、アクセス制御変更などが高頻度で発生します。そのため、脆弱性管理を継続的に実施しなければ、未更新のソフトウェアや脆弱なイメージ、設定不備がそのまま攻撃対象になる可能性があります。共有責任モデルのもとでは、クラウド事業者がすべてを守ってくれるわけではありません。自社が責任を持つ範囲を理解し、そこを継続的に点検する必要があります。

脆弱性管理の基本プロセス

脆弱性管理の基本プロセスは、一般に以下のような流れです。

  • 脆弱性の発見
  • 脆弱性評価
  • 修正
  • 検証

ただし実務では、前提としてソフトウェア資産の把握が欠かせません。なぜなら、何を保有しているか分からない状態では、脆弱性情報を受け取っても影響判断ができないからです。NVDのような脆弱性データベースは、脆弱性管理の自動化や評価に使える標準化データを提供していますが、それを生かすには自社資産との突合が必要です。

脆弱性の発見は、公開情報の確認だけでなく、スキャンツール、構成管理情報、ベンダーアドバイザリ、クラウドのセキュリティ機能など、複数の情報源を組み合わせて行います。次に必要になるのが評価です。ここではCVSSのような一般的な深刻度だけでなく、インターネット公開の有無、業務影響、悪用実績、代替策の有無、修正難易度などを踏まえて、自社にとっての優先度を決める必要があります。NVDも、CVSSは深刻度の定性的な指標であり、リスクそのものではないと明示しています。

その後、実際に修正を行います。修正方法は、パッチ適用、設定変更、バージョンアップ、アクセス制御の見直し、機能停止、ネットワーク遮断などさまざまです。最後に、修正後の検証を実施し、本当に脆弱性が解消されたか、別の不具合を生んでいないかを確認します。この「修正して終わりにしない」ことが、脆弱性管理を単なる作業ではなく運用として成立させるポイントです。脆弱性管理では、まず自社のIT資産を正確に把握することが重要です。対象にはサーバーやネットワークだけでなく、クラウド環境、利用しているOSSライブラリなども含まれます。

IT資産管理と脆弱性管理の関係については、以下の記事で詳しく解説しています。
「脆弱性管理とIT資産管理とは?サイバー攻撃から組織を守る取り組み」

近年では SBOM(Software Bill of Materials) を利用してソフトウェア構成を可視化する企業も増えています。SBOMは、ソフトウェアに何の部品が含まれているかを一覧化する考え方で、影響範囲の特定や依存関係の把握に有効です。
「SBOMとは?ソフトウェア部品表の基本と企業が導入すべき理由」

脆弱性管理のフロー(実務)

実務に落とし込むと、脆弱性管理の流れは以下のような順番で整理することができます。

  1. 脆弱性情報の収集
  2. クラウド・OSSへの影響確認
  3. 優先度判断
  4. 修正
  5. 再確認

まず行うべきは、CVE、ベンダーアドバイザリ、クラウドベンダー通知、各種セキュリティ情報の収集です。ここで漏れがあると、そもそも対応のスタート地点に立てません。CISAは、実際に悪用が確認された脆弱性についてKEV Catalogの確認と優先的な是正を強く推奨しています。

次に必要なのが、収集した情報が自社環境に関係するかどうかの確認です。オンプレミス機器だけなら比較的見通しが立ちますが、現在はクラウド上のワークロード、コンテナ、OSSライブラリ、CI/CDで取り込んだ部品まで視野に入れなければ、実態を取り逃がします。とくにOSS脆弱性は、アプリケーション本体よりも深い依存関係に潜んでいる場合があり、SBOMやSCAの仕組みがないと把握が難しくなります。

優先度判断では、CVSSの高さだけで対応順を決めないことが重要です。CVSSは比較の基準になりますが、公開サーバーにあるのか、認証が必要なのか、すでに悪用実績があるのか、業務停止時の影響はどれほどかによって、実際の対応順は変わります。NVDもCVSSをリスクそのものではないと説明しており、KEVのような実悪用情報と組み合わせて判断するのが現実的です。

修正段階では、パッチ適用だけに視野を限定しないことが大切です。クラウド環境では、OSやミドルウェアの更新に加え、コンテナイメージの差し替え、設定変更、公開範囲の見直し、権限調整なども重要な対策になります。修正後は再スキャンや設定確認を行い、実際に解消されたことを確認します。ここで検証が不十分だと、「対応したつもり」で終わってしまい、後になって再発見されることがあります。

脆弱性管理では、脆弱性を発見するだけでなく、発見された脆弱性に対して迅速に対応することが重要です。適切な脆弱性対応を行わなければ、攻撃者に悪用され、情報漏えいやシステム停止などの重大なインシデントにつながる可能性があります。脆弱性対応の基本的な流れや実務での対応方法については、以下の記事で詳しく解説しています。
「脆弱性対応とは?CVE対応とパッチ管理の実務フロー」

近年ではクラウド環境やOSSライブラリに含まれる脆弱性の影響調査も重要になっています。SBOMを利用すると、影響範囲を迅速に把握できます。

脆弱性管理ツールの種類

脆弱性管理を実務で回すには、ツールの力を借りることが現実的です。ただし、ひとつの製品で全領域を完全にカバーできるとは限りません。一般的な脆弱性スキャナーは、ネットワーク機器、サーバー、OS、ミドルウェア、Webアプリケーションの既知脆弱性を見つけるのに有効ですが、OSSライブラリの依存関係やソフトウェア部品表までは十分に扱えないことがあります。そこで、管理ツール、クラウドセキュリティツール、SBOM管理ツール、SCAツールなどを役割ごとに組み合わせる設計が必要になります。

たとえば、CSPMやCNAPPのようなクラウド向けツールは、クラウド設定やワークロードの状態を継続的に可視化するのに向いています。一方、SCAはアプリケーションが依存しているOSSコンポーネントを洗い出し、既知脆弱性との突合を支援します。SBOM管理ツールは、その構成情報を継続管理し、影響調査を効率化する役割を持ちます。2026年の脆弱性管理では、ネットワークやサーバーだけを見ていても不十分で、クラウドとソフトウェアサプライチェーンまで含めた多層的な可視化が必要です。

OSSの脆弱性を管理するために、SCA(Software Composition Analysis)ツールやSBOM管理ツールを導入する企業も増えています。これは、ソフトウェアの構成部品とその依存関係を可視化しなければ、OSS由来の脆弱性が自社に影響するかどうかを迅速に判断しにくいためです。NTIAも、SBOMをソフトウェア構成要素の透明性向上に役立つ仕組みとして整理しています。

SCA(Software Composition Analysis)ツールとは
ソフトウェアに含まれるオープンソースや外部ライブラリの構成要素を解析し、既知の脆弱性やライセンスリスクを可視化するセキュリティツールです。依存関係を自動的に検出し、CVEなどの脆弱性データベースと照合することで、潜在的なリスクを早期に特定できます。また、ライセンス違反の有無も確認でき、コンプライアンス対応にも有効です。開発プロセスに組み込むことで、セキュアで安全なソフトウェア開発を支援します。

脆弱性スキャンについてはこちらの記事でも詳しく解説しています。
「脆弱性スキャンとは?脆弱性診断ツールの選び方と導入ポイント」

企業の脆弱性管理の課題

多くの企業が脆弱性管理に苦労する理由は、脆弱性そのものより、管理対象の広がりにあります。

IT資産の把握

まず大きいのが、IT資産の把握が難しいことです。クラウド移行、テレワーク、SaaS利用、部門独自導入のツール、コンテナ活用が進むと、情報システム部門が把握していない資産が生まれやすくなります。この状態では、脆弱性情報を受け取っても、自社への影響有無を正確に判断できません。

OSS依存関係の管理

現代のソフトウェアは、直接導入しているライブラリだけでなく、その下位の依存関係にも数多くの部品を抱えています。表面的には安全に見えても、深い階層に脆弱なコンポーネントが含まれていることは珍しくありません。

SBOMの未整備

SBOMが未整備だと、こうした影響範囲調査に時間がかかり、対応の遅れにつながります。

クラウド環境の可視化不足

クラウドでは、責任分界が従来のオンプレミスとは異なり、サービス形態によって利用者側の責任範囲が変わります。そのため、「クラウド事業者が面倒を見ているはず」と誤解してしまうと、更新漏れや設定不備を放置しやすくなります。共有責任モデルを前提に、自社の管理範囲を明確にしなければ、脆弱性管理は形骸化します。

OSS利用時に重要な脆弱性管理(SBOMの活用)

OSSの活用は、開発効率や品質向上の面で大きなメリットがありますが、その一方で脆弱性管理を複雑にします。理由は明快で、企業が自分で一から書いていないコードであっても、最終的に自社サービスや製品の一部として責任を負うからです。OSS由来の脆弱性は、アプリケーション本体ではなく依存パッケージに潜んでいることも多く、目視や台帳だけで追いきるのは現実的ではありません。

ここで重要になるのがSBOMです。NTIAはSBOMを、ソフトウェアを構成する各種コンポーネントとサプライチェーン上の関係を記録する正式な記録と定義しています。これを整備しておけば、新たな脆弱性が公表された際に、「自社のどのシステムに、その部品が含まれているか」を調べやすくなります。結果として、影響調査の初動が速くなり、不要な全件調査や属人的な確認作業を減らせます。

SBOMは、単に監査対応のために作る資料ではありません。脆弱性管理の実務で使えてこそ意味があります。たとえば、SCAツールで依存関係を検出し、その情報をSBOMとして管理し、脆弱性公表時に突合するという流れが定着すれば、OSS脆弱性への対応速度と精度を高めやすくなります。今後の企業システムでは、OSS利用時の脆弱性管理をSBOM抜きで考えることは難しくなっていくでしょう。

脆弱性管理を効率化する方法

脆弱性管理を効率化する方法はいくつかあります。

資産管理の自動化

資産台帳を手作業で維持する運用では、クラウドやコンテナ、SaaSの増減に追いつけません。CMDB、クラウド資産可視化、ID管理、EDRやMDMの情報などを組み合わせて、現時点の資産情報を継続的に更新できる状態を目指す必要があります。資産情報が整えば、脆弱性情報との突合精度も上がります。

OSS脆弱性監視

OSS脆弱性監視の仕組みを作ることも重要です。開発時点だけでなく、運用中のアプリケーションについても、依存ライブラリの脆弱性を継続監視しなければなりません。脆弱性管理をインフラ部門だけの仕事にせず、開発部門やDevOps運用の中に組み込むことが、今の実務では不可欠です。

SBOMによるソフトウェア構成管理

SBOMによるソフトウェア構成管理を取り入れることで、影響調査の速度と精度をさらに高められます。SBOMが整っていれば、新たなCVEが公表された際にも、対象ソフトウェアの所在確認を短時間で進めやすくなります。加えて、KEVのような実悪用情報を監視し、CVSSだけでなく悪用実績も含めて優先順位を決める運用にすれば、限られた人員でも効果的に対応しやすくなります。脆弱性管理を効率化するとは、単にツールを増やすことではなく、「見つける」「判断する」「直す」を早く回せる仕組みへ変えることです。

まとめ

脆弱性管理とは、脆弱性を発見する作業ではなく、自社のIT資産、クラウド環境、OSSコンポーネントを継続的に把握し、影響を判断し、優先順位をつけて修正し、再確認する運用そのものです。2026年の企業環境では、オンプレミスだけを見ていては不十分で、クラウド、SaaS、コンテナ、OSSまで含めた視点が欠かせません。とくに、実際に悪用される脆弱性への対応と、SBOMを活用したソフトウェア構成の可視化は、これからの脆弱性管理の重要な柱になります。

まず取り組むべきなのは、完璧な仕組みを一気に作ることではなく、自社の資産を洗い出し、脆弱性情報を収集し、優先度を判断し、修正後に確認するという基本サイクルを止めずに回すことです。そのうえで、クラウド可視化、SCA、SBOM管理などを段階的に取り入れていけば、脆弱性管理は現場で機能する実践的な仕組みに育っていきます。


【関連ウェビナーのご案内】
本記事では、脆弱性スキャンとは何か、脆弱性診断との違い、ツール比較のポイント、導入時の考え方までを整理しました。次回、5月20日(水)14時からの開催のウェビナーでは、AssetViewとFutureVulsのメーカーが登壇し、各領域の役割をどのように整理し、どのように連携させれば実効性ある脆弱性管理が実現できるのか、解説します。脆弱性管理の考え方について深くを理解されたい方は、ぜひご参加ください。

その他のウェビナー開催情報はこちら


BBSecでは

BBSecでは以下のようなご支援が可能です。 お客様のご状況に合わせて最適なご提案をいたします。

SQAT®脆弱性診断サービス

サイバー攻撃に対する備えとして、BBSecが提供する、SQAT脆弱性診断サービスでは、攻撃者の侵入を許す脆弱性の存在が見逃されていないかどうかを定期的に確認することができます。自組織の状態を知り、適切な脆弱性対策をすることが重要です。

アタックサーフェス調査サービス

インターネット上で「攻撃者にとって対象組織はどう見えているか」調査・報告するサービスです。攻撃者と同じ観点に立ち、企業ドメイン情報をはじめとする、公開情報(OSINT)を利用して攻撃可能なポイントの有無を、弊社セキュリティエンジニアが調査いたします。

編集責任:木下

Security NEWS TOPに戻る
バックナンバー TOPに戻る


年二回発行されるセキュリティトレンドの詳細レポート。BBSecで行われた診断の統計データも掲載。

サービスに関する疑問や質問はこちらからお気軽にお問合せください。


Security Serviceへのリンクバナー画像
BBSecコーポレートサイトへのリンクバナー画像
セキュリティ緊急対応のバナー画像
ウェビナーアーカイブ動画ページバナー画像

特別寄稿/AI時代のセキュリティ戦略:トライコーダ上野宣氏が語る、攻撃と防御の最前線【後編】

Share
上野宣氏

生成AIの進化により、サイバー攻撃と防御の双方でAI活用が加速する現代。前編では、AIがもたらす脅威の変化と、企業が直面する新たなリスク構造について、上野 宣氏に解説いただきました。

後編では、こうした環境変化を踏まえ、企業はどのようにセキュリティ戦略を再構築すべきか、その具体的な方向性と実践のポイントについて掘り下げます。

前編「AIが変える攻撃の現状と、防御側AI活用のリアル」はこちら


AI時代に増えるリスクと、経営が取るべきアクション

企業が直面するAIセキュリティリスク

AIを活用する企業は、攻撃の標的になるだけでなく、自社が導入したAIがリスクの起点になる可能性も抱えます。ここで重要なのは、「AIを守る」という視点です。 AIは、データアクセスを統合し、業務フローに深く入り込みます。言い換えると、AIは便利なツールであると同時に、新たなリスクになり得ます。

以下では、AI活用が進む現場で起きやすいリスクを、実務の観点で整理します。

生成AI利用による情報漏えい・シャドーAI

現場が便利さを優先して、個人アカウントの生成AIに機密情報を入力してしまう、いわゆるシャドーAIは、シャドーITと同じ構図で広がります。入力データの扱い(学習に使われるのか、保存されるのか)、ログに残るのか、社外に送信されるのか。利用ルールと技術的な制御がないと、情報資産の漏えいに繋がる可能性があります。

対策は利用を禁止することではありません。ほとんどの従業員は悪意を持ってシャドーAIをするわけではなく、ビジネスに活用しようとしているだけです。現場の生産性要求は止められないからこそ、次のような使えるガードレールが必要です。

  • 会社が認めるAI利用チャネル(法人契約、社内AI、承認済みツール)を用意する
  • 機密分類に応じて「入力禁止」「要マスキング」「要承認」などを定義する
  • DLP、プロキシ、CASB等で、持ち出し・入力を技術的に抑止する(可能な範囲で)
  • 利用ログを残し、例外管理を行う

プロンプトインジェクション/RAG汚染:AIアプリ特有の攻撃面

社内ナレッジ検索(RAG)やAIチャットボットを業務に組み込むと、従来のWeb脆弱性とは別の攻撃面が生まれます。

  • プロンプトインジェクション:悪意ある指示でAIの挙動を変え、機密を引き出す
  • RAG汚染:参照ドキュメントに誘導文を仕込み、誤誘導・情報漏えいを誘発
  • 権限モデルの破綻:AIが見えてはいけない情報を横断的に回答してしまう
  • ツール連携の悪用:AIに「メール送信」「DB更新」「ワークフロー実行」などを許すと、誤操作や悪用の影響範囲が一気に広がる

こうしたリスクは、アプリの仕様・権限・データ設計の問題として現れるため、情シス・開発・セキュリティが一体で設計し直す必要があります。

学習データ汚染・モデル改ざん・信頼できない出力

モデルそのもの、あるいは学習・評価・運用のパイプラインが攻撃されると、判断の信頼性が崩れます。たとえば、学習データやナレッジに悪意ある情報が混ざる、モデルの設定が変えられる、評価(テスト)が形骸化する。こうした問題は、結果として「AIが間違った結論を自信満々に出す」形で表面化します。業務に組み込むほど、誤りは事故になります。

  • 重要業務ほど根拠(参照元)を提示できる設計が必要
  • 出力の正しさを検証できない領域では人の確認を前提にする
  • 仕様変更・データ更新・モデル更新は変更管理(レビュー、承認、ロールバック)に乗せる

モデル盗難・データ推定・API悪用

外部APIや自社モデルを提供する側になると、今度は「モデルを盗まれる」「APIを乱用される」「出力から学習データが推定される」といった論点が生まれます。ここでは、認証・認可、レート制限、監査ログ、鍵管理、テナント分離など、従来のAPIセキュリティの要諦がそのまま効いてきます。

ガバナンス・法令・説明責任

AIは出力が意思決定に影響するため、誤りがビジネス事故に直結します。個人情報・機密情報・著作権・差別・説明責任など、論点は多岐にわたります。

AIの利用に関する法規制も急速に整備されつつあり、2024年8月にはEUでArtificial Intelligence Act(欧州AI規制法)が施行されました。違反時の罰則は最大で全世界年間売上高の7%または3,500ユーロと非常に厳しいものです。

海外取引がある企業であるほど、規制動向を踏まえたガバナンスが必要になります。重要なのは、法令対応を法務任せにせず、セキュリティと一体で運用設計に落とすことです。

経営層・CISOが取るべきアクション:AIセキュリティを“経営課題”にする

AI時代のセキュリティ戦略は、現場の頑張りだけでは成立しません。経営が意思決定すべきポイントは、概ね次の3つに分けられます。

方針(何を守り、どこまで許容するか)

  • AIの利用目的と禁止事項を明文化(機密分類と紐付ける)
  • 人が最終責任を持つ領域を定義(例:与信、採用、重要判断、法的判断)
  • 委託・SaaS・外部APIの利用条件(データの持ち出し、学習利用、ログ保管、保存期間)
  • 例外申請の道を用意し、現場がこっそり使う状況を減らす

体制(誰が意思決定し、運用を回すか)

  • AIガバナンス(責任者・審査プロセス・例外管理)の設置
  • CISO/CSIRT/SOCとAI開発・運用の接続(棚卸し・脅威モデリング・運用手順)
  • インシデント対応計画の更新(AI由来の誤回答、漏えい、改ざん、なりすましを含める)
  • 監査・品質・法務・広報も巻き込み、事故時の説明責任を担保する

実装(どう測り、どう改善するか)

  • AIアプリのセキュリティ評価(権限設計、ログ、監査、耐プロンプト攻撃、データ境界)
  • 継続的なテストと監視(レッドチーミング、監視指標、評価データ更新)
  • 教育の刷新(AI時代のフィッシングやディープフェイクを含む訓練)
  • サードパーティ評価(ベンダーのデータ取り扱い、透明性、監査可能性)

ここで、経営層・CISOが最初の一手として取り組みやすいのが、「AI利用の棚卸し」です。「誰が、どのAIを、何の業務で、どんなデータを扱っているか」を把握できない限り、リスク評価も投資判断もできません。

棚卸しの結果をもとに、次のような優先順位付けを行います。

  • 高優先:機密データ×外部AI×自動実行(ツール連携)
    事故時の影響が大きく、設計変更が必要になりやすい領域
  • 中優先:社内AI×業務支援(要約・検索)
    ルールと権限、ログ、監査で事故を起こしにくい設計にする
  • 低優先:公開情報×個人利用(学習目的)
    教育・ガイドライン中心でコントロールする

「AI導入=生産性向上」の議論は進みやすい一方で、「AI導入=新しいリスクの導入」という議論は後回しになりがちです。だからこそ、経営とCISOが同じテーブルで、“AIで守る”と“AIを守る”を同時に設計することが、競争力に直結します。

CISO/経営が迷わないための90日ロードマップ

AIセキュリティはやることが多く見えますが、最初から完璧を目指すと止まります。ここでは、取り掛かりやすく、成果が見えやすい90日プランを例示します。

  • 0〜30日:現状把握とルール整備(止血)
    • AI利用の棚卸し(部署・用途・データ種類・外部/社内)
    • 重要データの分類と、AI入力可否ルール(暫定版でもよい)
    • 決裁・送金・機密共有の“なりすまし耐性”点検(電話確認、二要素、手順の固定化)
  • 31〜60日:AIアプリの設計レビューと運用の接続(再発防止)
    • RAG/チャットボット等の権限設計レビュー(最小権限、データ境界、回答制御)
    • 監査ログ設計(入力・参照・出力・実行の記録)
    • SOC/CSIRTがAI起因の事故を扱えるよう、手順と訓練シナリオを更新
  • 61〜90日:継続改善の仕組み化
    • 定期評価(レッドチーミング/診断/演習)の計画化
    • KPIの設定(例:棚卸しカバー率、AI入力ルール遵守率、初動時間、復旧時間)
    • ベンダー・委託先に対する要求事項(データ取扱い、監査、透明性)のテンプレ化

AIは導入のスピードが速い分、暫定のガードレールを早く敷き、走りながら改善する発想が現実的です。

技術責任者向け AIアプリを“事故らせない”ための設計ポイント

CTO/開発責任者の立場では、「AIを入れるかどうか」より「AIをどう組み込むか」が勝負になります。特に事故を起こしやすい論点は、次の5つです。

  1. 権限とデータ境界:AIの回答が横断参照にならないよう、検索・参照段階でアクセス制御する
  2. 根拠提示:可能な限り参照元(文書ID、URL、更新日時)を出し、検証可能性を担保する
  3. 入力と出力の制御:機密らしき文字列のマスキング、出力フィルタ、禁止操作の明確化
  4. ツール連携の安全化:実行系は二重確認・最小権限・レート制限・停止スイッチを前提にする
  5. 監査ログと再現性:入力・参照・出力・実行を記録し、事故時に再現できるようにする

便利さは機能追加で得られますが、信頼性は設計でしか得られません。AIを業務に組み込むほど、セキュリティは後付けでは間に合わなくなります。

次の5年で起きること、起きないこと

今後数年で見えているのは、次の潮流です。

  • 攻撃の自動化はさらに進む:偵察から侵入、横展開まで“部分最適”が積み上がる
  • 防御は「検知」から「耐性設計」へ:侵入前提で、権限・ネットワーク・データの分離を徹底する
  • AIセキュリティが専門領域として独立:従来のAppSec/CloudSecに、AI特有の評価観点が加わる
  • 規制・顧客要求が増える:説明責任、監査、データ管理が調達条件になる
  • 人材の取り合いが起きる:AI×セキュリティ×事業の三領域を理解する人材が不足する

AI関連のセキュリティは、単一の製品カテゴリに収束しにくい領域です。LLMの挙動評価、プロンプト攻撃耐性、データ境界、監査ログ、運用プロセスなど論点が横断的だからです。そのため今後は、ツール導入に加えて、第三者による評価(診断・レビュー・レッドチーミング)と、運用を回す支援(監視・手順整備)がセットで求められる場面が増えていくでしょう。

一方で、変わらないものもあります。資産管理、脆弱性管理、特権管理、バックアップ、監視、訓練などのいわゆる基本は、AI時代でも依然として高い効果を示します。AIがさまざまな能力を拡張してくれる機能を提供するため、基本が弱い組織ほど被害も増幅されます。

まとめ:これからのセキュリティに携わる人へ

攻撃も防御もAI時代に突入し、企業は「AIで守る」だけでなく「AIを守る」視点を持つことが不可欠になりました。重要なのは、AIを恐れることでも、AIに依存することでもありません。現場の運用と、経営の意思決定をつなぎ、継続的に改善できる仕組みを作ることです。

そして、これからセキュリティ業界に携わりたい人、すでに現場で経験を積みステップアップしたい人に伝えたいのは、AIが広がるほど「基礎」が価値を増すという事実です。 攻撃者がAIで効率化するほど、守る側には、設計・運用・検証の地味な力が求められます。AIは学習すれば追いつけますが、現場の勘所である何を優先し、どこに投資し、どう回すかは、積み上げでしか身につきません。

最後に、AI時代のセキュリティを一言で表すなら、「スピードの時代」です。攻撃のスピードが上がる以上、防御も“検知してから考える”では遅れます。 平時からの設計(境界・権限・ログ)と、迷わず動ける手順(初動・連絡・隔離・復旧)が、被害の差になります。AIはそれを加速してくれる道具にも、穴を広げる要因にもなります。だからこそ、今このタイミングで戦略を更新する価値があります。

付録:企業が「今すぐ」着手できるチェックリスト

AI利用の棚卸し(ガバナンスの入口)

  • 生成AIの利用実態(シャドーAI)を把握できているか
  • どの部署が、どのAI(外部/社内)を、どの業務に使っているか一覧化できているか
  • 取り扱うデータ(機密/個人情報/顧客情報/ソースコード等)を分類できているか
  • 外部AIに投入するデータのマスキング・匿名化・要約など、代替手段を用意しているか

AIアプリ(RAG/チャットボット等)の設計・運用

  • 権限(誰が何にアクセスできるか)をAIの回答レベルまで落とし込めているか
  • 参照データの取り込み経路は管理され、改ざん検知やレビューがあるか
  • 監査ログ(誰が何を聞き、何を参照し、何を出力したか)を残せているか
  • ツール連携(実行系)を許す場合、二重確認・最小権限・停止スイッチがあるか

AI時代の“人”への対策

  • フィッシング訓練はAI時代(自然文・音声・偽装)に合わせて更新したか
  • なりすまし対策(決裁・送金・機密共有の手順)を見直したか
  • インシデント対応訓練で「深夜の役員なりすまし」「AIの誤回答による事故」などを扱っているか

ブロードバンドセキュリティからのご案内

AI活用が進むほど、攻撃面は「システム」だけでなく「データ」「運用」「人」に広がります。まずは現状の棚卸しと、優先順位付けが重要です。ブロードバンドセキュリティ(BBSec)では、脆弱性診断(Web/アプリ/クラウド)に加え、運用設計・監視・セキュリティ運用支援まで、状況に合わせてワンストップでご支援可能です。必要に応じて、AI導入・AIアプリ運用に伴うリスクの洗い出しや、運用プロセスの整備もご相談いただけます。


―END―
【前編】「AIが変える攻撃の現状と、防御側AI活用のリアル」はこちら


執筆:上野 宣 氏
株式会社トライコーダ代表取締役
奈良先端科学技術大学院大学で山口英教授のもと情報セキュリティを専攻、2006年にサイバーセキュリティ専門会社の株式会社トライコーダを設立。2019年より株式会社Flatt Security、2022年よりグローバルセキュリティエキスパート株式会社、2025年より株式会社ブロードバンドセキュリティの社外取締役を務める。あわせて、OWASP Japan代表、一般社団法人セキュリティ・キャンプ協議会理事、NICT CYDER推進委員などを歴任し、教育・人材育成分野にも尽力。情報経営イノベーション専門職大学(iU)客員教員。

編集責任:木下・彦坂

スペシャル記事 TOPに戻る
バックナンバー TOPに戻る


年二回発行されるセキュリティトレンドの詳細レポート。BBSecで行われた診断の統計データも掲載。

サービスに関する疑問や質問はこちらからお気軽にお問合せください。


Security Serviceへのリンクバナー画像
BBSecコーポレートサイトへのリンクバナー画像
セキュリティ緊急対応のバナー画像
ウェビナーアーカイブ動画ページバナー画像

なぜ取引先経由で情報漏えいが起きるのか ―国内で相次ぐサプライチェーン攻撃の実態―

Share
なぜ取引先経由で情報漏えいが起きるのか ―国内で相次ぐサプライチェーン攻撃の実態―アイキャッチ画像

近年、「自社に不正アクセスはなかったのに情報が漏えいした」という状況が増えています。その多くは、取引先や委託先、外部サービスを経由したサプライチェーン攻撃が原因です。本記事では、なぜこうした“取引先経由”の情報漏えいが起きやすいのか、国内で実際に起きている事例や背景をもとに整理します。攻撃の構造を理解することで、見えにくいリスクに気づく視点を持つことができます。

こうしたリスクを前提に、委託先や外注先のセキュリティをどこまで確認すべきか悩む企業も少なくありません。実務の判断ポイントについては、以下の記事で整理しています。
「委託先・外注先のセキュリティはどこまで確認すべきか」

自社が原因でなくても、情報漏えいは起きてしまう時代

近年、「自社システムに不正アクセスはなかった」と説明される情報漏えい事故が国内で相次いでいます。調査を進めると原因は自社ではなく、取引先や外部サービスを経由した不正アクセスだった、というケースが少なくありません。こうした攻撃はサプライチェーン攻撃と呼ばれ、いま日本企業にとって最も現実的なセキュリティリスクの一つになっています。特にSaaSや外部委託、API連携が当たり前になった現在、このリスクは業種や企業規模を問わず存在します。

サプライチェーン攻撃とは何か

サプライチェーン攻撃とは、標的となる企業そのものではなく、取引先・委託先・連携している外部サービスを踏み台に侵入する攻撃手法です。サプライチェーン攻撃の全体像や基本的な考え方については、以下の記事で整理しています。あわせてぜひご覧ください。
「サプライチェーン攻撃とは ―委託先・外注先リスクから情報漏えいを防ぐ全体像―」

なぜ今、国内でサプライチェーン攻撃が増えているのか

背景にあるのは、企業活動のデジタル化と外部依存の加速です。業務効率化のためにSaaSを導入し、外部ツールとAPIで連携し、専門業務を外注することは、今や珍しいことではありません。一方で、こうした外部接点が増えるほど、攻撃者にとっての「侵入口」も増えていきます。特に、委託先や小規模ベンダーでは十分なセキュリティ対策が取られていないケースもあり、結果としてそこが狙われやすくなります。さらに最近では、認証情報の使い回しや権限設定のミスを自動的に探し出す攻撃手法も増えており、従来型の対策だけでは気づかないうちに侵入されるリスクが高まっています。

国内で実際に起きているサプライチェーン攻撃の特徴

国内で報告されているサプライチェーン攻撃の多くには共通点があります。それは、自社システムが直接破られたわけではなく、正規の連携機能や委託先のアクセス権限が悪用されている点です。そのため、ログを見ても不正アクセスだと気づきにくく、発覚までに時間がかかることがあります。結果として、数万件から数十万件規模の個人情報や顧客データが流出して初めて問題が表面化する、という事態につながります。サプライチェーン攻撃が怖いのは、まさにこの「想定外の経路」から被害が発生する点にあります。

サプライチェーン攻撃の国内事例や攻撃手口については、以下の記事でも解説しています。こちらもあわせてぜひご覧ください。
「事例から学ぶサプライチェーン攻撃 -サプライチェーン攻撃の脅威と対策2-」

サプライチェーン攻撃が企業にもたらす影響

この種の攻撃によって発生するのは、単なるシステムトラブルではありません。個人情報漏えいによる顧客からの信頼低下、取引先との関係悪化、場合によっては契約違反や損害賠償の問題に発展することもあります。近年では、「原因が委託先にあった」と説明しても、情報管理責任そのものは発注元企業にあると判断されるケースが増えています。サプライチェーン攻撃は、企業の信用そのものを揺るがすリスクだと言えるでしょう。

企業が今すぐ考えるべきサプライチェーン対策

まず重要なのは、自社がどのような外部サービスや委託先とつながっているのかを正確に把握することです。意外と、過去に導入したまま使われていないSaaSや、誰が管理しているのか分からない連携設定が残っていることも少なくありません。そのうえで、外部サービスや委託先に付与している権限が本当に必要最小限になっているかを見直す必要があります。「業務上便利だから」という理由で広い権限を与えたままにしていると、それがそのまま攻撃経路になってしまいます。また、技術的な対策だけでなく、委託契約や運用ルールの見直しも欠かせません。インシデント発生時の報告義務や再委託の条件、セキュリティ対策状況の確認方法などを明確にしておくことで、リスクを大きく下げることができます。

まとめ:サプライチェーン全体を見る視点が不可欠に

サプライチェーン攻撃は、もはや一部の大企業だけの問題ではありません。外部サービスを利用し、業務を委託し、クラウド連携を行っている企業であれば、規模に関係なく直面する可能性があります。重要なのは、自社のシステムだけを見るのではなく、自社を取り巻くサプライチェーン全体をどう管理するかという視点です。そこに目を向けない限り、同様の事故は今後も繰り返されるでしょう。

また、これらの事故は経営判断とも直結します。
「サプライチェーン攻撃と経営責任 ―委託先が原因でも問われる企業の判断とは ―」


こうした実態を踏まえると、サプライチェーン攻撃は個別対策だけでは防ぎきれません。委託先や外部サービスを含めた全体像を把握し、どこにリスクが集中しているのかを整理する視点が不可欠です。
「サプライチェーン攻撃とは ―委託先・外注先リスクから情報漏えいを防ぐ全体像―」

BBSecでは

サプライチェーン攻撃への対策では、「何となく不安だが、どこから手を付ければいいか分からない」という声を多く聞きます。外部接点が増えた現代では、勘や経験だけでリスクを把握するのは難しくなっています。ブロードバンドセキュリティ(BBSec)では、外部委託先や連携サービスを含めたセキュリティリスクの可視化や、運用・体制面まで踏み込んだ支援を行っています。サプライチェーン全体を前提とした評価や改善を進めることで、「自社は大丈夫」という思い込みによるリスクを減らすことが可能です。もし、自社のサプライチェーンリスクに少しでも不安を感じているのであれば、一度立ち止まって全体を整理するところから始めてみてはいかがでしょうか。

【参考情報】


Security NEWS TOPに戻る
バックナンバー TOPに戻る


資料ダウンロードボタン
年二回発行されるセキュリティトレンドの詳細レポート。BBSecで行われた診断の統計データも掲載。
お問い合わせボタン
サービスに関する疑問や質問はこちらからお気軽にお問合せください。

Security Serviceへのリンクバナー画像
BBsecコーポレートサイトへのリンクバナー画像
セキュリティ緊急対応のバナー画像