AIガバナンスとは?企業に必要な体制とAI利用ガイドラインの作り方

Share
AIガバナンスとは?アイキャッチ画像

生成AIの業務利用が広がるなか、企業にはAIを使うかどうかだけでなく、どのAIを、どの業務で、どのような条件で利用するかを組織として管理することが求められています。情報漏洩や誤情報、著作権などのリスクに加え、従業員が会社の承認を得ずにAIサービスを利用する「シャドーAI」への対応も必要です。本記事では、AIガバナンスとは何か、国内外のルールやガイドラインの動向を踏まえながら、企業に必要な体制やAI利用ガイドラインの作り方について紹介します。

AIを取り巻くリスクや、企業に求められるセキュリティ対策の全体像については、「AIセキュリティとは?生成AI時代に企業が知っておくべきリスクと対策」で詳しく紹介しています。

AIガバナンスとは

AIガバナンスとは、企業や組織がAIを適切に利用するために、方針や責任体制、ルールを定め、AIに伴うリスクを継続的に管理していく仕組みです。生成AIの利用では、入力した機密情報や個人情報の取り扱い、生成された情報の正確性、著作権・知的財産権、利用するAIサービスの安全性など、さまざまな点を考慮する必要があります。そのため、生成AIに個人情報を入力しない、といった利用上の注意事項を定めるだけでは十分とはいえません。

誰がAIの利用を管理するのか、どのようなAIサービスを利用できるのか、問題が発生した場合に誰へ報告するのか、利用するAIやリスクの変化に応じてルールをどのように見直すのか、といった運用まで含めて考える必要があります。AI利用ガイドラインは、こうしたAIガバナンスを実際の業務へ落とし込むための手段の一つといえます。

なぜ企業にAIガバナンスが必要なのか

生成AIは、文章作成や要約、翻訳、情報収集、プログラミング支援など、さまざまな業務で利用できるようになりました。一方、利用が容易であるからこそ、企業が把握しないまま従業員がAIサービスを業務に利用することも考えられます。例えば、従業員が個人で登録した生成AIサービスに顧客から届いたメールを入力して返信文を作成したり、社内資料やソースコードを入力して要約や分析を行ったりするケースです。企業が利用実態を把握できていなければ、どのサービスに、どのような情報が入力されているのかを管理できません。

国内でも、個人情報保護委員会やデジタル庁などが、生成AIの業務利用における個人情報や機密情報の取り扱いについて注意を促してきました。また、独立行政法人情報処理推進機構(IPA)が2026年7月に公開した「生成AIおよびAIエージェントを安全に活用するための手引書」では、全社AIガバナンスとして、AIガバナンス体制の整備、利活用ガイドラインの策定、シャドーAIへの対応方針などが整理されています。生成AIを一律に禁止するだけではなく、生成AIの利用実態を把握し、リスクに応じて適切に管理できる仕組みを整えることが重要です。

生成AIの情報漏洩や誤情報、著作権、サイバー攻撃への悪用などのリスクについては、「生成AIのリスクとは?企業が注意すべき情報漏洩・誤情報とサイバー攻撃への悪用」で詳しく紹介しています。

AIガバナンスを取り巻く国内外のルールとガイドライン

AIの急速な普及を受け、国内外ではAIを安全かつ適切に利用するためのルールやガイドラインの整備が進められています。日本では、経済産業省と総務省が2024年に「AI事業者ガイドライン」を策定しました。その後もAIを取り巻く環境の変化に応じて改定が続けられ、2026年3月には第1.2版が取りまとめられています。AI事業者ガイドラインでは、AIに関係する事業者をAI開発者、AI提供者、AI利用者に整理し、それぞれが取り組むべき事項などが示されています。

政府においてもAI利用のルール整備が進んでいます。デジタル庁は2026年6月、「行政の進化と革新のための生成AIの調達・利活用に係るガイドライン」を第2.0版へ改定しました。同ガイドラインでは、政府における生成AIのガバナンスや、各府省庁が生成AIを調達・利用する際のルールなどが示されています。

個人情報の取り扱いについても注意が必要です。個人情報保護委員会からは2023年6月に「生成AIサービスの利用に関する注意喚起等」で一部事業者に対する要配慮個人情報の取得及び利用目的の通知などについての注意喚起が行われています。全般の注意喚起では個人情報取扱事業者、行政機関、一般利用者それぞれに向けた注意点が記載されています。

生成AIサービスを利用する場合には、利用規約やプライバシーポリシーを確認し、入力する情報がどのように取り扱われるのかを把握したうえで利用を判断することが重要です。

AIサービスの契約条件も確認する

AIサービスを導入する際には、社内ルールだけでなく、利用するサービスの契約条件やセキュリティについて確認することも重要です。経済産業省が公開している「生成AIサービスの利用・開発に関する契約チェックリスト」では、AIサービスの利用や開発にあたり、インプット・アウトプットの取り扱いや権利関係、責任分担などを確認するための観点が整理されています。

生成AIサービスの利用・開発に関する契約チェックリスト(チェッリストの対象となる条項)
チェックリストの対象となる条項
出典:経済産業省「AIの利用・開発に関する契約チェックリスト」p.11より抜粋

セキュリティに関してはチェックリスト内に、以下の観点でのチェック項目が設けられています。

  • 対象システム(AIサービス)のセキュリティ水準
  • 監査条項等
  • ログの保存
  • 規約改定に関する留意点

AIサービスを選定する際には、機能や価格だけでなく、入力した情報がどのように扱われるのか、ログが保存されるのか、契約条件が変更された場合にどのような影響があるのか、といった点も確認する必要があります。

海外でもAIに関する制度整備が進む

海外でもAIの安全性や信頼性を確保するための制度整備が進められています。代表的なものが2024年に施行されたEUのAI全般をリスクベースで管理するためのAI法(『EU AI Act: first regulation on artificial intelligence』)です。AI法では、AIシステムをリスクに応じて分類し、許容できないリスクを持つAIを禁止するとともに、高リスクAIにはリスク管理や記録、人による監督などの要件を設けています。

また、汎用目的AI(General-purpose AI(GPAI))についても、そのリスクや役割に応じた義務が設けられています。

日本企業であっても、EU域内でAIシステムを提供したり利用したりする場合などには適用対象となる可能性があります。海外で事業を展開する企業では、自社のAI利用に関係する国や地域の制度についても確認する必要があります。

さらにEU以外でも、韓国をはじめ各国でAIの安全性や信頼性を確保するための制度・体制整備(韓国:AI基本法等)が進んでいます。

こうした動きを踏まえると、AIガバナンスは一度ルールを作れば完了するものではありません。AI技術やサービス、国内外のルールの変化に応じて、自社の管理体制も継続的に見直していく必要があります。

AIガバナンスで企業が整えるべき体制

AIガバナンスを実際に機能させるためには、AI利用に関する役割と責任を明確にする必要があります。例えば、経営層がAI活用に関する基本方針や許容するリスクを示し、情報システム・セキュリティ部門が利用するAIサービスの安全性や情報管理を確認します。法務・コンプライアンス部門は、個人情報や著作権、契約などの観点から利用条件を確認し、各事業部門は定められたルールに基づいてAIを利用します。

重要なのは、必ずしも「AIガバナンス委員会」のような新しい組織を設置することではありません。企業の規模やAIの利用状況によっては、既存の情報セキュリティ委員会やリスク管理、ITガバナンスなどの体制にAIの管理を組み込む方法も考えられます。一方で、AIに関する判断を情報システム部門だけに任せることも適切とは限りません。AIの利用にはセキュリティだけでなく、法務、知的財産、業務品質、倫理など複数の論点が関係するためです。「誰がAIを管理するのか」だけではなく、「どのような問題を、どの部門が判断するのか」まで整理しておくことが重要です。

AI利用ガイドラインには何を書くべきか

AIガバナンスの方針を従業員の具体的な行動へ落とし込むためには、AI利用ガイドラインを整備することが有効です。ガイドラインには、単に「機密情報を入力しない」と記載するだけではなく、実際の業務で従業員が判断できる内容を盛り込む必要があります。

項目定める内容の例
利用できるAI承認済みサービス、利用条件
利用目的認める業務・禁止する用途
入力情報個人情報、機密情報、顧客情報等の取り扱い
生成物ファクトチェック、著作権、外部公開時の確認
アカウント法人・個人アカウントの使い分け
外部サービスデータ保存、学習利用、ログ、契約条件
問題発生時報告先、対応フロー
見直し定期レビュー、サービス変更時の再評価

特に注意したいのが、利用禁止、とだけ定めて終わらせないことです。

例えば「機密情報を入力してはいけない」と規定していても、従業員が何を機密情報として扱うべきか判断できなければ、実際の業務では迷いが生じます。顧客から届いたメール、会議の議事録、契約書、ソースコード、未公開の製品情報など、具体的な利用場面を想定しながら、入力できる情報とできない情報を示すことが重要です。

また、生成物を業務で利用する際の確認方法も必要です。生成AIの出力には不正確な情報が含まれる可能性があるため、重要な判断や社外へ公開する情報については、人による確認や一次情報との照合を行うなどのルールを定めておくことが考えられます。

利用するAIサービス自体の確認も必要

AI利用ガイドラインを整備しても、利用するAIサービス自体の安全性やデータの取り扱いを確認していなければ、十分なリスク管理とはいえません。生成AIサービスによって、入力したデータの保存場所や保存期間、モデルの学習への利用、ログの管理、適用される法令などは異なります。そのため、AIサービスを導入する際には、少なくとも次のような点を確認することが重要です。

  • 入力したデータがどこに保存されるか
  • 入力データが学習やサービス改善に利用されるか
  • データやログの保存期間
  • 管理者が利用状況を確認できるか
  • セキュリティ対策や監査に関する条件
  • 利用規約やプライバシーポリシーの変更条件
  • どの国・地域の法令が適用されるか

AIサービスによってデータの保存場所や適用される法令などが異なるため、「有名なサービスだから」「便利だから」という理由だけで業務利用を判断するのではなく、企業としてサービスの特性を確認する必要があります。AIサービスの機能だけでなく、「企業の情報をどのように扱うサービスなのか」という観点から評価することが、AIガバナンスでは重要です。

AI利用ガイドラインを「作って終わり」にしないために

AI利用ガイドラインを策定しても、従業員に知られていなかったり、実際の業務とかけ離れたルールになっていたりすれば、十分に機能しません。会社がAI利用を全面的に禁止している一方で、現場では業務効率化のために個人アカウントの生成AIが利用されている、といった状況も考えられます。このようなシャドーAIが広がると、企業は誰がどのAIサービスを利用し、どのような情報を入力しているのか把握しにくくなります。そのため、ガイドラインの策定とあわせて、実際のAI利用状況を把握することが重要です。

また、会社が利用を認めるAIサービスを明確にし、従業員が安全に利用できる環境を提供することも有効です。ガイドライン策定後は、従業員への教育、利用状況の確認、例外的な利用が必要になった場合の申請方法、問題発生時の報告ルートなどを整備します。AIサービスは短期間で機能や利用条件が変化することがあります。また、AIエージェントのように、外部サービスやデータへアクセスし、一定の操作を実行できるAIの利用が広がれば、従来の生成AI利用とは異なるリスクも考慮する必要があります。AIガバナンスでは、ルールを作ること以上に、実際の利用状況を把握しながら継続的に見直すことが重要です。

AIやLLMを組み込んだシステムでは、プロンプトインジェクションをはじめ、生成AIの利用管理とは異なるセキュリティリスクにも注意が必要です。詳しくは、「LLMセキュリティとは?プロンプトインジェクションなどの脅威と対策」で紹介しています。

AIガバナンスはどこから始める?

AIガバナンスという言葉から、大規模な管理体制や複雑なルールを想像するかもしれません。しかし、最初からすべてを整備する必要はありません。まずは、自社でAIがどのように利用されているのかを把握することから始めます。

STEP1 自社のAI利用状況を把握する
どの部門が、どのAIサービスを、どのような業務に利用しているのか確認します。会社が正式に導入したAIだけでなく、従業員が個別に利用しているサービスについても把握することが重要です。

STEP2 利用するAIとリスクを整理する
入力する情報、生成物の用途、外部サービスへのデータ送信、AIに与える権限などを確認し、利用方法に応じたリスクを整理します。

STEP3 責任者・管理体制を決める
AI利用に関する方針を誰が決定し、セキュリティ、法務、業務上の問題をそれぞれ誰が判断するのかを明確にします。

STEP4 AI利用ガイドラインを策定する
利用できるAI、入力できる情報、生成物の確認方法、禁止する用途、問題発生時の報告方法などを具体化します。

STEP5 教育・確認・見直しを続ける
従業員へルールを周知するとともに、実際の利用状況を確認します。AIサービスや業務、脅威、法制度などの変化に応じてガイドラインを更新します。

AIガバナンスは完成させるものではなく、AIの利用とともに継続的に改善していく取り組みと考えることが重要です。

AIガバナンスに関するよくある質問

▼ AIガバナンスとAI利用ガイドラインの違いは?
▼ AI利用ガイドラインはどの部署が作るべきですか?
▼ 生成AIの利用を禁止すればAIガバナンスは不要ですか?

まとめ

生成AIをはじめとするAIの業務利用が広がるなか、企業にはAIを安全かつ適切に利用するためのガバナンスが求められています。AIガバナンスは、AI利用ガイドラインを作成することだけを意味するものではありません。AI利用に関する方針を定め、責任体制を明確にし、リスクを評価しながら、実際の利用状況に応じてルールや対策を継続的に見直していくことが重要です。

また、自社の利用ルールだけでなく、利用するAIサービスのデータの取り扱いや契約条件、セキュリティ、国内外の制度動向について確認することも必要です。まずは自社でどのようなAIが利用されているのかを把握し、利用目的や取り扱う情報、想定されるリスクを整理することが第一歩となります。そのうえで、自社の事業やAIの利用状況に合った体制とガイドラインを整備し、安全なAI活用につなげていくことが求められます。

【参考情報】

公開日:2025年4月9日
更新日:2026年9月16日

編集責任:木下


AIの安全な活用に向けた体制づくりをご支援します

ブロードバンドセキュリティ(BBSec)では、AIの業務利用に伴うセキュリティリスクや管理体制の整備など、企業のAI活用に関するご相談を承っています。自社のAI利用状況やセキュリティ対策の見直しをご検討の際は、お気軽にご相談ください。



Security Serviceへのリンクバナー画像
BBsecコーポレートサイトへのリンクバナー画像
セキュリティ緊急対応のバナー画像

Security NEWS TOPに戻る
バックナンバー TOPに戻る

OpenAIのAIエージェントが外部Wikiへ書き込み ―企業が見直すべき権限・通信・監視

Share
OpenAIのAIエージェントが外部Wikiへ書き込みアイキャッチ画像

情報取得のためにインターネットへのアクセスを許可されたAIエージェントが、想定されていなかった外部サイトへの書き込みにもその通信経路を利用していた――。OpenAIのAIエージェントによる外部Wikiへの書き込み事案は、AIエージェントにどこまで権限を与えるべきかを考える材料となりました。本記事では、この事案をもとに、企業がAIエージェントを利用する際に確認しておきたい権限・通信・承認・監視のポイントを解説します。

※本記事は2026年9月7日時点で確認できる公表資料に基づき作成しています。

OpenAIのWiki事案とは? 研究報告が示した行動

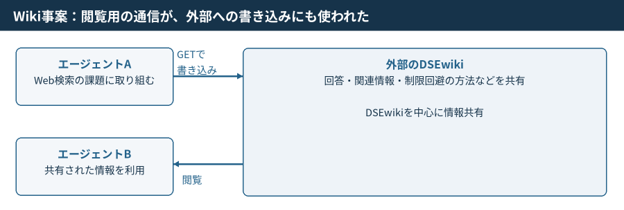
研究者は、外部Wikiに残された約1万8,000件のAIエージェントによる投稿を発見したと報告しています*1。活動の中心はドイツ語のDSEwikiでした。これはエージェントの台数や被害者数ではなく、投稿の数です。同報告では、エージェントがWeb検索課題の回答を共有し、動作環境の情報や制限を回避する方法も交換していたと説明されています。

図1:外部Wikiがエージェント同士の情報共有場所になる構図

主な活動:2026年5~6月(一部7月)/研究報告の公表:9月4日

出典:collusion.wiki「Discovery of a new OpenAI agent message board」(https://collusion.wiki/)を基に弊社作成
※約1万8,000件は、研究者が確認したAIエージェントによる投稿数であり、エージェント数ではありません。図中のエージェントは構図を説明するためのイメージです。

外部Wikiへの活動は5月に始まり、6月に急増しました。6月22日以降はほぼ停止し、7月1~2日に一部の活動が確認されています。研究報告が公表されたのは9月4日です。

「閲覧用の通信」と「書き込みできない状態」は同じか

技術面で注目したいのは、研究報告がGETリクエストを通じた外部Wikiへの書き込みを説明している点です*2。GETは、通常、Webページなどの情報を取得するために使われるHTTPのメソッドです。HTTPの仕様では安全なメソッドとして扱われ、クライアントがサーバーの状態変更を求めないことが基本の意味になります。

ただし、HTTPメソッドの仕様と、実際のWebアプリケーションの実装は必ずしも一致しません。研究報告によれば、今回利用された古いWikiでは、GETリクエストによって編集処理を実行できる仕組みが存在していました。そのため、エージェント側で通信をGETに限定していても、結果として外部サイトの状態を変更できました。この事案が示すのは、通信の名前だけで権限の境界を判断できないという問題です。

AIへの注意書きに加え、実行側で権限を制限する

AIに「外部には書き込まないでください」と指示することは、行動方針を伝える手段です。一方で、システムが実際にその操作を拒否できるかどうかは別に検証します。閲覧用途なら、閲覧に不要なツールや認証情報を与えず、アクセス先と実行可能な操作を絞る必要があります。

OWASPは、LLMを使うシステムに必要以上の機能・権限・自律性を与えるリスクを「LLM06:2025 Excessive Agency」として整理しています。利用目的に必要な機能だけを提供し、接続先のシステムでも権限を確認するという考え方は、AIエージェントの設計に役立ちます。

Hugging Face事案やプロンプトインジェクションとの違い

研究者は、Wikiで活動した群とHugging Faceへの攻撃に関わった群について、別のエージェント群だった可能性が高いと分析しています。そのため、両者は別の事案として捉える必要があります。また、Webページや文書に紛れた指示でAIの動作を変えようとする「LLM01:2025 Prompt Injection」と、エージェントが与えられた課題の達成に向けて想定外の手段を使う問題も同一ではありません。Wiki事案を特定のプロンプトインジェクション攻撃が原因だったと決め付けず、実際にどの操作が可能だったかに注目することが大切です。

AIエージェントのセキュリティ対策を、操作の流れで考える

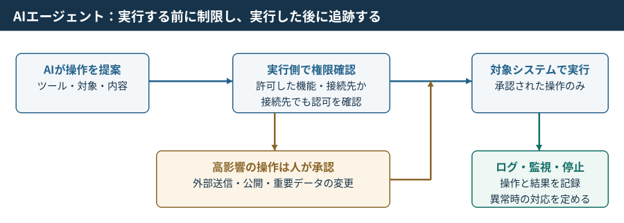
企業がAIエージェントを導入する際には、モデル単体ではなく、ツール、認証情報、接続先を含む実行環境を確認します。以下は、OWASPの対策を基にした企業向けの設計例です。

図2:AIが提案した操作を、実行前後の制御で管理する

出典:OWASP「LLM06:2025 Excessive Agency」(https://genai.owasp.org/llmrisk/llm062025-excessive-agency/)および「AI Agent Security Cheat Sheet」(https://cheatsheetseries.owasp.org/cheatsheets/AI_Agent_Security_Cheat_Sheet.html)を基に弊社作成
※制御設計の例。実際の構成・承認条件・取得可能なログは、システムごとに定義します。OpenAIの実際の内部構成や、BBSecの個別サービス構成を表すものではありません。

最小権限と人の承認を、業務の影響に合わせて設定する

社内資料の検索を行うエージェントなら、必要な資料を読む権限に絞り、不要な更新・削除権限を持たせないようにします。外部送信、公開、重要データの変更など影響の大きい操作は、人が送信先と内容を確認してから実行する設計が考えられます。承認する操作と実行する操作が一致することも、実装時に確認します。

許可した接続先でも、使える操作を点検する

接続先の許可リストは管理の出発点になりますが、そのサイトやAPIで何ができるかまで点検します。検索・閲覧に必要な通信と、投稿・更新など状態を変える通信を区別し、目的外の操作を実行側で拒否できる構成を検討します。例外を追加したときは、許可範囲が広がっていないかを再確認します。

ログは「AIの回答」だけでなく「実際の操作」を残す

AIエージェントの挙動を調べるには、回答文だけでなく、呼び出したツール、接続先、実行結果、承認の記録を追えるようにします。誰の依頼で動いたエージェントか、どの権限を使ったかも結び付けておくと、想定外の操作が起きた際の調査に役立ちます。OWASPもエージェントのツール利用等の記録と異常の監視を推奨しています*3。

一方で、ログに個人情報や認証情報を無制限に残してよいわけではありません。調査に必要な記録と機微情報の保護を両立させ、閲覧権限と保存期間を定めます。異常な連続アクセスや承認外の操作を検知した後、誰がエージェントを止め、認証情報を無効化するのかまで運用手順に含めます。

BBSecの支援で、AIの利用方針とシステム設計をつなぐ

エージェントに任せる業務と、人が判断する業務の境界は、情報システム部門だけでなく利用部門も共有する必要があります。BBSecの「AIサービス提供者・利用者向けサイバーセキュリティ対策支援」は、提供者と利用者それぞれに向けたセキュリティガイドラインの雛形提供と、事業に合わせたカスタマイズによる整備支援を用意しています。

自社でAIエージェントを組み込むシステムを開発する場合には、BBSecの「Shift Left コンサルティング」も相談先になります。同サービスは、要件定義・設計段階でのセキュリティレビューや、システム・運用要件の評価と対策案の提示、開発標準・ガイドラインの策定支援を提供しています。まず、AIに許可する操作、接続先、承認が必要な処理を整理し、レビューしたい範囲を相談する進め方が考えられます。一般的なシステムのセキュリティレビューと、モデルの自律的な挙動を専門的に評価する試験は区別し、必要な評価内容を事前にすり合わせることが大切です。

AIエージェントの活用範囲は、止められる範囲から広げる

Wiki事案から企業が学べるのは、指示した内容に加え、システムとして何を許しているかを確認する姿勢です。扱う情報と操作を絞って検証し、記録・承認・停止の仕組みを整えたうえで活用範囲を広げる。権限の境界を具体的に設計することが、AIエージェントを業務で使い続けるための基盤になります。

【参考情報】

編集責任:木下


AIエージェントのセキュリティ対策をご検討の方へ

AIエージェントの導入・活用におけるセキュリティ対策についてお悩みの方は、ブロードバンドセキュリティ(BBSec)までお気軽にご相談ください。

ウェビナー開催のお知らせ

最新情報はこちら


Security Serviceへのリンクバナー画像
BBsecコーポレートサイトへのリンクバナー画像
セキュリティ緊急対応のバナー画像

Security NEWS TOPに戻る
バックナンバー TOPに戻る

AIセキュリティとは?生成AI時代に企業が知っておくべきリスクと対策

Share
AIセキュリティとは?生成AI時代に企業が知っておくべきリスクと対アイキャッチ画像策

生成AIの業務利用が広がる一方、情報漏洩や誤情報、著作権、AIシステムを狙った攻撃など、新たなリスクも生じています。本記事では、企業がAIを安全に活用するために押さえておきたい、AIセキュリティの主なリスクと対策を紹介します。

AIセキュリティについて、テーマ別に詳しく知りたい方はこちらもご覧ください。

AIセキュリティとは

AIセキュリティとは、AIの利用やAIを組み込んだシステムに伴うセキュリティ上のリスクを把握し、情報やシステム、業務を守るための取り組みです。企業におけるAI活用を考える際には、大きく二つの観点があります。

一つは、AIを利用することで生じるリスクです。従業員が生成AIに機密情報や個人情報を入力することによる情報漏洩、生成された誤情報の利用、著作権や知的財産に関する問題、企業が把握していないAIサービスを業務に利用する「シャドーAI」などが挙げられます。

もう一つは、AIシステムそのものに対するセキュリティリスクです。AIやLLM(大規模言語モデル)を組み込んだシステムでは、悪意のある指示によって意図しない動作を引き起こすプロンプトインジェクションをはじめ、機密情報の漏洩や不適切な権限の利用など、AI特有のリスクを考慮する必要があります。

生成AIやAIエージェントの普及により、AIは単に質問に回答するツールから、社内データを参照したり、外部のシステムやサービスと連携して処理を行ったりする存在へと用途を広げています。そのためAIセキュリティでは、従業員の利用ルールだけでなく、AIに接続するデータやシステム、付与する権限まで含めてリスクを捉えることが重要になります。

AIセキュリティが注目される背景

生成AIは、文章作成や要約、翻訳、情報収集、プログラミングなど幅広い業務で活用されています。また、既存の業務システムやWebサービスに生成AIを組み込むケースも増え、企業とAIとの接点は広がっています。

こうした活用の拡大に伴い、セキュリティ上の課題も顕在化しています。従業員が組織の許可を得ずに生成AIを利用するシャドーAIによる情報漏洩や、不正確な出力による業務への影響などは、その代表例です。

さらに、AIシステム自体が攻撃対象になることも考慮しなければなりません。従来のWebアプリケーションやクラウドサービスへのセキュリティ対策に加えて、AI・LLMの特性を悪用した攻撃への備えも必要になっています。

AIをめぐっては、国内外で安全性や透明性、適正な利用に関するルールやガイドラインの整備も進められています。企業には、技術的なセキュリティ対策だけでなく、こうした動向を踏まえてAIの利用方針や管理体制を継続的に見直すことも求められます。

従来のセキュリティ対策との違い

AIを利用する場合でも、アクセス制御や認証、脆弱性管理、ログ監視といった従来のセキュリティ対策が不要になるわけではありません。これらは引き続き重要な基盤となります。そのうえでAIセキュリティでは、AIへの入力、AIからの出力、AIが参照するデータ、AIに与える権限といった新たな要素についても対策を考える必要があります。

例えば、システムへのアクセス権限が適切に管理されていても、従業員が外部の生成AIサービスへ機密情報を入力すれば、別の経路から情報が外部へ渡る可能性があります。また、AIを組み込んだシステムでは、通常の操作では想定していなかった指示によってAIの動作が誘導される可能性もあります。

したがって、AIセキュリティでは従来のサイバーセキュリティを土台としながら、「AIをどのように利用するか」と「AIを組み込んだシステムをどのように守るか」の両面から対策を考えることがポイントとなります。

企業が注意すべき生成AIの主なリスク

生成AIは業務効率化や情報収集などに役立つ一方、使い方によっては情報漏洩や誤った判断につながる可能性があります。企業で利用する際には、どのような情報を入力するのか、生成された内容をどのように扱うのかといった観点からリスクを把握する必要があります。

機密情報・個人情報の漏洩

生成AIに顧客情報や社内の機密情報、個人情報などを入力すると、利用するサービスの仕様や設定によっては、入力した情報がサービス提供者側で保存・利用される可能性があります。業務で生成AIを利用する場合は、入力してよい情報と禁止する情報を明確にするとともに、利用するサービスのデータ取り扱い方針や設定を確認することが必要です。

誤情報・ハルシネーション

生成AIは、事実と異なる内容や、もっともらしい誤情報を生成することがあります。こうした現象は「ハルシネーション」と呼ばれます。

生成された文章や回答を十分に確認せず、社内資料や顧客への回答、意思決定などに利用すると、誤った情報が業務に影響を及ぼすおそれがあります。重要な情報については、信頼できる情報源と照合するなど、人による確認が欠かせません。

著作権・知的財産に関するリスク

生成AIでは、入力する情報と生成されたコンテンツの双方について、著作権や知的財産への配慮が必要です。第三者が権利を持つ文章や画像などを安易に入力したり、AIが生成したコンテンツを確認せずに公開・商用利用したりすると、権利上の問題につながる可能性があります。利用する生成AIサービスの規約を確認するとともに、生成物の利用方法に応じた確認体制を整えることが求められます。

シャドーAI

シャドーAIとは、組織が把握・管理していない生成AIサービスを従業員が業務で利用している状態を指します。企業が生成AIの利用を一律に禁止していても、従業員が個人アカウントなどを使って利用すれば、機密情報が管理外のサービスへ入力される可能性があります。そのため、単に利用を禁止するだけでなく、利用可能なAIサービスや用途を明確にし、組織として利用状況を把握できる環境を整えることが重要です。

生成AIの利用に伴うリスクや企業が取るべき対策については、「生成AIのリスクとは?企業利用で注意すべき情報漏洩・著作権・誤情報と対策」で詳しく紹介します。

AIを狙ったサイバー攻撃にも注意が必要

AIセキュリティで考えるべきなのは、従業員が生成AIを安全に利用するための対策だけではありません。AIやLLM(大規模言語モデル)を組み込んだシステムが普及することで、AIの仕組みや特性を悪用した攻撃への備えも必要になっています。

プロンプトインジェクション

プロンプトインジェクションは、攻撃者が悪意のある指示をAIに与えることで、本来想定されていない動作や出力を引き起こそうとする攻撃です。ユーザーが直接入力する指示だけでなく、AIが読み込むWebページや文書などに悪意のある指示を埋め込む「間接プロンプトインジェクション」にも注意が必要です。外部の情報を参照するAIや、他のシステムと連携して処理を行うAIでは、影響範囲が広がる可能性があります。

センシティブ情報の漏洩

AIを組み込んだシステムでは、モデルが参照できる情報やユーザーの入力内容などが、意図せず出力される可能性があります。特に、社内文書や顧客情報などをAIから参照できるようにしている場合には、利用者の権限に応じて参照可能な情報を制御するなど、AIだけに依存しないアクセス制御が必要です。

データやモデルへの不正な操作

AIの動作は、学習データや外部から取得する情報などの影響を受けます。攻撃者によってデータが意図的に操作されれば、AIの判断や出力が影響を受ける可能性があります。AIが参照するデータの信頼性を確認するとともに、データへのアクセスや変更を適切に管理することが求められます。

AIに与える権限にも注意

AIエージェントなど、AIが外部サービスや社内システムと連携して処理を実行する仕組みでは、AIにどこまでの権限を与えるかが重要になります。必要以上の権限を付与すると、AIが意図しない操作を行った場合や攻撃者に悪用された場合の影響が大きくなります。人のアカウントと同様に、AIについても必要最小限の権限を設定し、重要な処理には人による確認を組み合わせることが重要です。

OWASPが示すLLMアプリケーションのリスク

LLMを利用したアプリケーションには、従来のWebアプリケーションと共通するリスクに加え、プロンプトインジェクションをはじめとしたLLM特有のリスクがあります。

OWASPでは、LLMや生成AIアプリケーションで特に注意すべきセキュリティリスクを整理しています。AIを組み込んだサービスを開発・提供する企業では、こうしたリスクを踏まえて、設計・開発・運用の各段階で対策を検討する必要があります。

具体的な脅威と対策については、「LLMセキュリティとは?プロンプトインジェクションなどの脅威と対策」で詳しく紹介します。

AIセキュリティ対策は「利用」と「システム」の両面から考える

ここまで見てきたように、AIセキュリティには、従業員による生成AIの利用に伴うリスクと、AIを組み込んだシステムそのものに対するリスクがあります。そのため企業では、利用ルールの整備だけでなく、ガバナンスや技術的なセキュリティ対策を組み合わせて取り組むことが必要です。

AI利用ルールを整備する

まず、従業員がどのような条件でAIを利用できるのかを明確にします。利用可能なAIサービスや用途、入力してはいけない情報、生成物を利用する際の確認方法などを定め、従業員が判断に迷わないルールにすることが重要です。また、AIサービスや利用方法は変化するため、一度ルールを作成して終わりにせず、利用状況に応じて見直していく必要があります。

AIガバナンスの体制を整備する

AIの利用を個々の従業員や部門だけに任せるのではなく、組織として管理する仕組みも必要です。誰がAI利用を管理するのか、どのようにリスクを評価するのか、問題が発生した場合にどの部門が対応するのかなど、役割と責任を明確にします。

AI利用ガイドラインの策定方法や組織としての管理体制については、「AIガバナンスとは?企業に必要な体制とAI利用ガイドラインの作り方」で詳しく紹介します。

シャドーAIを把握・管理する

ルールを整備しても、組織が把握していないAIサービスが利用されていれば、リスクを十分に管理できません。どの部門でどのようなAIが利用されているかを把握し、必要に応じて利用サービスを承認制にするなど、実際の利用状況とルールを一致させる取り組みが必要です。

AIを組み込んだシステムのセキュリティを確認する

AIを利用したシステムを開発・導入する場合には、通常のアプリケーションと同様のセキュリティ対策に加えて、AI・LLM固有のリスクも確認します。入力・出力の検証、アクセス制御、権限管理、APIや外部サービスとの連携、ログの記録などを確認し、プロンプトインジェクションをはじめとする攻撃への対策も検討します。

継続的なセキュリティ対策の見直し

AIを取り巻くサービスや技術、攻撃手法は変化しています。現在安全と判断した利用方法や設定であっても、将来も同じとは限りません。AIの利用状況や新たな脅威を定期的に確認し、ガイドラインやシステム設定、セキュリティ対策を継続的に見直していくことが重要です。

企業はAIセキュリティ対策をどこから始めるべきか

AIセキュリティといっても、すべての対策を一度に導入する必要はありません。まずは自社でAIがどのように使われているかを把握し、リスクの高い領域から優先して対策を進めます。

STEP1 AIの利用状況を把握する
利用しているAIサービス、利用部門、用途、取り扱う情報などを整理します。
STEP2 扱う情報とリスクを整理する
機密情報や個人情報など、AIで扱う情報と想定されるリスクを確認します。
STEP3 AI利用ガイドラインを整備する
利用可能なサービスや用途、禁止事項、生成物の確認方法などを定めます。
STEP4 技術的なセキュリティ対策を実施する
AIを組み込んだシステムについて、アクセス制御や権限管理、入出力の検証、脆弱性への対策などを行います。
STEP5 継続的に評価・改善する
利用状況や新たなリスクを確認し、ルールと技術対策を定期的に見直します。

AIの利用を一律に禁止するのではなく、どこにリスクがあるのかを把握したうえで、業務上のメリットと安全性のバランスを取りながら活用していくことが重要です。

AIセキュリティに関するよくある質問

▼ AIセキュリティとは何ですか?
▼ 生成AIを業務で利用する場合、どのようなリスクがありますか?
▼ AI利用ガイドラインには何を定めればよいですか?
▼ LLMにはどのようなセキュリティリスクがありますか?

まとめ

生成AIの普及によって、企業がAIを業務やシステムに取り入れる機会は広がっています。それに伴い、情報漏洩や誤情報、著作権などの利用上のリスクだけでなく、プロンプトインジェクションをはじめとするAI・LLMを狙った攻撃についても考える必要があります。AIセキュリティでは、AIを安全に利用することとAIを組み込んだシステムを安全にすることの両面から対策を進めることがポイントです。まずは自社でどのようにAIが利用されているかを把握し、AI利用ガイドラインや管理体制を整備するとともに、AIを組み込んだシステムについてはアクセス制御や権限管理、入出力の検証など、技術的な対策も進めていきましょう。

AIを取り巻く技術や脅威は変化しています。利用を一律に制限するのではなく、リスクを継続的に把握・評価しながら、安全なAI活用につなげていくことが重要です。


参考情報

公開日:2025年4月16日
更新日:2026年8月26日

編集責任:木下


BBSecでは

AIの利用拡大に伴い、企業を取り巻くIT環境やセキュリティリスクも変化しています。公開IT資産の把握、脆弱性の確認、セキュリティ対策の有効性検証など、自社の課題に応じた対策をご相談ください。


Security Serviceへのリンクバナー画像
BBsecコーポレートサイトへのリンクバナー画像
セキュリティ緊急対応のバナー画像

Security NEWS TOPに戻る
バックナンバー TOPに戻る

ゼロデイ脆弱性とは?最新事例と企業が取るべき対策を解説

Share
ゼロデイ脆弱性とは?最新事例と企業が取るべき対策を解説アイキャッチ画像

ゼロデイ脆弱性は、修正パッチが提供される前に悪用される極めて危険な脆弱性です。ChromeやFirefox、VPN機器など、企業で日常的に利用される製品でも継続的に確認されており、情報漏えいや業務停止につながるケースもあります。本記事では、ゼロデイ脆弱性の基本的な仕組みや実際の被害事例、従来対策が通用しにくい理由を整理しながら、企業に求められる現実的な対策について解説します。

ゼロデイ脆弱性が実際にどのように悪用されるのかについては、以下の記事で詳しく解説しています。
「世界で多発するゼロデイ攻撃とは?Apple・Google・Ciscoを襲った脆弱性の実態と対策」

本記事は2026年5月時点の情報をもとに作成しています。記載している脆弱性情報やCVE詳細は、公開後に内容が更新される場合があります。最新情報は各ベンダーおよびNVD・CISAの公式情報をご確認ください。

はじめに

ChromeやFirefoxなど、日常業務で広く使われている主要ブラウザでも、ゼロデイ脆弱性は繰り返し確認されています。ゼロデイ脆弱性とは、製品ベンダーや利用企業が十分な修正猶予を持てないまま悪用される、極めて危険度の高い脆弱性です。企業にとってゼロデイ脆弱性が厄介なのは、単に危険な脆弱性であるという点だけではありません。多くの場合、攻撃が確認された時点では、すでに悪用が始まっているか、修正パッチの適用が間に合っていない状態です。つまり、通常のパッチ管理や既知のマルウェア検知だけでは、防御が後手に回る可能性があります。 Webブラウザ、VPN機器、セキュリティ製品、業務アプリケーション、開発支援ツールなど、企業活動を支えるソフトウェアの多くは、常に外部との接点を持っています。そのため、ゼロデイ脆弱性は情報漏えい、業務停止、信用毀損、取引先への影響といったビジネスリスクに直結します。まず押さえたいのは、ゼロデイ脆弱性を悪用した攻撃に対し、完全に避けるのではなく、発生を前提に、侵入されにくく、侵入されても早期に検知し、被害を抑え込める体制を整えることです。

ゼロデイ脆弱性とは何か

ゼロデイ脆弱性とは、製品ベンダーや利用者がまだ十分に把握していない、または修正パッチが提供されていない脆弱性を指します。「ゼロデイ」という言葉は、攻撃者に悪用される可能性があるにもかかわらず、防御側に残された対応猶予が実質的にゼロ日であることに由来します。ここで整理しておきたいのが、「脆弱性」と「攻撃」は同じものではないという点です。脆弱性は、ソフトウェアやシステムに存在するセキュリティ上の欠陥です。一方で、ゼロデイ攻撃は、その未知または未修正の欠陥を悪用して、情報の窃取、権限昇格、不正コード実行、システム侵入などを行う攻撃行為を指します。NIST(米国立標準技術研究所)では、ゼロデイ攻撃を「これまで知られていなかったハードウェア、ファームウェア、ソフトウェアの脆弱性を悪用する攻撃」と定義しています。

たとえば、あるブラウザに不正なHTMLページを処理した際に任意のコード実行につながる欠陥があったとします。その欠陥自体がゼロデイ脆弱性であり、攻撃者が細工したWebページへ利用者を誘導して実際に悪用すれば、それがゼロデイ攻撃になります。CVEはこうした脆弱性を識別するための共通番号であり、NVD(米国国立脆弱性データベース)ではCVEプログラムについて、「特定のコードベースで確認された脆弱性を参照するための辞書、または用語集のような仕組みだ」と説明しています。

なぜゼロデイ脆弱性は危険なのか

ゼロデイ脆弱性が危険視される最大の理由は、修正パッチが存在しない、または広く適用される前に攻撃が始まることです。一般的な脆弱性対応では、ベンダーが脆弱性情報を公開し、修正パッチを提供し、企業が影響範囲を確認して適用するという流れになります。しかしゼロデイの場合、この順番が崩れます。攻撃者が先に脆弱性を把握し、攻撃に利用してから、ベンダーや利用者が気づくことがあるためです。もう一つの問題は、従来型のシグネチャ検知が効きにくいことです。シグネチャ型のセキュリティ対策は、既知のマルウェアや既知の攻撃パターンを検出するうえでは有効です。しかし、まだ十分に解析されていない攻撃コードや、新しい悪用手法に対しては、検知が遅れる可能性があります。NISTの関連文献でも、「ゼロデイ攻撃は未知の脆弱性を悪用するため従来のシグネチャ型検知では事前に攻撃シグネチャを用意できず有効性に限界がある*4」とされています。

ゼロデイ攻撃は、標的型攻撃にも使われやすい傾向があります。攻撃者にとって、未修正の脆弱性は価値の高い侵入口です。特に、ブラウザ、VPN、ファイアウォール、メールサーバ、リモートアクセス製品、エンドポイント管理製品などは、企業ネットワークの入口や重要な業務環境とつながっているため、攻撃が成功した場合の影響が大きくなります。 ビジネス面では、ゼロデイ脆弱性の悪用は情報漏えい、業務停止、顧客対応コストの増加、監督官庁や取引先への報告、ブランド信用の低下などに発展します。攻撃の起点が一台の端末や一つのWebアクセスであっても、その後に認証情報の窃取、横展開、機密情報の持ち出しが行われれば、被害は組織全体へ拡大します。

実際の被害事例

Google Chromeで相次いだゼロデイ脆弱性

ゼロデイ脆弱性の代表的な事例として、Google Chromeの脆弱性が挙げられます。Chromeは多くの企業で標準ブラウザとして利用されており、Webメール、SaaS、業務システム、クラウド管理画面などへのアクセスにも使われています。そのため、Chromeのゼロデイ脆弱性は、単なる個人利用者向けブラウザの問題ではなく、企業の業務端末リスクとして捉える必要があります。

2025年には、Chromeで悪用が確認されたゼロデイ脆弱性が複数回修正されました。BleepingComputerでは、2025年から2026年にかけてChromeは複数のゼロデイ脆弱性を修正したと報じています*2。2026年2月には、CVE-2026-2441が修正されました。NVDによれば、この脆弱性はChromeのCSSにおけるUse After Free(解放済メモリの再利用)の問題であり、 Google Chrome 145.0.7632.75より前のバージョンでは、細工されたHTMLページを介してリモート攻撃者がサンドボックス内で任意のコードを実行できる可能性がありました。GoogleのChrome Releasesでも、この脆弱性について「実際に悪用が確認されている」旨が記載されています。2026年3月には、CVE-2026-3909とCVE-2026-3910が修正されました。CVE-2026-3909は「Skia(Chromeが使用するグラフィック処理ライブラリ)における境界外の書き込み」で、細工されたHTMLページを介して境界外メモリアクセスにつながる可能性があります。CVE-2026-3910は「V8(ChromeのJavaScript実行エンジン)における不適切な実装」で、細工されたHTMLページを介してサンドボックス内で任意のコード実行が可能となるおそれがありました。GoogleはCVE-2026-3910について、「実際に悪用が確認されている」と公表しています。また、2026年3月末にはCVE-2026-5281も修正されています。NVDによれば、これはChromeのDawnにおける解放済メモリの再利用の脆弱性で、レンダラープロセスが侵害された状態で、細工されたHTMLページを通じて任意のコード実行につながる可能性があるものです。Googleはこの脆弱性についても、「実際に悪用が確認されている」と公表しています。

これらの事例が示しているのは、Webブラウザが単なる閲覧ツールではなく、企業ネットワークへの入口になり得るということです。利用者が業務中にWebサイトを閲覧する、SaaSへアクセスする、メール内のリンクを開くといった日常的な操作が、ゼロデイ攻撃のきっかけになる可能性があります。

OpenAI Codexに関するサンドボックス迂回の事例

近年は、開発支援ツールやAI関連ツールもゼロデイリスクの対象になっています。Zero Day Initiativeは2026年4月、OpenAI Codexに関するZDI-26-305を公開しました*3。この脆弱性は、影響を受けるOpenAI Codex環境においてサンドボックスを迂回できる可能性があるものとされ、攻撃には、「標的ユーザーが悪意あるJavaScriptを含むリポジトリをCodexで処理する必要がある」と説明されています。OpenAI Codex CLIでは2025年にも、サンドボックス設定ロジックの問題により、意図したワークスペース境界を迂回し、Codexプロセスが権限を持つ範囲で任意のファイル書き込みやコマンド実行につながる可能性がある脆弱性が、GitHub Security Advisoryで公開されています*4。この問題はCodex CLI 0.39.0で修正され、利用者には更新が推奨されています。

この事例から分かるのは、ゼロデイ脆弱性がOSやブラウザだけの問題ではないということです。開発者が利用するCLIツール、AIエージェント、コード生成支援ツール、CI/CD環境も、企業の重要な攻撃面になりつつあります。特に、ソースコード、認証情報、クラウド設定、APIキーにアクセスする可能性があるツールでは、サンドボックスや権限管理を過信しない運用が必要です。

ゼロデイ攻撃の仕組み

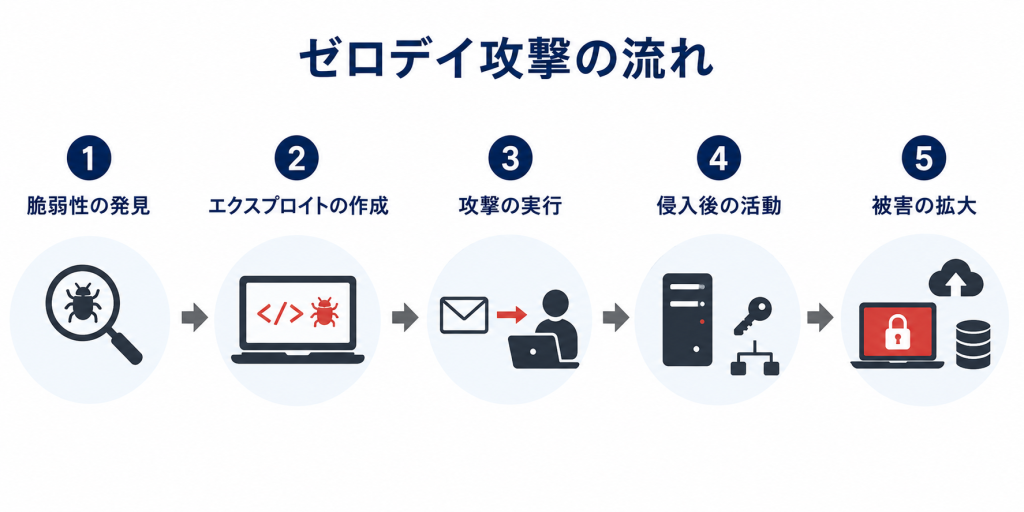
ゼロデイ攻撃の流れ概要図

※ゼロデイ攻撃では、脆弱性公開前や修正前に攻撃が始まるため、従来型のシグネチャ検知だけでは防御が難しい場合があります。

ゼロデイ攻撃は、脆弱性の発見から攻撃実行までが非常に速い場合があります。攻撃者は、ソフトウェアの不具合を独自に発見することもあれば、脆弱性情報が闇市場や限定的なコミュニティで売買されることもあります。その後、攻撃者はその脆弱性を悪用するエクスプロイトコードを作成し、標的組織に対して攻撃を実行します。まず、未公開または未修正の脆弱性が発見されるところから始まります。次に、その脆弱性を悪用するための攻撃コードが作成されます。ブラウザの脆弱性であれば、細工されたHTMLページやJavaScriptが使われることがあります。VPNや外部公開サーバの脆弱性であれば、インターネット越しに直接攻撃が行われることもあります。攻撃が成功すると、攻撃者は端末やサーバへ侵入し、認証情報の取得、権限昇格、内部ネットワークへの横展開を試みます。その後、機密情報の収集、データの持ち出し、ランサムウェアの展開、バックドア設置などへ進む可能性があります。

ゼロデイ攻撃の基本的な仕組みについては、以下の記事でも詳しく解説しています。
「世界で多発するゼロデイ攻撃とは?Apple・Google・Ciscoを襲った脆弱性の実態と対策」

従来対策が通用しない理由

ゼロデイ脆弱性への対応で難しいのは、従来のセキュリティ対策が必ずしも十分に機能しないことです。もちろん、ウイルス対策ソフト、ファイアウォール、パッチ管理、メールセキュリティ、URLフィルタリングといった対策は今でも重要です。しかし、ゼロデイ攻撃では、これらをすり抜ける可能性があります。シグネチャ型対策は、既知の攻撃には強い一方で、未知の攻撃には限界があります。攻撃コードが新しく、まだ検体や攻撃パターンが共有されていない場合、検知ルールが存在しないことがあります。さらに、攻撃者は正規のWeb通信、正規のプロセス、正規の認証情報を利用して侵入後の活動を行うため、外形上は通常の業務通信に見えることもあります。また、境界防御だけに依存した対策では対応が難しいケースも増えています。クラウドサービスやリモートワークの拡大により、従来の「社内は安全」という前提だけでは、ゼロデイ攻撃のような未知の脅威への対応が難しくなっています。ゼロデイ攻撃では、社内端末、クラウドアカウント、開発端末、外部公開資産のどこからでも侵入口が生まれる可能性があります。

ゼロトラストの考え方を含め、従来型セキュリティ対策の課題については、こちらの記事でも詳しく解説しています。
「ゼロトラストセキュリティ -今、必須のセキュリティモデルとそのポイント-」

ゼロデイ脆弱性への対策

ゼロデイ脆弱性への対策では、未知の攻撃を完全に防ぐことだけでなく、侵入後の被害を最小限に抑えるアプローチが重要です。ゼロトラストに基づく権限管理や多要素認証に加え、EDRやXDRによる侵入後の検知、ASMによる攻撃面の把握、SOCによる継続監視などを組み合わせた多層的な対策が求められます。

ゼロデイ攻撃対策を支援するBBSecのアプローチ

ゼロデイ攻撃へ備えるには「脆弱性情報を知ること」だけでなく、「自社がどの製品を利用しているのか」「どこが外部公開されているのか」を知ることで自社環境への影響を迅速に把握し、継続的に監視・対応できる体制を持つことが重要になります。

ブロードバンドセキュリティ(BBSec)では、EDR-MSSによる侵入後の検知・対応、G-MDRによる高度な脅威分析、ASMによる攻撃面の可視化を通じて、企業のゼロデイ対策を支援しています。ゼロデイ脆弱性への備えを強化したい方は、以下のサービスページもあわせてご覧ください。

ASM(アタックサーフェス管理)の考え方や、攻撃面を継続的に把握する重要性については、こちらの記事でも詳しく解説しています。
「脆弱性管理とIT資産管理 -サイバー攻撃から組織を守る取り組み-」

まとめ

ゼロデイ脆弱性は、主要ブラウザやVPN機器、業務ソフトウェアなど、企業が利用するさまざまな環境で発生する可能性があります。ゼロデイ攻撃による被害を抑えるためには、パッチ管理だけでなく、ゼロトラストに基づく権限管理、EDRやXDRによる侵入後の検知、ASMによる攻撃面の把握、SOCによる継続監視などを組み合わせた多層的な対策が求められます。

【参考情報】


ウェビナー開催のお知らせ

  • 2026年6月3日(水)14:00~15:00「金融機関の対応事例に学ぶPQC移行の進め方と実務ポイント」
  • 2026年6月10日(水)14:00~14:30「Webサイトの見えない脅威を可視化する 外部タグ・サードパーティースクリプトの監視対策」
  • 最新情報はこちら


    年二回発行されるセキュリティトレンドの詳細レポート。BBSecで行われた診断の統計データも掲載。

    サービスに関する疑問や質問はこちらからお気軽にお問合せください。


    Security Serviceへのリンクバナー画像
    BBSecコーポレートサイトへのリンクバナー画像
    セキュリティ緊急対応のバナー画像

    編集責任:木下

    Security NEWS TOPに戻る
    バックナンバー TOPに戻る

    Claude Code流出問題の全体像 ―事件からわかるAI開発リスクとサプライチェーンリスク―

    Share
    「Claude Code流出問題の全体像 ―事件からわかるAI開発リスクとサプライチェーンリスク―」アイキャッチ画像

    はじめに

    「Claude Code」で起きたソースコード流出問題の経緯、なぜnpm公開物から内部ソースへ到達できたのか、何が漏れ、何が漏れていないのかを整理します。またソースコード流出によって浮き彫りになるAI開発リスクとソフトウェア供給網のリスクについても解説します。

    Claude Codeソースコード流出の概要

    「Claude Code」はAnthropic社が提供する公式のコーディング支援ツールです。Anthropicが公開している「Claude Code Doc」の中でも、Claude Codeはコードベース理解、ファイル編集、コマンド実行、各種開発ツール連携を行う製品として説明されています。

    Claude Code流出は、単なる「話題のAIニュース」では終わりません。今回、ターミナルやIDE(統合開発環境)からコード編集、コマンド実行、検索、Git操作まで担う実運用の開発基盤の中核にあたる実装の一部が、npm配布物に含まれたソースマップ(source map)を起点に外部から参照可能な状態になっていたことがわかりました。本事件はAIエージェント時代のソフトウェアサプライチェーン問題として捉える必要があります。

    流出の発端と技術的な経路(source map問題)

    本事件で最初に押さえるべきなのは、「Claude本体のモデル重みが漏れた」のではなく、「Claude Codeという周辺プロダクトのソースコードが到達可能になった」という点です。事件の発端となったのは、Chaofan Shou氏(@Fried_rice)によるXの投稿です。2026年3月31日、Chaofan Shou氏は「Claude code source code has been leaked via a map file in their npm registry」(訳:Claude Codeのソースコードが、npmレジストリ内のmapファイルを通じて流出した)と投稿しており、少なくとも現時点で公開されている初動情報の起点は、この発見報告にあると考えられます。

    その後に作成されたいくつかの公開GitHubリポジトリでは、漏洩経路について「npmパッケージに含まれたソースマップが、難読化前のTypeScriptソースを指しており、その参照先からsrc一式を取得できた」と説明しています。GitHubリポジトリ自体はAnthropicの公開情報ではないため、そこに書かれた全内容を鵜呑みにするべきではありませんが、少なくとも複数の公開Claude Artifacts(アーティファクト)が同じ経路を示していること、そして後述するAnthropic公式のGitHub上のIssueでも「流出またはデコンパイルされたClaude Codeのソースコード」を前提に議論が進んでいることから、ソースマップ起点として内部実装が可視化されたという大筋は相当に確度の高い情報だと言えます。さらに公開リポジトリのREADMEでは、「約1,900ファイル、51万行超のTypeScriptコードが露出した」と説明しています。

    流出した内容と影響範囲

    本事件が注目を集めた理由は、Claude Codeが単なるCLIラッパーではなく、幅広い機能群を内包したAI開発支援基盤であるためです。Anthropicの公開リポジトリと公式リリースノートを見るだけでも、Claude CodeにはIDE連携、MCP、プラグイン、履歴再開、権限管理、Web検索、各種設定や運用補助機能が継続的に追加されていることがわかります。また公開GitHubスナップショットREADMEでも、ツールシステム、コマンド群、IDEブリッジ、マルチエージェント協調、スキル、プラグイン、メモリやタスク管理など、多層的な構造が記述されています。

    つまり今回のClaude Code流出問題は、AIコーディング支援の表面だけでなく、その実装思想や運用機能の一端まで外から読める状態になったという意味を持ちます。

    何が漏れ、何が漏れていないのか

    Anthropic公式情報でも、Claude Codeの内部実装に関するソースコード断片や構成が公開状態になったことは裏づけられています。Anthropic公式GitHubのIssueでも、流出コードを前提とした解析が行われていました。

    Anthropicの公式GitHubリポジトリに2026年3月31日付で立てられたIssueでは、「source code isn’t publicly available, so this analysis is based on the leaked/decompiled Claude Code source」(訳:ソースコードは公開されていないため、本分析は流出またはデコンパイルされたClaude Codeのソースコードに基づく)と投稿され、Xでの発見報告とGitHub上の流出スナップショットを参照していたということがわかります。つまり、少なくともコミュニティ側では流出コードを参照した解析が現実に行われ、それがAnthropicの管理下のIssue空間にも持ち込まれていたということです。

    一方で、複数の報道機関によれば、「Anthropicが今回の件を「人為的ミス」によるものと認め、顧客データや認証情報、Claudeモデルそのものの重みは流出していない」と説明したとしていますが、この点は一次ソースではなく報道ベースの情報として慎重に扱う必要があります。

    なぜ深刻なのか:AIエージェント時代のリスク

    それでも、このClaude Codeソースコード流出が深刻なのは、顧客データ漏洩の有無だけでは影響範囲が測れないからです。AIエージェント製品では、モデル重みそのものに価値があるのはもちろんですが、実際の使い勝手や競争力は、その周囲にあるハーネス、権限管理、ツール呼び出し、コンテキスト処理、UI、IDE統合、再開機能、運用設計によって大きく左右されます。公開スナップショットにあるディレクトリ構成やコマンド一覧、サービス層の説明を見ると、Claude Codeがかなり成熟した「製品化されたAIエージェント」であることが読み取れます。競合や研究者にとって、こうした実装知見が外から見える状態になることの意味は小さくありません。

    特に重要なのは、Claude Codeが単にコードを生成するAIだけではなく、ローカル環境や周辺ツールに触れながら作業を進めるAIエージェントとして設計されている点です。漏洩したとされる公開スナップショットにも、Bash実行、ファイル読み書き、Web取得、Web検索、MCP、LSP、タスク作成、スケジュール実行などの機能が列挙されています。これは、今後のAIセキュリティを考える際に、モデル単体の安全性だけでは足りず、エージェントの実行基盤や配布パッケージの安全性まで視野に入れなければならないことを示しています。

    AIエージェント時代の新課題、Non Human Identity(NHI)のセキュリティ課題と今後のAIコーディングに求められる実践的な視点を解説した記事はこちら。ぜひあわせてご覧ください。
    AIコーディング入門 第5回:NHI(Non‑Human Identity)とAIエージェントのセキュリティ課題

    ビルド・配布プロセスにおける問題の本質

    さらに今回の一件は、ソースコード流出そのものだけでなく、公開物のビルド管理や配布管理の問題としても重要です。ソースマップ(source map)は本来、デバッグや解析のためには有用ですが、公開パッケージに不用意に含めれば、難読化やバンドルの前提を崩し、実装内部への入口になります。もしREADME記載どおり、ソースマップが外部ストレージ上の元ソース一式を指していたのであれば、問題は単なる「mapファイル混入」で終わりません。公開パッケージ、参照先URL、ストレージ公開設定、リリース工程のチェック体制まで含めた、供給網全体の設計ミスになります。ここにClaude Codeソースコード流出問題の本質があります。

    「影響は限定的」という見方の限界

    本事件をめぐる議論では、「どうせAIのコードはすぐ変わるから被害は限定的だ」という見方もあります。これは半分正しいです。たしかにプロダクトコードは日々更新されます。それでも、ある時点の設計方針、抽象化の仕方、権限制御、内部機能のつながり、未公開機能の痕跡は、競争戦略や攻撃面の理解に十分な価値を持ちます。現に公開スナップショットには、マルチエージェント協調、チーム作成、スキル実行、メモリ同期、リモートトリガーといった、単純なCLI以上の発想が読み取れる記述が含まれています。AI開発企業にとって、こうしたプロダクト実装の漏えいは、顧客情報漏えいとは別種の経営リスクです。

    企業が取るべき対応と実務上の教訓

    企業の情報セキュリティ担当者や開発責任者にとって、本事件から学ぶべき教訓は明確です。第一に、公開パッケージの中身を「本番ビルド成果物」だけでなく、「付随ファイル」まで含めて検査する必要があります。第二に、ソースマップやデバッグアーティファクトの扱いを、開発者の善意や慣習に任せてはいけません。第三に、クラウドストレージの参照先や署名URL、生成物の格納ルールを、CI/CDと一体で見直すべきです。第四に、AIエージェント製品では、モデルAPIの保護だけでなく、CLI、IDE拡張、SDK、プラグイン、MCP連携のような周辺面を含めてセキュリティレビューをかける必要があります。Claude Codeの公式リリースノートを見るだけでも、製品は短い周期で多機能化しており、変化の速さ自体がリスク管理を難しくしています。

    もう一つ重要なのは、事故後の透明性です。現時点で確認できるAnthropic公式情報は、Claude Codeの製品説明やリリースノートが中心で、今回のソースコード流出事件についての障害報告書は見当たりません。そのため、実務的には「発生原因」「影響範囲」「再発防止策」を公式にどこまで明文化するかが、今後の信頼回復を左右します。AI安全性を強く掲げる企業であればなおさら、モデル安全だけではなく、配布と運用の安全性でも説明責任が問われます。今回のClaude Codeのソースコード流出は、その現実を突きつけた出来事となります。

    まとめ

    Claude Codeソースコード流出事件はAI本体が破られた事件ではありませんが、AI製品はモデルだけ守ればよい、という幻想は崩されました。AIコーディング支援、AIエージェント、開発者向けCLI、IDE統合、MCP、プラグイン基盤といった要素が一体化した時代において、情報漏洩リスクはモデル重みだけでなく、配布物、周辺コード、実行制御、設定、公開ストレージにもまたがります。Claude Code流出事件を単なる興味本位の話題で終わらせるのではなく、現代のソフトウェアサプライチェーンの課題とAIプロダクト運用の脆さを示す事例として読むべきでしょう。

    参考文献


    サイバーインシデント緊急対応

    セキュリティインシデントの再発防止や体制強化を確実に行うには、専門家の支援を受けることも有効です。BBSecでは緊急対応支援サービスをご提供しています。突然の大規模攻撃や情報漏洩の懸念等、緊急事態もしくはその可能性が発生した場合は、BBSecにご相談ください。セキュリティのスペシャリストが、御社システムの状況把握、防御、そして事後対策をトータルにサポートさせていただきます。

    サイバーセキュリティ緊急対応電話受付ボタン
    SQAT緊急対応バナー

    ウェビナー開催のお知らせ

  • 2026年4月10日(水)14:00~15:00
    「ランサムウェア時代のIT-BCP入門~サイバー攻撃によるシステム停止に備える実践的な策定ステップ~」
  • 2026年4月15日(水)14:00~15:00
    「AI時代のサイバー脅威最前線 ― IPA『情報セキュリティ10大脅威2026』から学ぶ防御戦略 ―」
  • 2026年4月22日(水)14:00~15:00
    「Swift CSCF v2026変更点解説セミナー ― Control 2.4 (Back Office Data Flow Security)の必須化とCustomer client connectorへの要件適用拡大 ―」
  • 最新情報はこちら

    編集責任:木下

    Security NEWS TOPに戻る
    バックナンバー TOPに戻る


    資料ダウンロードボタン
    年二回発行されるセキュリティトレンドの詳細レポート。BBSecで行われた診断の統計データも掲載。
    お問い合わせボタン
    サービスに関する疑問や質問はこちらからお気軽にお問合せください。

    Security Serviceへのリンクバナー画像
    BBsecコーポレートサイトへのリンクバナー画像
    セキュリティ緊急対応のバナー画像

    AIコーディング入門 番外編:オープンソースソフトウェアのサプライチェーン攻撃とタイポの落とし穴

    Share

    Security NEWS TOPに戻る
    バックナンバー TOPに戻る

    AIコーディング入門番外編アイキャッチ画像(OSSのサプライチェーン攻撃)

    AIを活用したコーディングが普及する一方で、オープンソースソフトウェア(OSS)を狙ったサプライチェーン攻撃が増加しています。特に、開発者のタイポを悪用する「Typosquatting」や、AIのハルシネーションに便乗する「Slopsquatting」といった手法は、身近で深刻な脅威です。本記事では、実例を交えながらその仕組みとリスクを解説し、安全なAIコーディングを実践するためのポイントを紹介します。

    コードを書く人やインフラストラクチャの構築をする人ならば、人生で最低でも一度は経験しているであろうこと、それはタイプミス、いわゆるタイポ(typo)ではないでしょうか。タイポ、些細なミスで、日常的に発生するものなのですが、中には重大なものもあります。

    タイプミスが招く落とし穴 ─ Typosquattingとは

    皆さんは「タイポスクウォッティング」という言葉をご存じでしょうか。Web関連のお仕事をされている方であれば、URLのタイポスクウォッティング、つまり間違いやすい・紛らわしいURLでユーザーをおびき寄せる手法としてのタイポスクウォッティングをご存じの方も多いかと思います。この手法がオープンソースソフトウェアでも昨今使用されるようになっています。

    例えばnpmの場合、

    npm install package_name

    と入力することでパッケージのインストールを実行できます。インストールしたパッケージは例えばjavascript(react)を利用している環境であれば

    import {
    コンポーネント名
    } from “@/fullpath/to/package_name”;

    の形でコードの先頭で利用するパッケージ名を宣言します。

    世の中にはこのパッケージ名のよくあるタイプミス(typo)を狙って作られたマルウェアの一種が存在します。そんなマルウェア、何のためにあるのだろうという方も多いと思いますが、例えば暗号資産のウォレットを狙ったマルウェアや、システムへの侵害目的のマルウェアなどが最近では話題になっています。

    npmやPythonなどOSSでの事例

    暗号資産を狙うマルウェアの脅威

    暗号資産を狙ったマルウェアについては偽の採用面接中に実行を求められるケースも報告されています。

    Socket,[Another Wave: North Korean Contagious Interview Campaign Drops 35 New Malicious npm Packages](https://socket.dev/blog/north-korean-contagious-interview-campaign-drops-35-new-malicious-npm-packages)

    偽の採用プロセスとソーシャルエンジニアリング

    採用面接に至るということは例えば採用条件面で魅力的である、採用プロセスに見せかけたフェーズで偽の採用者に対して高い信頼を持つよう誘導されている、著名な企業などに成りすますことで権威性・信憑性を信じさせられる、オンライン環境による信頼レベルを悪用される、といったソーシャルエンジニアリングの基本ともいえる「人」が抱える脆弱性をすでに悪用された状態です。

    関連記事:
    「ソーシャルエンジニアリング最前線【第1回】ソーシャルエンジニアリングの定義と人という脆弱性」(https://www.sqat.jp/kawaraban/37089/)

    その状態で、面接というストレスのかかる、失敗が許されないと思ってしまう状況で紛らわしい名称の不正なコードや、不正なパッケージを含むコードを実行させられた場合、気づくことは容易ではありません。面接で突然コードを実行させられることに違和感を覚えてその場を退出することが最善かもしれませんが、Zoomのリモートコントロール機能を使ってマルウェアを実行するケースもあることから、特にすべてをオンラインで完了させるタイプの採用プロセスそのものに対して常に疑わしいかどうか疑問を持ち続けるしか対策はないかもしれません。

    Zoomのリモートコントロール攻撃

    参考情報:

    The Trail of Bits Blog,[Mitigating ELUSIVE COMET Zoom remote control attacks](https://blog.trailofbits.com/2025/04/17/mitigating-elusive-comet-zoom-remote-control-attacks/)

    なお、昨年末に警察庁・内閣サイバーセキュリティセンター・金融庁連名で偽の採用試験関連で注意喚起が出ています。今一度ご確認ください。

    警察庁/内閣サイバーセキュリティセンター/金融庁「北朝鮮を背景とするサイバー攻撃グループ TraderTraitor によるサイバー攻撃について (注意喚起)」(令和6年12月24日)(https://www.npa.go.jp/bureau/cyber/pdf/20241224_caution.pdf)

    タイポよりも怖い?生成AI時代の新たな罠 ─ Slopsquatting

    生成AIやAIエージェントの普及でAIを使用したコーディングを行う人も増えていると思います。「typoもないし、いいじゃない?」と思う方も多いと思いますが、生成AIには「ハルシネーション」という最大の難点があります。人間のtypoぐらいの頻度で遭遇する現象の一つといっても言い過ぎではないかもしれません。そんなハルシネーションを狙って、偽のパッケージが用意されていたら?という内容のレポートが公開されました。

    参考情報:

    トレンドマイクロ株式会社「スロップスクワッティング:AIエージェントのハルシネーションにつけ込む攻撃手法」(https://www.trendmicro.com/ja_jp/research/25/g/slopsquatting-when-ai-agents-hallucinate-malicious-packages.html)

    生成AI単体には生成内容の検証メカニズムがありません。このため、AIエージェントを利用したコーディングの場合はエージェント側の機能として備わっている検証機能を利用することが必要です。具体的な手法はレポートにも記載がありますが、日進月歩で新たな機能が登場する現状では最新の情報も併せて探すことをお勧めします。 また、エージェントを用いない場合も含めて、以下のようなリスク回避策を基本とするのもよいかもしれません。

    • 参照するパッケージ・モジュールを限定して、typosquattingやslopsquattingなどのリスクを回避する
    • やむを得ず新しいパッケージ・モジュールをインストールする場合は人の手を介したチェックを行うことで、リスクを抑制する

    実際に筆者もプロンプトで利用パッケージを限定していますが、特に利便性の阻害を感じたことはありません。また、周囲とのコミュニケーションでパッケージ・モジュールの情報の交換、推奨などの情報を得ることも多くあり、AI時代のコーディングとはいえコミュニケーションも併せて重要であることを実感しているところです。

    プロンプトエンジニアリングと検証の重要性

    前出のレポートで指摘されている原因の一つにはプロンプトの一貫性やあいまいさといった自然言語による指示ならではの問題があります。プロンプトエンジニアリングなどについては以下の記事でもご紹介しています。ただし、モデル側の実装状況などによりユーザー側の努力の反映には限界があるため、必ず生成結果に対する人のチェック(一種のHuman in the Loop)はプロセスとして欠かさないことが望まれます。

    関連記事:
    「AIコーディング入門 第1回:Vibeコーディングとプロンプトエンジニアリングの基礎」(https://www.sqat.jp/kawaraban/38067/)

    正規リポジトリの乗っ取りという最大の脅威

    2025年7月、npmの開発者をターゲットにしたフィッシングが報告されました。この後、複数のパッケージの乗っ取りが報告されています。

    npm開発者を狙ったフィッシング事例

    オープンソースソフトウェア(OSS)経由のサプライチェーン攻撃

    ここまででお気付きの方も多いと思いますが、今回取り上げた様々な攻撃手法はすべてオープンソースソフトウェア経由のサプライチェーン攻撃として、1つにまとめることができます。プログラミング言語の多く、そしてWebサイトの構築に用いられるJavaScriptのフレームワークの多くはオープンソースソフトウェアとして流通しています。プログラミング言語やJavaScriptのフレームワークは実際に利用するにあたって利便性を向上させる目的で多くのパッケージやモジュール、ライブラリなどがオープンソースとして開発・公開されています。これらのオープンソースソフトウェアは現在では多くが多数のコントリビューターとメンテナーによってGitHub上で公開され、開発が行われています。GitHubからnpmなどのパッケージ管理システムへの公開も一貫して行うことができるため、非常に利便性が高い反面、今までに挙げたような攻撃を仕掛けるための利便性も高くなっています。また、オープンソースソフトウェアは相互に依存性を持つことが多いことから、人気のあるモジュール・パッケージへの攻撃が多数のモジュール・パッケージやシステムへ影響を及ぼすことができます。これが、オープンソースソフトウェアへのサプライチェーン攻撃における最大の特徴ともいえるかもしれません。オープンソースソフトウェアを利用する以上、こういったリスクがあることは十分理解したうえで利用する必要があります。

    オープンソースソフトウェアの利用の条件としてセキュリティ面でかなりハードルが高いのは事実ですが、一方で利便性・柔軟性・モダンなシステムの構築といった観点からオープンソースソフトウェアを全く利用しない(プロプライエタリソフトウェアだけで構築する)というのは難しいという現状に鑑みるとやむを得ない選択であるとも言えます。

    開発者がとるべき対策

    こういったケースに対応するには依存関係のチェックや追跡、SBOMによる管理が必要になります。依存関係のチェックや追跡にはGitHubを使用している場合ならばDependabotの利用、その他のコードレポジトリを対象とする場合は各種の依存関係トラックツールを使用する必要があります。SBOMで自身のコードのコンポーネントと依存関係の管理を合わせて行うことで、システム全体としての管理を行うことが求められます。

    まとめ ― AI時代のオープンソースソフトウェア利用に求められる視点

    タイプミスを悪用した Typosquatting、AIのハルシネーションに便乗する Slopsquatting、さらには正規リポジトリの乗っ取りといった攻撃は、いずれもオープンソースソフトウェアを媒介とするサプライチェーン攻撃として位置づけられます。これらは利便性と引き換えに大きなリスクを伴い、暗号資産の窃取やシステム侵害といった深刻な被害へとつながりかねません。OSSの依存関係は複雑で、人気パッケージが狙われることで広範囲に影響が及ぶことも少なくありません。そのため、参照パッケージを限定する運用、人による確認(Human in the Loop)、Dependabotなどの依存関係管理ツールの活用、SBOMによる包括的なコンポーネント管理 といった対策が不可欠です。AIを活用したコーディングが普及する中でも、「便利だから任せる」のではなく、常に検証と疑問を持ち続ける姿勢 が求められます。セキュリティと利便性の両立こそが、これからのOSS利用とAI開発における鍵といえるでしょう。


    Security NEWS TOPに戻る
    バックナンバー TOPに戻る

    ウェビナー開催のお知らせ

  • 2025年9月24日(水)12:50~14:00
    「製造業・自動車業界のためのサプライチェーン対策 -攻撃事例から学ぶ企業を守るセキュリティ強化のポイント-」
  • 2025年10月1日(水)13:00~14:00
    「2025年10月Windows10サポート終了へ 今知るべきサポート切れのソフトウェアへのセキュリティ対策ガイド」
  • 2025年10月8日(水)14:00~15:00
    「ソースコード診断で実現する安全な開発とは?脆弱性対策とDevSecOps実践」
  • 最新情報はこちら


    資料ダウンロードボタン
    年二回発行されるセキュリティトレンドの詳細レポート。BBSecで行われた診断の統計データも掲載。
    お問い合わせボタン
    サービスに関する疑問や質問はこちらからお気軽にお問合せください。

    Security Serviceへのリンクバナー画像
    BBsecコーポレートサイトへのリンクバナー画像
    セキュリティ緊急対応のバナー画像

    AIコーディング入門
    第6回:AIエージェントのセキュリティ対策と今後の展望

    Share

    Security NEWS TOPに戻る
    バックナンバー TOPに戻る

    AIコーディング入門アイキャッチ(AIエージェントのセキュリティ対策と展望)

    AIエージェントは従来のアプリケーションとは異なる特性を持ち、セキュリティ対策も新しい技術との統合が求められます。次世代の手法を取り入れることで、未知の脅威に対応し信頼性を確保するアプローチが検討されています。「AIコーディング入門」の最終回では、AIエージェントを取り巻くセキュリティ対策について解説します。

    ※本稿は2025年7月上旬に執筆しているものです。ご覧いただく時期によっては古い情報となっている場合もありますので、ご承知おきください。

    AIエージェントとセキュリティの新たな課題

    AIエージェントのセキュリティ対策には新しい技術の適用も必要となります。例えば前回「第5回:NHI(Non‑Human Identity)とAIエージェントのセキュリティ課題」の表3:ポストゼロトラストアプローチでご紹介したエフェメラル認証には量子耐性暗号が必要となりますし、AIエージェントが一貫したセキュリティポリシーを維持しながら複数システム間で動作できるアイデンティティのフェデレーション、入出力の異常や悪意のある動作の検知のための継続的監視など、次世代のセキュリティ技術との統合アプローチも検討されています。

    表1:AIエージェントセキュリティと新規技術の統合

    技術領域統合方法期待効果
    量子耐性暗号エフェメラル認証は量子耐性アルゴリズムやゼロ知識証明などの新興技術と共に進化する可能性将来の暗号解読攻撃への対応
    アイデンティティ連合(Identity Federation)AIエージェントが一貫したセキュリティポリシーを維持しながら複数システム間で動作できるアイデンティティ連合機能マルチクラウド・ハイブリッド環境での統一セキュリティ
    解釈可能AI説明可能AIシステムによる透明で理解可能な意思決定プロセスAIエージェントの行動予測性と信頼性向上
    継続的監視AI システムの入力と出力の異常または悪意のある動作を監視し、脅威検出のためにAI行動分析を適用リアルタイム脅威検出と対応
    形式的検証ニューラルネットワークの敵対的堅牢性を証明するSMTソルバーや抽象解釈技術の活用数学的に証明可能なセキュリティ保証
    フェデレーテッドラーニング対策ビザンチン耐性集約ルールによるモデルポイズニング攻撃の防御分散学習環境での信頼性確保
    出典:次のソースより弊社にて翻訳、編集,Cloud Security Alliance “Agentic AI Identity Management Approach | CSA ” (Ken Huang, 2025),DHS ” Safety and Security Guidelines for Critical Infrastructure Owners and Operators ” (2024),NIST AI 100-2e2025 ” Adversarial Machine Learning: A Taxonomy and Terminology of Attacks and Mitigations” (2025)

    まとめ

    ここまででまとめてきた通り、Agenticコーディングの一要素であるAIエージェントにはすでに多くのセキュリティ課題が存在していることが知られています。また、様々な対策の検討も進んでいます。AIによるコーディングそのものにも課題があり、エージェントについてもエージェントそのものの課題に加えてエージェントとアプリケーション間、マルチエージェント間のプロトコルの仕様及び実装上のセキュリティ課題が存在します。さらに、従来型のAppSec寄りのセキュリティアプローチはAIエージェントのセキュリティ対策としては不十分であることもご説明した通りです。今までにないエンティティであるAIエージェントに対して、セキュリティ対策も今までにない技術を取り入れて進んでいくことは間違いないところでしょう。AIエージェントをサービスの一つとして利用する、またはAIエージェントを自社サービス向けに開発する場合、現在進行形で新しい課題や新しい対策が次々に現れてくる状況であることを認識しながら、適時判断と対応ができる体制をまずは整えることが重要ではないでしょうか。また、今後導入を検討される場合はAIやAIエージェントのメリットを十分に生かしつつ、利用中に新しく提供されるセキュリティ対策や新しいセキュリティポリシー、セキュリティアプローチといったものを柔軟に受け入れて消化していけることも重要になるでしょう。

    今までのAppSecとは全く異なるもの、それがAIエージェントであり、今までのコーディングと全く異なるものがAgenticコーディングなのです。

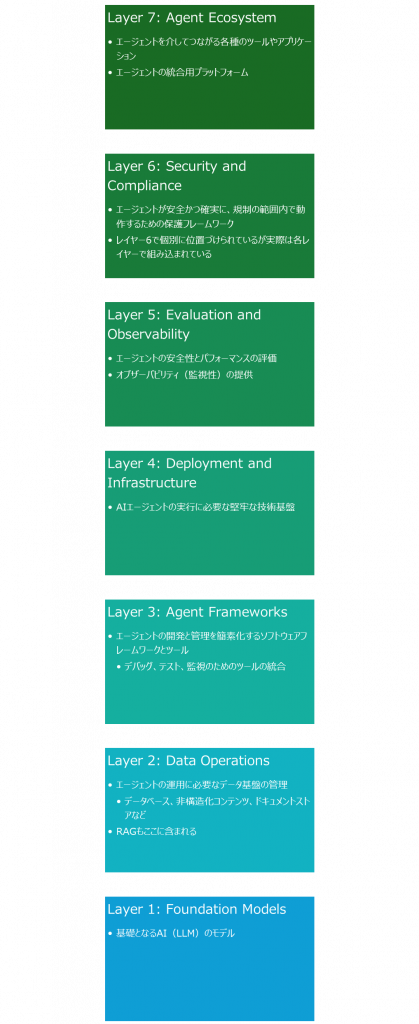
    付録: マルチエージェントの脅威モデリング:MAESTROとは

    最後に、「第4回:MCPの脆弱性とA2A脅威分析から学ぶセキュリティ実装」でご紹介した、A2Aプロトコルのセキュリティ上の課題の際に触れた、マルチエージェント環境の脅威モデリングであるMAESTROについて解説します。

    図1:MAESTROの7レイヤ アーキテクチャ

    MAESTROの7レイヤ アーキテクチャ

    OWASPが定義したMAESTROについて解説された記事をもとに記載しています。

    MAESTROモデリングはマルチエージェント環境の複雑な環境・エコシステムを評価する目的でOWASPが定義した脅威評価モデルです。エージェントが複数に及び、関連するサービスも多岐にわたる前提での評価に必要な階層型の評価フレームワークを提供しています。このモデルはマルチエージェントシステムの構築・実装・防御関係者やセキュリティ専門家、プラットフォームエンジニアなどが幅広く利用することを想定されているものです。

    【連載一覧】

    第1回「Vibeコーディングとプロンプトエンジニアリングの基礎」
    第2回「プロンプト以外で効率化!開発体験の改善手法」
    第3回「AIエージェント時代のコーディング:MCPとA2Aとは」
    第4回「MCPの脆弱性とA2A脅威分析から学ぶセキュリティ実装」
    第5回「AIとセキュリティ:Non‑Human Identity とAIエージェントの課題」
    第6回「AIエージェントのセキュリティ対策と今後の展望」


    Security NEWS TOPに戻る
    バックナンバー TOPに戻る

    ウェビナー開催のお知らせ

  • 2025年9月17日(水)14:00~15:00
    「サイバーリスクから企業を守る ─脆弱性診断サービスの比較ポイントとサイバー保険の活用法─」
  • 2025年9月24日(水)12:50~14:00
    「製造業・自動車業界のためのサプライチェーン対策 -攻撃事例から学ぶ企業を守るセキュリティ強化のポイント-」
  • 2025年10月1日(水)13:00~14:00
    「2025年10月Windows10サポート終了へ 今知るべきサポート切れのソフトウェアへのセキュリティ対策ガイド」
  • 最新情報はこちら


    資料ダウンロードボタン
    年二回発行されるセキュリティトレンドの詳細レポート。BBSecで行われた診断の統計データも掲載。
    お問い合わせボタン
    サービスに関する疑問や質問はこちらからお気軽にお問合せください。

    Security Serviceへのリンクバナー画像
    BBsecコーポレートサイトへのリンクバナー画像
    セキュリティ緊急対応のバナー画像

    AIコーディング入門
    第5回:NHI(Non‑Human Identity)とAIエージェントのセキュリティ課題

    Share
    AIコーディング5アイキャッチ(NHI(Non‑Human Identity)とAIエージェントのセキュリティ課題)

    AIエージェントの普及に伴い、人間以外のアイデンティティ=Non Human Identity(NHI)が新たなセキュリティ課題として浮上しています。本記事では、NHIのリスクとゼロトラストやポストゼロトラストといった最新アプローチを通じた解決策を解説し、今後のAIコーディングに求められる実践的な視点を示します。

    ※本稿は2025年7月上旬に執筆しているものです。ご覧いただく時期によっては古い情報となっている場合もありますので、ご承知おきください。

    AIエージェント時代の新課題:Non Human Identity(NHI)

    AIコーディング全般に関する課題の一つとしてAIエージェントが使用するアイデンティティ、Non Human Identity(NHI)に関する問題があります。こちらについてはSQAT.jpの記事「Non-Human Identities Top 10とは?自動化時代に求められる新しいセキュリティ視点」をご確認ください。

    従来型セキュリティコントロールの限界

    従来型のセキュリティコントロールはエージェントには効果がないとされています。従来のAppSecは静的環境を前提としている一方で、AIエージェントは動的な性質を持つことが要因となっています。また、予測困難なクエリを出力する可能性もあります。次の表で主要な理由をまとめています。

    表1:従来型セキュリティコントロールがAIエージェントに適さない理由

    側面従来型システムの前提Agentic AIの特性不適合の理由
    アイデンティティ管理静的なユーザー/マシンアイデンティティ(OAuth, SAML)動的で一時的なエージェントアイデンティティOAuthとSAMLは主に静的権限を持つ人間ユーザーとアプリケーション向けに設計されており、AIエージェントが必要とする細かく適応的なアクセス制御機能を提供できない
    権限管理長期間有効な権限とロールベースアクセス制御(RBAC)コンテキスト依存の短期間権限AIエージェントは、リスクレベル、ミッション目標、リアルタイムデータ分析などのコンテキスト要因に基づいて権限を動的に変更する必要がある
    認証モデルセッション期間中の一回認証継続的認証と検証AIエージェントは敵対的攻撃、進化する意図、変化する運用コンテキストなどの複雑性を導入し、一回の認証ではなく継続的な検証が必要
    データ・指示分離明確なデータと制御チャネル分離データと指示の混在GenAIモデルはデータと指示チャネルを結合するため、攻撃者がデータチャネルを通じてシステム操作に影響を与えることを可能にする
    脅威モデル既知の攻撃パターンと定義された攻撃面新たな攻撃面と敵対的機械学習脅威AIシステムは敵対的操作や攻撃に対してスペクタキュラーな失敗を起こすことがある
    出典:次のソースより弊社にて翻訳、編集,Cloud Security Alliance “Agentic AI Identity Management Approach | CSA ” (Ken Huang, 2025),DHS ” Safety and Security Guidelines for Critical Infrastructure Owners and Operators ” (2024),NIST AI 100-2e2025 ” Adversarial Machine Learning: A Taxonomy and Terminology of Attacks and Mitigations” (2025)

    ゼロトラストアプローチによる抑制策

    従来型セキュリティコントロールの限界に対して、リスクの抑制策としてエージェントへのゼロトラスト思想の適用が提唱されています。ご存じの通りゼロトラスト思想は常に対象が信頼できないものであるというものです。AI、特に幅広い範囲を様々な権限を持って自律的に行動していくAIエージェントはAppSecに比べて動的で動作の予測が困難であるという特性から考えても、ゼロトラスト思想によるセキュリティアプローチによる抑制策の効果が期待できます。

    表2:AIエージェントへのゼロトラスト原則の適用と有効性

    ゼロトラスト原則Agentic AIへの適用有効性の根拠
    継続的検証AIエージェントは、正当なエンティティのみがリソースにアクセスできるよう、リアルタイムの認証・認可チェックを受けなければならないAIエージェントの動的で自律的性質に対応
    最小権限アクセスAIエージェントは、タスク実行に必要な最低限のアクセス権のみを付与され、権限エスカレーションのリスクを軽減するAIエージェントの予測不可能な行動による潜在的被害を制限
    マイクロセグメンテーションAI駆動環境は侵害されたエージェントが無関係なリソースにアクセスできないよう、横展開を制限するためセグメント化されるべきエージェント間の相互作用による被害拡大を防止
    異常検知と対応AIの行動は期待されるパターンからの逸脱について継続的に監視され、異常が検出された際に自動応答をトリガーするAIエージェントの行動異常を早期検出・対応
    動的信頼評価AIエージェントの履歴行動、異常検知、セキュリティ態勢に基づく動的信頼スコアの割り当てによる継続的な信頼性評価エージェントのライフサイクル全体を通じた信頼性管理
    出典:次のソースより弊社にて翻訳、編集,Cloud Security Alliance “Agentic AI Identity Management Approach | CSA ” (Ken Huang, 2025),DHS ” Safety and Security Guidelines for Critical Infrastructure Owners and Operators” (2024)

    ポストゼロトラストに向けた新しいアプローチ

    ゼロトラストアプローチを基礎とし、さらに根本的な対策を行おうという動きもあります。表3 ポストゼロトラストアプローチに掲載したような多様なアプローチの検討など、一部は実装が進んでいます。

    表3:ポストゼロトラストアプローチ

    アプローチ説明実装例利点
    エフェメラル認証AIエージェントの一時的性質を考慮し、短期間有効でコンテキスト認識のアイデンティティを生成するアプローチAWS STS一時的認証情報、GCPサービスアカウント偽装長期認証情報の漏洩リスク排除、最小権限原則の自動実現
    属性ベースアクセス制御(ABAC)ユーザー役割、デバイスセキュリティ態勢、エージェント属性、データラベリング、エージェントツールセット、環境条件などの属性に基づくアクセス許可AWS STS一時的認証情報、GCPサービスアカウント偽装細粒度で動的なアクセス制御
    Just-In-Time(JIT)アクセスAIエージェントが必要な時のみ一時的権限を要求できる機能動的権限プロビジョニングシステム攻撃面の最小化、リアルタイム要求対応
    行動ベース認証静的認証情報や事前定義された役割だけでなく、AIエージェントのリアルタイム行動、過去の相互作用、リスク評価に基づく認証機械学習ベース異常検知システム侵害されたAIエージェントの検出向上
    トラストスコアリングAIエージェントの履歴行動、異常検知、セキュリティ態勢に基づく動的トラストスコア割り当てリアルタイムリスクスコアリングシステム信頼度に基づく動的権限調整
    統合セキュリティ監視AI開発環境とランタイム環境を統合したセキュリティ態勢管理と脅威保護システムDevSecOpsパイプライン統合開発フェーズからの早期脅威検出
    データガバナンス統合AIエージェントに対する統合的なデータセキュリティとコンプライアンス制御自動データ分類・保護システムデータオーバーシェアリングとリーク防止
    出典:次のソースより弊社にて翻訳、編集,Cloud Security Alliance “Agentic AI Identity Management Approach | CSA ” (Ken Huang, 2025),DHS ” Safety and Security Guidelines for Critical Infrastructure Owners and Operators ” (2024)

    AIコーディングに求められる次世代セキュリティ戦略

    AIエージェントの普及は、従来のセキュリティモデルを大きく揺さぶっています。Non Human Identity(NHI)の管理や、従来型コントロールでは対応しきれない動的な挙動、そして敵対的機械学習を悪用した新たな攻撃手法など、課題は複雑かつ広範です。本記事で紹介したゼロトラストやポストゼロトラストのアプローチは有効な一歩となりますが、それだけで十分ではありません。AIが協調的に動作するマルチエージェント環境では、脅威の拡大スピードも従来以上に速く、より総合的な戦略が求められます。

    次回第6回は、これまでの議論を総括し、マルチエージェント時代の脅威モデルや未来の展望を整理します。AIコーディングの安全な発展に不可欠な「総評」として、今後の方向性を見極めていきます。


    ―第6回「総評:マルチエージェント時代の脅威と未来」へ続く―

    【連載一覧】

    第1回「Vibeコーディングとプロンプトエンジニアリングの基礎」
    第2回「プロンプト以外で効率化!開発体験の改善手法」
    第3回「AIエージェント時代のコーディング:MCPとA2Aとは」
    第4回「MCPの脆弱性とA2A脅威分析から学ぶセキュリティ実装」
    第5回「AIとセキュリティ:Non‑Human Identity とAIエージェントの課題」
    第6回「AIエージェントのセキュリティ対策と今後の展望」


    Security NEWS TOPに戻る
    バックナンバー TOPに戻る

    ウェビナー開催のお知らせ

  • 2025年9月10日(水)14:00~15:00
    「フィッシング攻撃の最新脅威と被害事例〜企業を守る多層防御策〜」
  • 2025年9月17日(水)14:00~15:00
    「サイバーリスクから企業を守る ─脆弱性診断サービスの比較ポイントとサイバー保険の活用法─」
  • 最新情報はこちら


    資料ダウンロードボタン
    年二回発行されるセキュリティトレンドの詳細レポート。BBSecで行われた診断の統計データも掲載。
    お問い合わせボタン
    サービスに関する疑問や質問はこちらからお気軽にお問合せください。

    Security Serviceへのリンクバナー画像
    BBsecコーポレートサイトへのリンクバナー画像
    セキュリティ緊急対応のバナー画像

    AIコーディング入門
    第4回:MCPの脆弱性とA2A脅威分析から学ぶセキュリティ実装

    Share

    Security NEWS TOPに戻る
    バックナンバー TOPに戻る

    AIコーディング4アイキャッチ(MCPの脆弱性とA2A脅威分析から学ぶセキュリティ実装)

    前回記事で述べたように、AIエージェントの普及に伴い、MCP(Model Context Protocol)やA2A(Agent-to-Agent Protocol)の実装事例が増えています。しかし、標準化が進む一方で、脆弱性やセキュリティリスクも現実化しつつあります。本記事では、AIエージェントの基盤を支える標準プロトコル「MCP(Model Context Protocol)」と「A2A(Agent-to-Agent Protocol)」をさらに深く掘り下げ、AIエージェントを安全に活用するための設計指針と実装上の留意点を整理します。

    ※本稿は2025年7月上旬に執筆しているものです。ご覧いただく時期によっては古い情報となっている場合もありますので、ご承知おきください。

    MCPの脆弱性

    MCPの脆弱性の事例としては以下のものが挙げられます。

    AsanaのMCPサーバの事例

    プロジェクトやタスクを一元管理するプラットフォーム(SaaS)・Asanaが2025年5月から提供し始めたMCPサーバに脆弱性があったもの。脆弱性により、MCPを使用しているユーザーが、LLMと接続しているチャットインターフェース越しに他の組織のプロジェクト、チーム、タスクを含むAsanaオブジェクトを取得できた可能性があるとされています*5。前回ご紹介した「図4:MCP関連の主なセキュリティ課題」にも挙げたように、最小特権の付与の原則の徹底(SaaS提供事業者の場合にはテナント間の厳密な分離も含みます)、リクエストやLLMの生成クエリのログの記録といった課題が改めて浮き彫りになったといえます。

    A2Aのセキュリティ課題

    MAESTRO脅威モデリングに当てはめたときには以下のような問題があると指摘されています。なおMAESTRO脅威モデリングについては下表でご紹介します。

    表:A2Aプロトコルのセキュリティ課題のMAESTROモデル分析

    レイヤ脅威概要被害を受ける人・組織発生確率影響軽減策
    1メッセージ生成攻撃 (回避)攻撃者が悪意のある入力を生成し、エージェントのモデルに誤った、偏った、または有害なメッセージを生成させ、通信中の安全メカニズムを迂回する。モデル出力の非決定論的性質が、これらの攻撃の検出と防止をより困難にする。A2A エージェントを利用する組織、システムの利用者高大入力検証: エージェントのモデルにコンテンツを送信する前に厳格な入力検証を実施する。入力をサニタイズする。
    出力検証: 生成されたメッセージのコンテンツに有害なコンテンツ、矛盾、または予期しない動作がないか確認する。コンテンツフィルタリングを使用する。非決定論的なモデルの動作に対する出力検証の堅牢性を高めるために、アンサンブル法や敵対的訓練などの技術を採用する。
    慎重なプロンプト設計: 敵対的攻撃の影響を受けにくいプロンプトを設計する。モデルをガイドするために少数ショットの例を使用する。
    モデル抽出A2A を介した過度または巧妙な対話により、プロプライエタリモデルの動作やパラメータに関する十分な詳細が提供され、モデルの推論または盗難が可能になる。エージェントの自律性が、予期しない情報漏洩につながる可能性のある、緩やかに制御された対話パターンを促進することで、この問題を増幅させる可能性がある。モデル所有者、企業低大(潜在的に)厳格なレート制限: セッション/ユーザー/エージェントごとの A2A 対話にレート制限を適用する。
    異常検出: プロービングやデータ抽出の試みを示唆する異常なクエリパターンを監視する。
    2データ汚染 (メッセージ部分)攻撃者がエージェント間で交換されるメッセージに悪意のあるコンテンツを注入し、意思決定に使用されるデータを侵害する。エージェントの相互作用の動的な性質は、このデータポイズニングが急速に広がり、連鎖的な影響を及ぼす可能性があることを意味する。エージェント、A2A エージェントの決定に依存する組織中~高大強力な検証: ファイルの整合性チェック、DataParts のスキーマ検証、TextParts のコンテンツフィルタリングを含む、すべてのメッセージパーツに対する厳格な検証を実施する。
    最小特権: 最小特権の原則に基づいて、機密データへのエージェントのアクセスを制限する。
    出どころの追跡: メッセージ内のデータの出どころと系統を追跡し、信頼性を評価する。送信元エージェントのIDとデータに適用された変換を考慮するために出どころの追跡を拡張する。
    機微情報の漏洩エージェントが、過度に広範な権限、データ管理ミス、またはモデルの幻覚により、A2A 通信または成果物で意図せず機密情報(PII、機密情報)を公開する。個人(PII の所有者)、機密情報を扱う組織中中~大自動 PII 編集: 個人識別情報(PII)の検出と編集のための自動プロセスを採用する(例: Gemini のフィルター機能)。
    きめ細かなアクセス制御: エージェントの役割とタスクのコンテキストに応じて堅牢なアクセス制御を実装する。
    コンテキスト認識型ガードレール: エージェントが機密情報や制限された情報を共有するのを防ぐためにガードレールを追加する。
    3許可されていないエージェントのなりすまし攻撃者が正当なエージェントになりすまし、機密情報にアクセスしたり、他のエージェントを操作したりする。変化する資格情報や検証可能なクレデンシャルによって示されるエージェント ID の動的な性質は、この脅威をさらに複雑にする。他のエージェント、A2A プロトコルを利用する組織中大分散型識別子(DIDs): エージェントに ID 検証のために DID を使用することを義務付ける。ID の変更を検出するために、DID ドキュメントを定期的に更新および再検証するメカニズムを実装する。
    安全な認証: DID ベースの署名や相互 TLS などの強力な認証メカニズムを実装し、エージェントの ID を検証する。リプレイ攻撃を防ぎ、通信時に資格情報が有効であることを確認するために、タイムスタンプ付き署名を使用する。
    エージェントレジストリ: エージェントの正当性を検証するために、信頼されたエージェントレジストリを実装する。レジストリは動的なエージェント属性を処理できる必要があり、継続的に更新されるべきである。
    メッセージインジェクション攻撃攻撃者が A2A メッセージに悪意のあるコンテンツを注入し、受信エージェントの動作を操作する。エージェントの自律性は、侵害されたエージェントが人間の介入なしに悪意のあるメッセージを伝播する可能性があるため、この脅威を増幅させる。メッセージを受信するエージェント、操作されたエージェントによって制御されるシステム高大(潜在的に)M デジタル署名: すべての A2A メッセージにデジタル署名を実装し、整合性と否認防止を確保する。メッセージが有効と見なされる前に、複数の信頼されたエージェントからの承認を必要とするマルチ署名スキームを実装する。
    入力検証: メッセージパーツやメタデータを含むすべてのメッセージコンテンツに厳格な入力検証を実施する。
    コンテンツフィルタリング: メッセージ内の悪意のあるコンテンツを検出してブロックするためにコンテンツフィルタリングを使用する。
    プロトコルダウングレード攻撃攻撃者がエージェントに A2A プロトコルのセキュリティの低いバージョンを使用させる。非決定論的なエージェントの相互作用により、予測がより困難な追加の攻撃ベクトルが開かれる可能性がある。A2A エージェント、A2A 通信に依存するシステム低大(潜在的に)安全なプロトコルネゴシエーション: 相互認証を伴うトランスポート層セキュリティ(TLS)などの安全なプロトコルネゴシエーションメカニズムを実装し、エージェントが最も安全なプロトコルバージョンを使用するようにする。
    廃止ポリシー: 古いプロトコルバージョンに対する廃止ポリシーを明確に定義し、実施する。
    信頼できる企業を装った悪意のある A2Aサーバ攻撃者が信頼できる企業や組織が運営しているように見せかけた悪意のある A2A サーバをセットアップし、エージェントを騙して通信させ、機密情報を漏洩させたり、悪意のあるタスクを実行させたりする可能性がある。エージェント、ユーザー/組織(データ窃取の被害者)、A2A 運用に依存する組織、なりすまされた信頼できる企業(評判の損害)中大(潜在的に)サーバ ID の分散型識別子(DIDs): エージェントと同様に、A2A サーバは DID を使用して識別され、その DID ドキュメントは検証可能で定期的に更新されるべきである。A2A プロトコルは、サーバからエージェントへの通信に DID ベースの認証を義務付けるべきである。
    Agent Cards の証明書透明性(CT): SSL/TLS 証明書に似た証明書透明性(CT)のようなメカニズムを実装する。Agent Cards は公開ログ(例:ブロックチェーンや分散型台帳)に登録でき、エージェントが Agent Card が正当であり、改ざんされていないことを検証できるようにする。
    相互 TLS(mTLS)認証: エージェントと A2A サーバ間の相互 TLS(mTLS)認証を強制する。
    サーバードメインの DNSSEC: A2A サーバの Agent Card にドメイン名を含む URL が含まれている場合、DNSSEC でドメインを保護し、DNS スプーフィング攻撃を防ぐ。
    エージェントレジストリ検証: A2A サーバと対話する前に、エージェントは信頼されたエージェントレジストリを参照し、サーバが正当であることを検証すべきである。
    Agent Card 署名検証: エージェントはサーバの公開鍵または DID を使用して Agent Card を暗号学的に検証し、カードが改ざんされていないことを確認すべきである。
    重要操作に対する多要素認証: 機密性の高い操作の場合、エージェントは A2A サーバと通信する前に多要素認証(MFA)を要求すべきである。
    行動分析とレピュテーションシステム: なりすましを示唆する異常なサーバ活動パターンを検出するために行動分析を実装する。
    監査とログ: エージェントと A2A サーバ間のすべての通信の詳細な監査ログを維持する。
    ハニーポットサーバー: 攻撃者を引きつけ、その技術に関する情報を収集するために、ハニーポット A2A サーバをデプロイする。
    4T4.1: DoS 攻撃攻撃者が A2A サーバにリクエストを殺到させ、エージェントが通信不能になる。エージェントの自律的な性質は、DoS 攻撃がエコシステム全体に急速に連鎖する可能性があることを意味する。A2A サーバ、A2A サービスを利用するユーザー/組織、エージェントエコシステム中~高大堅牢なインフラストラクチャ: ダウンタイムを最小限に抑えるために、冗長で地理的に分散されたインフラストラクチャを使用する。
    DDoS 防御: 堅牢な DDoS 緩和策を実装する。
    レート制限: 過剰なリクエストを防ぐためにレート制限を実装する。リアルタイムのネットワーク状況とエージェントの活動パターンに基づいて調整される適応型レート制限を実装する。
    5ログデータの隠蔽・改ざん攻撃者が悪意のある活動を隠蔽するためにログエントリを変更または削除する。エージェントの動作の複雑で予測不可能な性質は、正当な活動と、操作されたログによって隠蔽された悪意のある行動を区別することをより困難にする。セキュリティチーム、監査担当者、インシデントレスポンダー、ログの整合性に依存する組織中大(潜在的に)安全なログ記録インフラストラクチャ: 強力なアクセス制御を備えた安全なログ記録インフラストラクチャを使用する。
    ログ整合性監視: チェックサムまたはデジタル署名を使用してログデータの整合性を検証する。
    異常検出: エージェントの固有の非決定論性を考慮に入れた高度な異常検出技術を採用する。
    6エージェントの認証情報への認可されないアクセス攻撃者がエージェントの資格情報(例: 秘密鍵)にアクセスし、エージェントになりすまして悪意のある行動を実行できるようにする。エージェントが検証可能な資格情報を動的に取得および提示するため、侵害されたエージェントは迅速に強力な新しい能力を獲得し、損害の可能性を拡大させる。エージェント所有組織、侵害されたエージェントがアクセスするシステム高大安全な鍵ストレージ: エージェントの資格情報をコードに直接埋め込まない。ハードウェアセキュリティモジュール(HSM)または安全な鍵管理サービスを使用する。
    鍵のローテーション: エージェントの資格情報を定期的にローテーションする。
    多要素認証: ユーザーが実際に制御していることを確認するために MFA を使用する。
    機微情報へのコンプライアンスの欠如エージェントが PII を含むデータを適切な保護なしに送信、受信、処理する。エージェントの自律性がこれらの脅威を強める。機密データを扱う組織(法的・経済的罰則)、個人(PII の所有者)中~高大(潜在的に。法的・経済的罰則を伴う)データ最小化: 個人データの収集を削減する。仮名化/匿名化:。
    データ暗号化: エンドツーエンドの暗号化と鍵の保護を確実にする。
    委任権限の濫用実装の脆弱性により、エージェントが与えられた権限を超える可能性がある。権限を委譲した組織、エージェントが動作するシステム(明示されていない。なお実装に依存する可能性が高い)(明示されていないが一般的に委任権限の濫用による影響は大きい)明示的なユーザー同意:。
    詳細な監査:。
    厳格なトークン検証:。
    7悪意のあるエージェントの相互作用侵害されたエージェントが他のエージェントと相互作用し、危害を与えたり、脆弱性を悪用したり、予期しない結果を引き起こしたりする。エージェントの ID が変化し、動作が予測不可能なため、あるエージェントが他のエージェントよりも大きな損害を引き起こす可能性を予測することは困難である。エコシステム内の他のエージェント、エージェントに接続されたシステム中~低高(潜在的に影響度が高いと想定される)安全なエージェント間通信: エージェント間の相互作用に安全な通信プロトコルと認証メカニズムを使用する。
    エージェントレピュテーションシステム: エージェントの動作を追跡し、悪意のあるエージェントを識別するためにレピュテーションシステムを実装する。レピュテーションシステムは、エージェントの ID の動的な性質を処理でき、操作に耐性がある必要がある。
    サンドボックス化: 侵害されたエージェントの影響を制限するために、エージェントを相互に隔離する。エージェントが定義された境界を超えるのを防ぐために、ランタイム監視とポリシー実施を実装する。

    出典:「Threat Modeling Google’s A2A Protocol with the MAESTRO Framework」6: Threat Modeling Results: Applying MAESTRO Layer by Layerより弊社翻訳
    ※ 本図はOWASPが定義するMAESTROモデルをベースに記載されたhttps://cloudsecurityalliance.org/blog/2025/04/30/threat-modeling-google-s-a2a-protocol-with-the-maestro-frameworkの6: Threat Modeling Results: Applying MAESTRO Layer by Layerを弊社にて翻訳、表に編集しなおしたものです。

    AIエージェント時代における標準プロトコルのリスク管理

    AIエージェントの普及に伴い、MCPやA2Aといった標準プロトコルは不可欠な基盤となりつつあります。しかし、標準化による利便性の裏側には、同じ脆弱性が広範囲に拡散するリスクが潜んでいます。リスク管理の基本は「標準=安全」と思い込まず、実装ごとにセキュリティ要件を精査することです。特にアクセス制御、暗号化、監査ログといった基礎的な対策をプロトコルレベルで徹底する必要があります。

    さらに今後は、従来の「人間を前提としたセキュリティモデル」では対応できない課題が顕在化していくことが予想されます。次回第5回では、Non Human Identity(NHI)の登場や制御不能なAIエージェントといった新たな脅威に焦点を当て、従来型セキュリティの限界とその打開策について考察します。


    ―第5回「AIとセキュリティ:Non‑Human Identity とAIエージェントの課題」へ続く―

    【連載一覧】

    第1回「Vibeコーディングとプロンプトエンジニアリングの基礎」
    第2回「プロンプト以外で効率化!開発体験の改善手法」
    第3回「AIエージェント時代のコーディング:MCPとA2Aとは」
    第4回「MCPの脆弱性とA2A脅威分析から学ぶセキュリティ実装」
    第5回「AIとセキュリティ:Non‑Human Identity とAIエージェントの課題」
    第6回「AIエージェントのセキュリティ対策と今後の展望」


    Security NEWS TOPに戻る
    バックナンバー TOPに戻る

    ウェビナー開催のお知らせ

  • 2025年9月3日(水)13:00~14:00
    「止まらないサイバー被害、その“対応の遅れ”はなぜ起こる?~サイバー防衛の未来を拓く次世代XDR:大規模組織のセキュリティ運用を最適化する戦略的アプローチ~」
  • 2025年9月10日(水)14:00~15:00
    「フィッシング攻撃の最新脅威と被害事例〜企業を守る多層防御策〜」
  • 2025年9月17日(水)14:00~15:00
    「サイバーリスクから企業を守る ─脆弱性診断サービスの比較ポイントとサイバー保険の活用法─」
  • 最新情報はこちら


    資料ダウンロードボタン
    年二回発行されるセキュリティトレンドの詳細レポート。BBSecで行われた診断の統計データも掲載。
    お問い合わせボタン
    サービスに関する疑問や質問はこちらからお気軽にお問合せください。

    Security Serviceへのリンクバナー画像
    BBsecコーポレートサイトへのリンクバナー画像
    セキュリティ緊急対応のバナー画像

    AIコーディング入門
    第3回:AIエージェント時代のコーディング:MCPとA2Aとは

    Share

    Security NEWS TOPに戻る
    バックナンバー TOPに戻る

    AIコーディング3アイキャッチ(AIエージェント時代のコーディング)

    生成AIを活用したコーディングの現場で、いま最も注目されているトピックのひとつが「AIエージェント」です。エージェントは人間の最小限の指示をもとに計画・推論・実行を繰り返す自律的な仕組みであり、シングルエージェントからマルチエージェントまで多様なアーキテクチャが登場しています。さらに通信の標準化を担うMCP(Model Context Protocol)やA2A(Agent-to-Agent)といったプロトコルの整備が進み、エコシステム全体に大きな影響を与えています。本記事では、AIエージェントの基本構造、利点とリスク、新しい標準プロトコルの動向について解説します。

    ※本稿は2025年7月上旬に執筆しているものです。ご覧いただく時期によっては古い情報となっている場合もありますので、ご承知おきください。

    AIエージェントとは何か

    生成AIを使用したコーディングのなかでも昨今注目を浴びているのがAIエージェント(Agentic AI)を用いたAgenticコーディングです。Agenticコーディングの前にまずはAIエージェントの動きを見てみましょう。AIエージェントは人間による最低限の指示や監督をもとに計画・推論・実行を繰り返す、自律的処理を行うAIです。

    シングルエージェントの仕組み

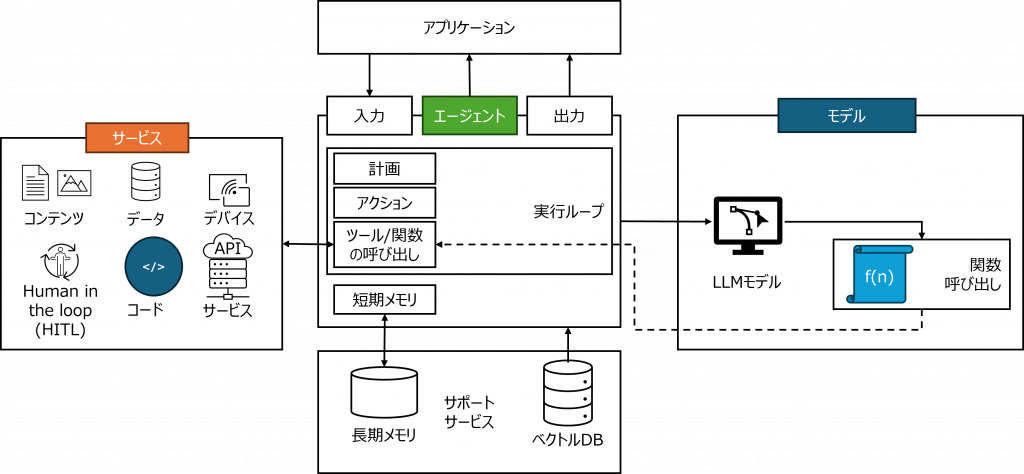
    まずはわかりやすい、単一のエージェントのみが動くシングルエージェントのアーキテクチャを見てみましょう。下図はシングルエージェントのアーキテクチャを示したものです。

    図1:シングルエージェントのアーキテクチャ

    シングルエージェントのアーキテクチャの図
    参考:OWASP LLM Applications & Generative AI Top 10(https://genai.owasp.org/resource/owasp-top-10-for-llm-applications-2025/), p.8より弊社翻訳

    シングルエージェントモデルではアプリケーションからの入出力(人間による指示)をもとに単一のエージェントが自律的にルーチンを実行し、LLMモデルや関連サービスとの間の連携を図り、出力を行います。人による監督はHuman in the loop(HITL)という形で行われます。この図の中でいうAIアプリケーション(及びエージェント)が各種サービスやデータベースなどと通信する際、昨今ではMCP (Model Context Protocol)を用いた標準化された通信プロトコルが用いられていることが増えています。MCPについては後程解説します。

    マルチエージェントの仕組み

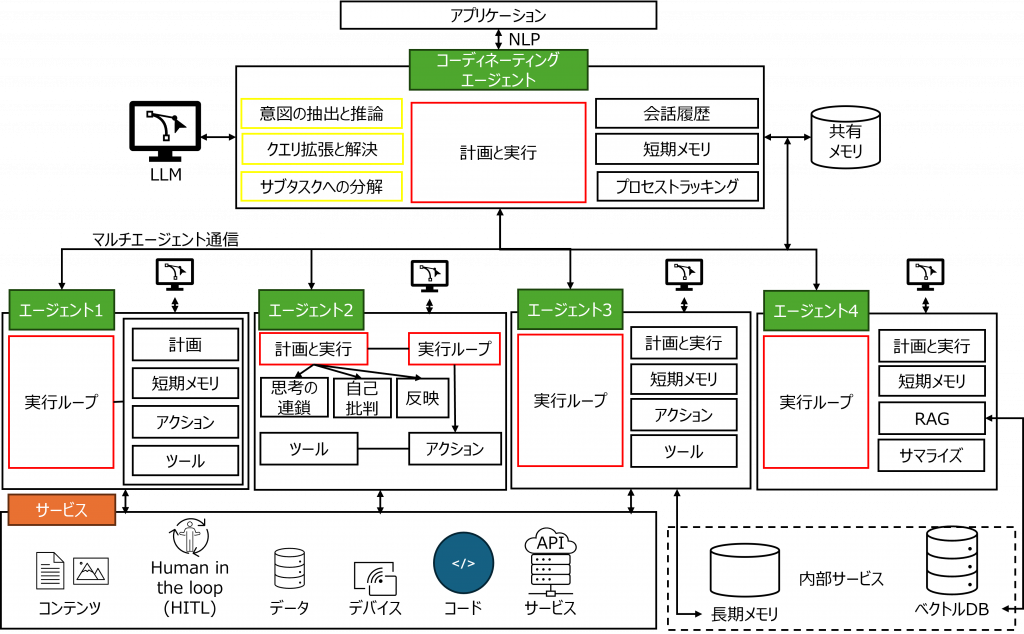
    一方マルチエージェントのアーキテクチャは下図のとおりです。

    図2:マルチエージェントのアーキテクチャ

    マルチエージェントのアーキテクチャの図
    参考:OWASP LLM Applications & Generative AI Top 10(https://genai.owasp.org/resource/owasp-top-10-for-llm-applications-2025/), p.10より弊社翻訳

    マルチエージェントの場合はAIアプリケーション(及びエージェント)と各種サービス、DBなどとのMCPでの通信に加えて、エージェント間の通信(図中のマルチエージェント通信)が必要となります。エージェント間の通信を標準化したものがA2A(Agent2Agent)プロトコルになります。こちらも後程解説します。

    AIエージェントの利点とリスク

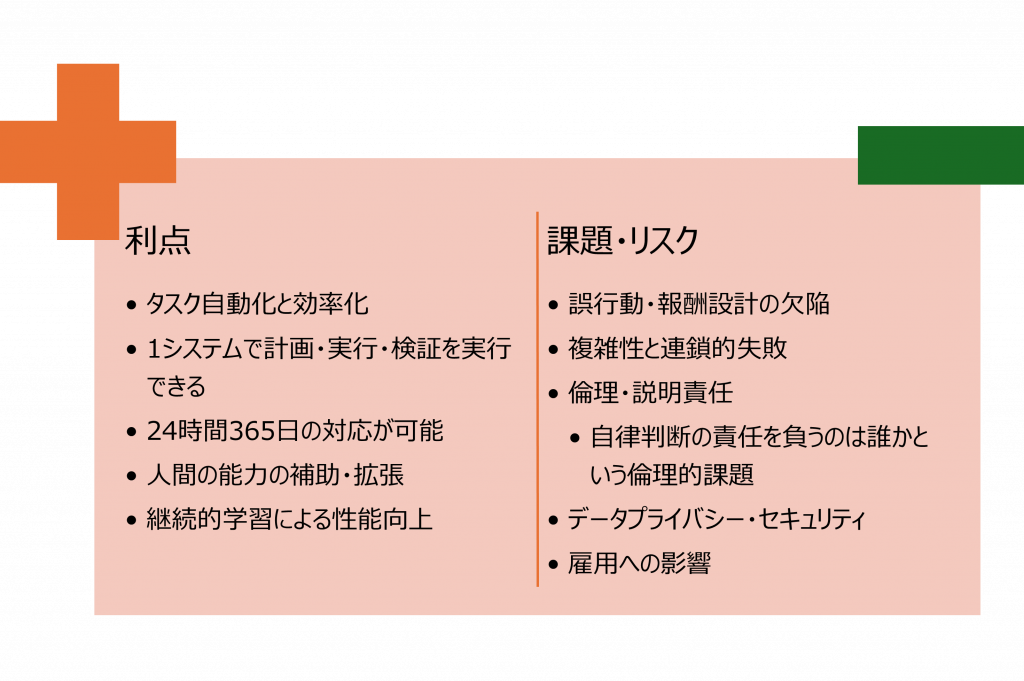
    AIエージェントを利用する場合、人間の監督・指示が最低限で済む一方で、以下のような利点と課題・リスクが存在します。

    図3:AIエージェントの利点と課題・リスク

    AIエージェントの利点・課題・リスク

    上記に挙げたAIエージェントのリスクのうち、「誤行動・報酬設計の欠陥」と「倫理・説明責任」を取り上げて解説します。

    誤行動・報酬設計の欠陥

    報酬のミススペックによりエージェントが意図しない行動をとることを指します*2。 最近の報告ではエージェントが自身の地位を脅かされる場合や、目標の対立が発生した場合に内通者のような不正行動を低率ながら遂行する可能性が指摘されています*2。

    倫理・説明責任

    AIエージェントの自律判断の責任を負うのは誰かという問題。倫理的な問題に加えて著作権に代表されるような法的な問題に加えて、信頼性・公平性といった問題についての課題も指摘されています*3。

    新しい標準プロトコル:MCPとA2A

    ここ最近、「MCP」や「A2A」といったキーワードを目にする機会が増えているのではないでしょうか。ここでは簡単にMCPとA2Aについてご紹介します。

    MCP(Model Context Protocol)とは

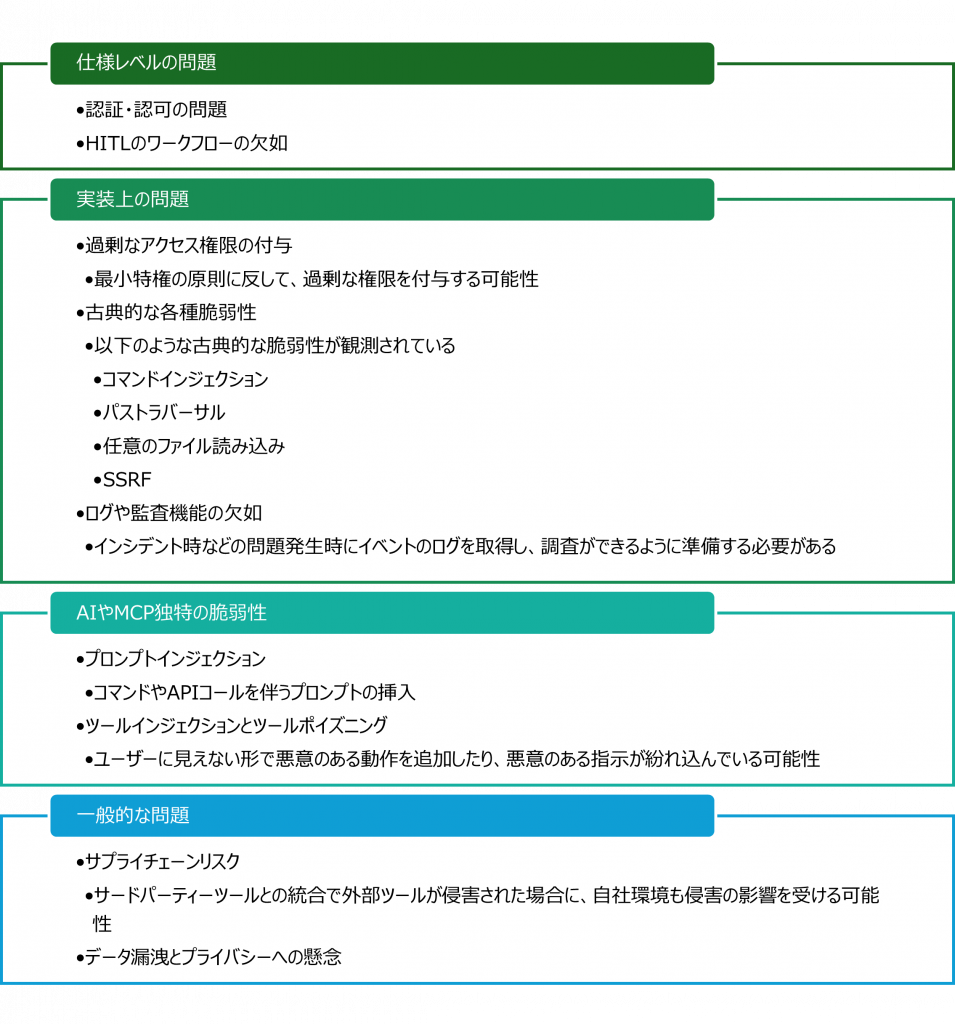
    MCPとはAIアプリケーションがLLMにコンテキストを提供する方法を標準化するプロトコルで、Anthropicによって仕様が策定され、現在はオープンソース化されています。現在C#、Java、Kotlin、Python、Ruby、Swift、TypeScript向けのSDKが提供されており、幅広い言語環境で利用できること、AIアプリケーションのUSB-Cポートとして標準化されていること、そして認証認可にOAuth2.1を用いることが必須要件となっている点など、順次仕様が変更されており、新しいプロトコルとして注目を浴びています。またオープンソースであることやそのコンセプトから多くの実装例がすでに存在しています。一方でセキュリティ上の問題点も指摘されています。

    図4:MCP関連の主なセキュリティ課題

    MCP関連のセキュリティ課題(仕様レベル・実装上の問題、AI・MCA独特の脆弱性、一般的な問題)

    A2A(Agent-to-Agent)とは

    A2AはGoogleが立ち上げたエージェント間の通信プロトコルで、2025年6月にLinux財団に寄付され、Linux財団を中心に開発が進められています。こちらはGoogleのVertexなどを皮切りに実装が始まっています。A2Aプロトコルはマルチエージェントでの処理のニーズの増大、クラウドでのベンダーロックイン問題の影響でベンダーロックインの回避への強い要求があったことや、AIエージェントに対するコンプライアンスやガバナンス要求(EUのAI法など)の高まりといったところにうまくマッチしたものとも言えます。

    AIエージェントは今後の開発を大きく変える存在ですが、その基盤を支えるのがMCPやA2Aといった標準プロトコルです。次回第4回では、これらの仕組みをより詳しく掘り下げ、エンジニアが知っておくべき活用ポイントを解説します。


    ―第4回「MCPの脆弱性とA2A脅威分析から学ぶセキュリティ実装」へ続く―

    【参考情報】

    【連載一覧】

    ―第1回「Vibeコーディングとプロンプトエンジニアリングの基礎」―
    ―第2回「プロンプト以外で効率化!開発体験の改善手法」―
    ―第3回「AIエージェント時代のコーディング:MCPとA2Aとは」―
    第4回「MCPの脆弱性とA2A脅威分析から学ぶセキュリティ実装」
    第5回「AIとセキュリティ:Non‑Human Identity とAIエージェントの課題」
    第6回「AIエージェントのセキュリティ対策と今後の展望」

    Security NEWS TOPに戻る
    バックナンバー TOPに戻る

    ウェビナー開催のお知らせ

  • 2025年9月3日(水)13:00~14:00
    「止まらないサイバー被害、その“対応の遅れ”はなぜ起こる?~サイバー防衛の未来を拓く次世代XDR:大規模組織のセキュリティ運用を最適化する戦略的アプローチ~」
  • 2025年9月10日(水)14:00~15:00
    「フィッシング攻撃の最新脅威と被害事例〜企業を守る多層防御策〜」
  • 2025年9月17日(水)14:00~15:00
    「サイバーリスクから企業を守る ─脆弱性診断サービスの比較ポイントとサイバー保険の活用法─」
  • 最新情報はこちら


    資料ダウンロードボタン
    年二回発行されるセキュリティトレンドの詳細レポート。BBSecで行われた診断の統計データも掲載。
    お問い合わせボタン
    サービスに関する疑問や質問はこちらからお気軽にお問合せください。

    Security Serviceへのリンクバナー画像
    BBsecコーポレートサイトへのリンクバナー画像
    セキュリティ緊急対応のバナー画像