お名前.com デスクトップクラウドに不正アクセス ―情報流出の影響・補償内容と利用者の対応

Share
お名前.com デスクトップクラウドに不正アクセス ―情報流出の影響・補償内容と利用者の対応アイキャッチ画像

GMOインターネット株式会社は2026年10月24日、「お名前.com デスクトップクラウド」への不正アクセスに関する続報を公表し、情報流出への対応や不正取引による損失の補償方針を明らかにしました。全プランの停止に加え、利用者には取引口座の認証情報や取引履歴の確認が求められています。今回の事案では、今回の事案では、クラウド環境に保存された認証情報と、接続先の取引口座の確認が欠かせません。本記事では公式発表を基に判明した事実と利用者・企業が取るべき対応を整理します。

※本記事は2026年10月26日時点で公表されている情報を基に作成しています。

問い合わせから調査が始まり全プランの停止へ

調査のきっかけは10月19日の利用者からの問い合わせでした。翌20日に一部サーバーで不正なプログラムが見つかり、新規申し込みの受け付けとコントロールパネルが停止されました。19日は公表された調査開始日であり、攻撃が始まった日を示すものではありません。21日午前4時からは全プランのサーバーが順次停止されました。

初報では個人情報の流出や悪用は確認されていないと説明されていました*1が、その後、21日以降に利用者から身に覚えのない取引などの報告が寄せられました。第2報によると、同社は22日に警察へ相談しています*2。古い発表だけで安全性を判断せず、更新後の内容まで確認する必要があります。

影響の可能性があるサーバー数と確定被害を区別する

公表された26,739件は、影響を受ける可能性があるサーバーの数です。すべてのサーバーへの侵入や情報流出が確認されたわけではなく、被害を受けた利用者の人数を示す数字でもありません。その後の発表では、利用者情報の外部流出が確認され、不正取引による損失の補償方針も示されました。一部の利用者からは身に覚えのない取引の報告も寄せられています。ただし、個々の利用者の被害状況や不正取引と本件との因果関係については、引き続き確認が必要です。

また、同社が決済情報をサービスのサーバーに保持していないことと、利用者自身が保存した認証情報の安全性は別の問題です。取引ツールやブラウザに保存した情報も確認対象となります。利用者のパソコンなどへの影響についても調査中であり、端末への感染が一律に確認されたわけではありません。

図1:お名前.com デスクトップクラウドの公表内容と対応の経緯
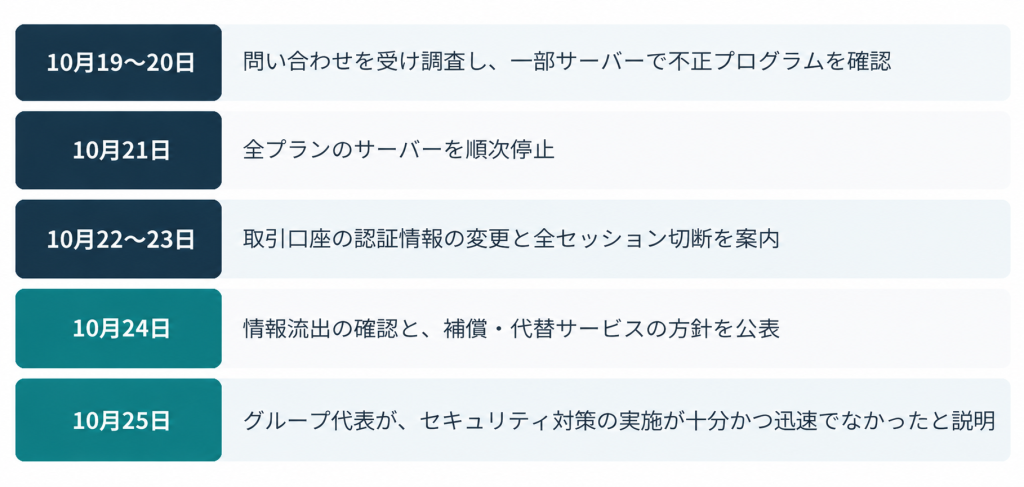
お名前.com デスクトップクラウドの公表内容と対応の経緯
出典:GMOインターネット株式会社「お名前.com デスクトップクラウドへの不正アクセスに関するお詫びとお知らせ(第3報)」「お客様へのお見舞金のお支払いと不正取引による損失の補償について(第4報)」、GMOインターネットグループ株式会社・GMOインターネット株式会社「不正アクセスに関するお詫びとお知らせ(第2報)」、熊谷正寿氏の公式ブログ「今こそ官民連携で日本を守ろう――『能動的サイバー防御』を具申した理由」を基に作成。
※各資料に記載された出来事の日付と公表日を整理したもので、攻撃の開始日を示す図ではありません。

パスワード変更と全セッションの切断を進める

利用者は、取引口座などのパスワードを変更するとともに、認証済みの全セッションを切断する必要があります。同社は、FX取引に使用していないスマートフォンや別のパソコンから変更するよう案内しています。すでにパスワードを変更した場合も、セッションの切断が必要です。パスワードを変更しても、すでに成立している接続が終了するとは限りません。また、遠隔デスクトップの画面を閉じただけでは、取引口座への接続がすべて終了したとは判断できません。切断方法が分からない場合は、利用している金融事業者に確認してください。

図2:利用者が優先すべき3つの対応
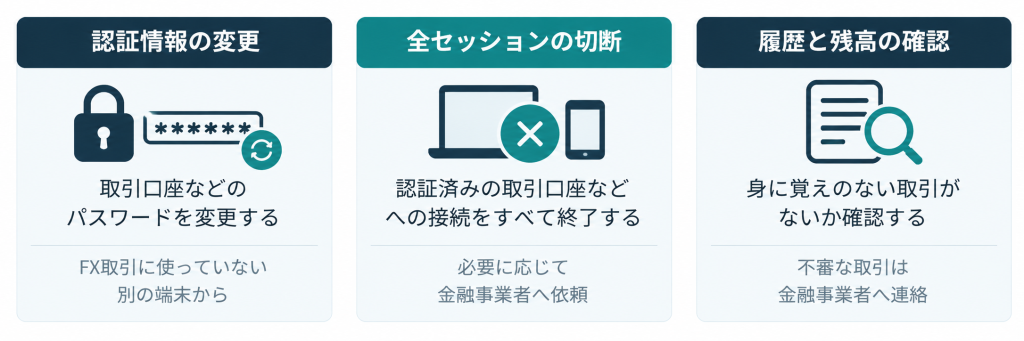
認証情報の変更、全セッションの切断、取引履歴・残高の確認という、目的の異なる3つの対応を整理
出典:GMOインターネット株式会社「お名前.com デスクトップクラウドへの不正アクセスに関するお詫びとお知らせ(第3報)」「『お名前.com デスクトップクラウド』ご利用のお客様へ改めてのお願い(第5報)」を基に作成。

口座の履歴と端末を確認し不審な連絡に応じない

第5報は、口座の履歴と残高を確認し、身に覚えのない取引があれば金融事業者に連絡するよう求めています*3。提供されている場合は二要素認証を設定し、保存済みの認証情報や使い回していたパスワードも見直す必要があります。口座ごとに確認した日時と結果を整理し、異常があれば取引日時や内容を確認できる記録を確保しておきましょう。

パソコンやスマートフォンのフルスキャン、データのバックアップも案内されています。これは二次被害を防ぐための予防的な対応です。バックアップしたファイルの取り扱いにも注意が求められています。攻撃者を名乗る連絡には返信せず、届いたURLやファイルを開かないようにしてください。

FX自動売買の停止後は注文・保有ポジションも確認する

「お名前.com デスクトップクラウド」は、MT4・MT5を用いたFX自動売買向けの仮想専用サーバー(VPS)サービスです。手元のパソコンを起動し続けなくても、クラウド上で取引ツールや自動売買プログラム(EA)を稼働させられます。

VPSの停止により、そこで稼働していたEAも動作を継続できなくなります。ただし、取引業者側に登録済みの注文と、VPS上で実行される処理は区別する必要があります。例えばMetaTrader 4では、トレーリングストップの追随処理は取引端末側で動作するため、端末が停止すると更新も止まります。一方、すでに設定されたストップロスは取引サーバー側で処理されます。[10]利用者は、取引業者の公式画面から注文・保有ポジション・取引履歴を確認し、必要に応じて金融事業者に相談してください。

見舞金と損失補償 代替サービスの条件を確認する

見舞金は発表時点の全利用者に5,000円で、損失補償とは別枠です。補償対象は、同社が本件に起因すると認めた不正取引の実現損失で、市場変動による損失、逸失利益、間接損害は含まれません。現行基盤をそのまま再開せず、契約中で継続利用を希望する利用者には、独立した基盤の代替サービスを案内する方針です。乗り換え後6か月無料で、同意のない移行は行わないとしています。見舞金の手続き・支払時期や代替サービスの開始時期などは10月30日23時59分まで、損失補償の申請方法や支払時期などは11月6日までに案内予定です。

これらは案内期限であり、支払日やサービス開始日ではありません。補償手続きの詳細は公式案内をご確認ください。調査で閲覧専用パスワード等を求める例外がありますが、通常のパスワードや暗証番号は求めないとしています。

事前に指摘されていたセキュリティ対策上の課題

GMOインターネットグループ代表の熊谷正寿氏は10月25日の公式ブログで、社内のセキュリティ専門家から事前に改善課題が指摘され、現場でも対応が進められていたと説明しました*4。一方、サービスの可用性への影響や他案件との優先順位などから、必要な対策を十分かつ迅速に実施できなかったとしています。この説明は、技術的な侵入経路の特定とは別に、セキュリティ上のリスクを把握した後の対応判断や、対策の優先順位付けという組織的な課題を示すものです。

企業は認証情報とログの所在を把握する

企業が外部のクラウドサービスを利用する際は、どの部署が、どの業務で利用し、どのような情報や認証情報を保存しているかを把握しておくことが重要です。サービス名や契約担当者だけでなく、利用アカウントや接続先まで整理することで、インシデント発生時に確認すべき範囲を特定しやすくなります。

IPAは2026年10月9日に出した注意喚起「不正アクセスによる漏えい等の事案を踏まえ、速やかに実施すべき対策等について」で、部署単位で利用する外部サービスも含めた把握と、ログやアカウントの異常確認を求めています。企業は、ログの保存期間や事業者・利用者それぞれが確認できる範囲を把握し、不審なログインやアカウント変更などの異常を確認できる体制を整えておく必要があります。

クラウドの停止を前提に業務継続の手順を整える

クラウドサービスが停止した場合、企業は影響を受ける業務と、停止中も継続できる業務を把握する必要があります。復旧を待つだけでなく、代替環境への移行や一時的な業務停止について、あらかじめ判断基準と対応手順を定めておくことが重要です。IPAの「中小企業のためのクラウドサービス安全利用の手引き」では、サービス停止時の業務への影響、サービス水準、データの保管・取り出し、サポート体制などの確認を促しています。バックアップの有無だけでなく、必要なデータや設定を取り出し、代替環境で利用できるかを確認しておくことが、業務継続に向けた備えとなります。

調査と業務復旧の判断を専門家と進める

クラウドサービスや端末への侵害が疑われる場合、被害範囲の特定や証拠保全を進めながら、業務復旧に向けた対応を検討する必要があります。ブロードバンドセキュリティ(BBSec)では、デジタルフォレンジック調査を通じて、インシデントの原因や影響範囲の調査、証拠保全、再発防止に向けた支援を提供しています。不正アクセスや情報漏洩が懸念される場合は、確認済みの事実や対象システム、取得可能なログを整理したうえでご相談ください。

BBSec緊急対応支援サービスページリンクバナー

【参考情報】

編集責任:木下

ウェビナー開催のお知らせ

最新情報はこちら

Security NEWS TOPに戻る
バックナンバー TOPに戻る

IDCFクラウドへのランサムウェア攻撃がJR東日本グループにも影響 ―情報漏洩の調査結果と事業継続の課題

Share
IDCFクラウドへのランサムウェア攻撃がJR東日本グループにも影響アイキャッチ画像

クラウドへのサイバー攻撃は、サーバーの停止にとどまらず、サービスを利用する企業の顧客対応や情報管理にも影響します。2026年10月9日、JR東日本とビューカードは、IDCフロンティアへの不正アクセスに伴うメール配信への影響と、個人情報が漏洩した可能性を公表しました。その後、10月15日には、両社とも個人情報の漏洩はなかったと判断した旨の報告を受けたと発表しています。一方、クラウド基盤の障害は多くの利用企業に影響し、バックアップや復旧体制の重要性を浮き彫りにしました。本記事では、各社の公表資料をもとに、クラウド利用企業が点検したい情報保護と事業継続の課題を整理します。

※本記事は2026年10月19日時点で公表されている情報をもとに作成しています。

IDCFクラウドの障害と 利用企業への影響

IDCフロンティアは10月8日の第3報で、10月7日未明から発生した障害の原因を、第三者によるランサムウェア攻撃と説明しました。対象はIDCFクラウド東日本リージョン1の一部で、仮想サーバーの停止や再起動できない事象が発生し、利用する495の企業・自治体に影響したとしています。同社は対象環境の顧客データについて取り出しや復元が困難との見通しを示していました。しかし、10月14日の第5報では、スナップショット機能を利用していた194顧客について、バックアップデータの取り出しが可能であることを確認したと発表しました。対象となる495の企業・自治体のうち、これらの顧客には復元の可否やデータの提供方法について個別に連絡しています。

また、第5報では、障害の影響を受けた仮想サーバー内のデータについて、外部への持ち出しを示す痕跡などは確認されず、データ流出はなかったと判断したことを公表しました。一方、IDCFクラウドポータルでは48社の登録情報に対する不正な照会が確認されています。ただし、これらの情報が外部へ持ち出された痕跡は確認されていません。

10月9日の第4報では、親会社のソフトバンクと連携した対応体制を公表しています。さらに、10月18日の第6報では、安全性を確認した「IDCFクラウド バックアップ」の提供再開を発表しました。なお、スナップショット機能は引き続き提供を停止しています。IDCFクラウド TypeSとIDCFプライベートクラウドは、本事象の対象外とされています。

えきねっと・大人の休日倶楽部・VIEW’s NETへの影響と調査結果

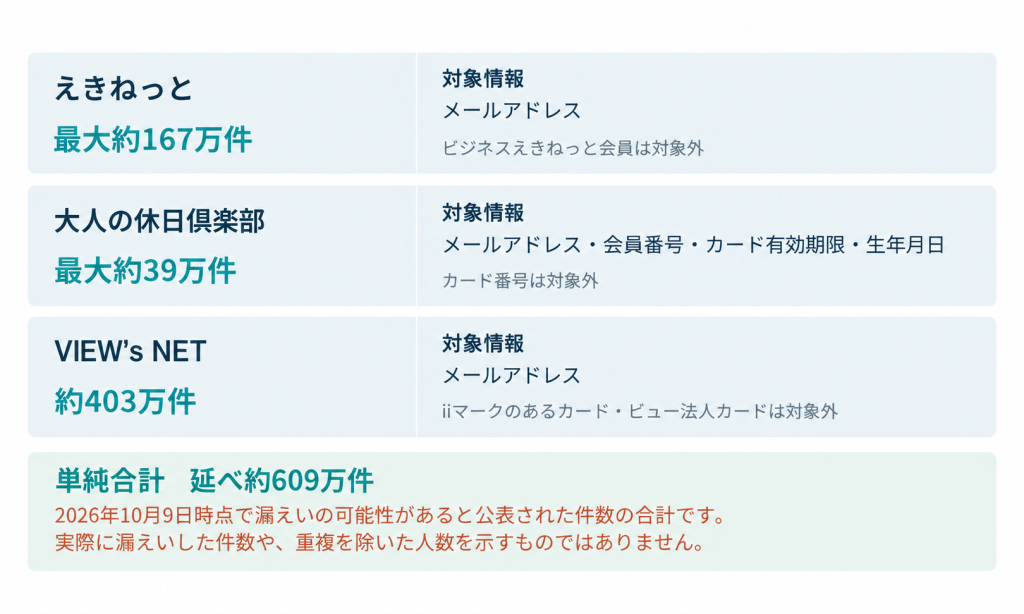
JR東日本は10月9日、えきねっと会員約167万件、大人の休日倶楽部会員約39万件を対象に、個人情報が漏洩した可能性を公表しました。メール配信用外部サービスが一部利用できなくなり、メールアドレスを含む電子メールログデータなどが閲覧・取得された可能性を否定できないとしていました。対象情報は、えきねっとではメールアドレス、大人の休日倶楽部ではメールアドレス、会員番号、クレジットカード有効期限、生年月日です。ただし、10月15日には、メール配信用外部サービス会社から、これらの個人情報の漏洩はなかったと判断した旨の報告を受けたと発表しています。

またビューカードも10月9日、VIEW’s NET登録者向けメール配信への影響と、約403万件のメールアドレスが漏洩した可能性を公表しました。その後、10月15日には、メールアドレスの漏洩はなかったと判断した旨の報告を受けたと発表しています。

図:JR東日本・ビューカードが当初公表した漏洩可能性の対象件数

えきねっと約167万件、大人の休日倶楽部約39万件、VIEW’s NET約403万件の対象情報の違い。単純合計は延べ約609万件でいずれも漏えい可能性。
出典:JR東日本・ビューカードの2026年10月9日および10月15日の公表資料をもとに弊社作成
※件数は2026年10月9日時点で漏洩の可能性があると公表された情報の単純合計であり、実際の漏洩件数や重複を除いた人数ではありません。
※2026年10月15日、JR東日本およびビューカードは、個人情報の漏洩はなかったと判断した旨の報告を受けたと発表しています。

メールログも 保護すべき顧客情報として扱う

今回、JR東日本は当初、電子メールログデータなどが閲覧・取得された可能性を公表しました。その後、個人情報の漏洩はなかったと判断した旨の報告を受けたと発表していますが、顧客情報の保護を考えるうえでは、会員データベースだけでなく、メール配信に利用する外部サービスやログも確認対象となります。NCSCのクラウドセキュリティ原則でも、認証情報や設定情報に加え、ログや派生するメタデータを保護する重要性が示されています。

自社で見直す際には、どのログに個人情報が入るのか、誰が閲覧できるのか、どの目的でどれだけ保存するのかを整理します。業務記録として残す情報と、事故調査のために必要な監査記録を把握し、漫然と蓄積しない運用へつなげることが実務上のポイントです。同時に、調査に必要な記録まで消してよいわけではありません。NCSCは、監査情報の入手方法や保存期間を確認し、改ざん・削除から保護することを求めています。ログは情報資産であり、事故を調べる証拠でもあるため、保存と保護の両方を設計する必要があります。

バックアップは 使えない状況を想定して確かめる

IDCフロンティアは当初、対象環境の顧客データの取り出しや復元は困難との見通しを示していましたが、10月14日の第5報では、一部顧客のバックアップデータを取り出せることが確認されました。さらに、10月18日には「IDCFクラウド バックアップ」の提供再開が公表されています。この経過は、バックアップの有無だけでなく、障害発生時に実際に利用できるかを確認する重要性を示しています。自社の備えを点検する際は、元の環境が停止した状態でもバックアップを取り出し、復元できるかを確かめる必要があります。

NCSCのSaaS利用ガイダンスでは、重要データの保護されたバックアップを持つことに加え、元のデータを襲った事故が全バックアップにも及ばない構成を求めています。自社のクラウド運用へ応用するなら、保管先の分離だけでなく、バックアップを操作できる権限や認証への依存も点検対象です。復旧の手順には、別環境を誰が準備するか、どの時点のデータへ戻すか、業務再開を誰が承認するかまで含めます。実際に取り出して復元し、業務が動くところまで確認して初めて、計画の不足が見えてきます。サイバー攻撃では原因調査や封じ込めと復旧を調整する必要があるため、通常の機器故障と同じ手順でよいかも見直したい点です。

配信停止時の顧客対応と 漏洩調査を並行する

メール配信ができない場合、案内する内容だけでなく、伝える手段の確保が課題になります。企業の対応計画では、顧客向けメールの停止と情報漏洩の疑いが同時に起きる場面を想定し、公式サイトなどの代替窓口と、問い合わせを受ける担当を定めておきます。

利用者への案内では、確定した情報と調査中の事項を区別することが重要です。今回、JR東日本とビューカードは当初、個人情報の漏洩の可能性を公表しましたが、その後の調査結果を受けて、漏洩はなかったと判断した旨を追加公表しています。このように、調査の進展によって公表内容が変わる場合もあるため、利用者に最新の状況を正確に伝える体制が必要です。また、対象者への通知では、正規の案内かどうかを確認できる方法を示すことも大切です。クラウド事業者の復旧報告を待つだけでなく、自社の顧客対応をどの条件で進めるか決めておく必要があります。

BBSecのIT-BCP策定支援で 復旧できる計画へ

クラウド利用を前提にした事業継続計画では、利用環境の停止、データの復元、顧客への連絡を一緒に検討します。ブロードバンドセキュリティ(BBSec)の「ランサムウェアに対応したIT-BCP策定支援」は、サイバー攻撃を想定したIT-BCPの策定・見直しを支援するサービスです。現状のシステム分析を踏まえた計画策定支援や、企業主体の取り組みにコンサルタントが伴走するメニューを提供しています。また、復旧段階を中心とした「IT-BCP発動演習ワークショップ」もあります。[8] 自社の計画にクラウド停止を織り込めているか、バックアップからどの手順で業務を戻すかを具体化したい場合は、BBSecへご相談ください。平時の計画と演習を通じて、判断や作業が止まる箇所を明らかにしておくことが、事業継続への備えになります。

【参考情報】

編集責任:木下

ウェビナー開催のお知らせ

最新情報はこちら

Security NEWS TOPに戻る
バックナンバー TOPに戻る

Commune不正アクセスで約30.7万人の情報漏洩 ―利用企業が見直すべきSaaS管理

Share
Commune不正アクセスで約30.7万人の情報漏洩アイキャッチ画像

顧客や会員との交流を支えるコミュニティサービスで、個人情報の漏洩が発生しました。コミュニティサービス「Commune」「Commune for Work」を提供するコミューン株式会社は2026年10月9日、両サービスへの不正アクセスにより、推計約30.7万人の会員情報が漏洩したと公表しています*5。利用企業からも影響が公表されていますが、対象情報や漏洩の確認状況は各社で異なります。本記事では公表情報をもとに、事件の概要と、企業がSaaSを使う際に見直したい管理のポイントを整理します。

Communeで何が起きたのか

コミューンの発表では、非公開コミュニティの招待リンクが不正に取得され、一般会員としての登録が行われたほか、管理者へのなりすましによって会員情報の閲覧・取得やデータの上書きが行われました。今回の事案では、コミュニティへの参加方法と管理者権限の両方が確認すべきポイントとなります。約30.7万人は、コミューンの従業員・テスト用デモアカウントも含む推計です。また利用企業の設定や運用が原因ではないと説明しています。個々の利用者への影響は、参加するコミュニティと登録情報によって異なります。

なお同社は、10月13日、10月9日の公表以降に新たな不正アクセスや情報漏洩は確認されていないものの、引き続き調査と対応を進めていると発表しています。悪用された脆弱性の種類や認証の仕組みについて、詳細は明らかにされていません。

LINEヤフーとSansanで異なる情報漏洩の確認状況

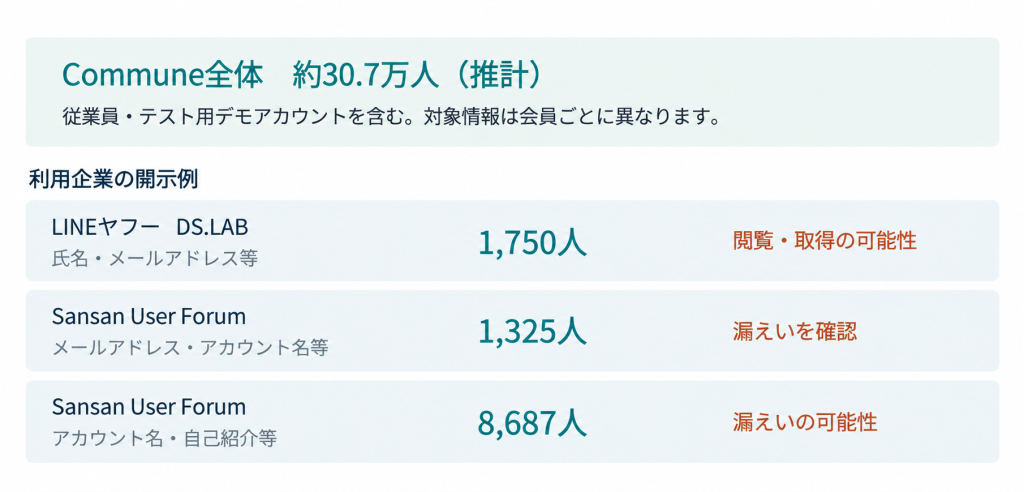
LINEヤフーは、「DS.INSIGHT」内のコミュニティ機能「DS.LAB」の利用者1,750人について、情報が閲覧・取得された可能性を公表しました*2。対象には氏名、メールアドレス、自己紹介、所属グループなどが含まれます。同社のシステムへの不正アクセスは確認されておらず、コミューンが運営するサーバーで起きた事案と説明しています。

Sansanは「Sansan User Forum」について、漏洩を確認した1,325人と、漏洩の可能性がある8,687人を分けて公表しました*3。前者の対象情報にはメールアドレス、アカウント名、自己紹介、プロフィール画像、グループ所属情報が含まれ、後者はメールアドレスを除くこれらの情報が対象です。また、営業AXサービス「Sansan」など、同社の各サービスやそこで預かる情報への影響はないと説明しています。

今回の事案では、利用企業ごとに対象情報や漏洩の確認状況が異なります。情報漏洩の影響を判断する際には、対象となったサービスや情報の種類、漏洩が確認されているかどうかを区別することが重要です。

図:Commune事案の影響をサービスごとに確認

Commune全体の推計約30.7万人と、DS.LABの1,750人の漏えい可能性、Sansan User Forumの1,325人の漏えい確認および8,687人の漏えい可能性を区別した図
出典: コミューン株式会社、LINEヤフー株式会社、Sansan株式会社の2026年10月9日公表資料、およびコミューン株式会社の2026年10月13日公表資料をもとに弊社作成
※各社の対象人数は全体推計に加算していません。対象情報・漏洩の確認状況は各社の公表内容に基づきます。コミューンは10月13日、10月9日の公表以降、新たな不正アクセスや情報漏洩は確認されていないと発表しています。

SaaSの権限管理ではアクセスと操作の範囲を分けて考える

ここからは、今回の事案を踏まえて見直したい一般的なSaaSセキュリティ対策です。英国国家サイバーセキュリティセンター(NCSC)は、クラウドの安全性を評価する観点として、顧客間の分離、安全な利用者管理、認証、管理機能の保護を挙げています。ログインができることと、会員情報の一括取得や権限変更が許されることは、別々に制御しなければなりません。利用企業は、管理者を必要な担当者に限定し、退職や担当変更に応じてアクセス権を見直します。提供事業者に対しては、一般会員と管理者の境界や、顧客ごとのデータの境界を、どのように検証しているか確認することが重要です。

なお、今回の事案でテナント間の分離が破られたと確認されたわけではありません。多要素認証も有効な基本対策ですが、認証を強めればあらゆる権限の問題が解決するわけではありません。NCSCのSaaS利用ガイダンスを参考に、認証と権限設定をあわせて確認し、不要な機能や不要になった利用者のアクセスを残さない運用を整えましょう。

SaaSで扱う情報と事故調査に必要なログを把握する

SaaSを導入した部署が、登録項目や連携先を追加することもあります。契約時の評価だけで終えず、現在どの情報を扱っているのかを確認することが出発点です。会員登録の必須項目だけでなく、自由記述の自己紹介、追加プロフィール、画像に何が含まれ得るかまで運営担当者と整理します。事故への備えでは、監査ログを「保存しているか」だけで判断できません。NCSCは、利用企業が調査に必要な監査情報を入手できること、その提供方法や保存期間を把握していること、記録が改ざん・削除から保護されることを重視しています。会員情報へのアクセスや設定変更の履歴を、誰がどの手順で取り出せるのか、導入時から確認しておく必要があります。

連絡の受け手も決めておきたいところです。通知が契約担当者だけに届いても、運営の停止や会員への案内を判断する部署へ伝わらなければ対応が遅れます。SaaS事業者からの通知を、情報システム部門と実際の運営部門の双方が受け取り、対象者と対象情報の確定状況を同じ記録で追えるようにします。NCSCも、サービス全体の障害を含めた対応手順と、有効な連絡先の準備を求めています。

利用者には確認済みの情報を正確に伝える

利用者には、自分が参加するコミュニティの運営企業の公式発表を確認してもらうことが基本です。LINEヤフーは、本件に便乗する不審なメールやメッセージへの注意を呼びかけ、心当たりのないリンクを開いたり個人情報を入力したりしないよう案内しています。お詫びメールを装う連絡も想定し、正規の問い合わせ先と確認方法を明示すると、利用者が判断しやすくなります。一方で、漏洩項目に含まれない情報まで「流出した」と知らせるべきではありません。今回のSansanの発表でも、パスワードは対象外と明記されています。調査中の事項は調査中と伝え、対象範囲が変わった場合に更新する運用が必要です。


クラウド利用の管理体制を BBSecと見直す

SaaSの安全な利用には、技術的な設定と、委託先との役割分担・社内規程を結び付ける作業が欠かせません。ブロードバンドセキュリティ(BBSec)が提供している「ISO/IEC 27017 クラウドセキュリティ認証取得支援」は、クラウドの提供事業者と利用事業者を対象とし、現状のアセスメント、規格とのギャップ把握、規程文書の整備、社員教育を支援します。クラウドサービスの管理状況を把握し、権限管理や事故対応のルールを含めた管理体制の整備を検討される際は、BBSecへご相談ください。

【参考情報】

編集責任:木下

ウェビナー開催のお知らせ

最新情報はこちら

Security NEWS TOPに戻る
バックナンバー TOPに戻る

盗まれたトークンから約3時間でクラウド管理権限へ ―AnthropicのAI悪用報告から考える企業の対策

Share
AnthropicのAI悪用報告から考える企業の対策アイキャッチ画像

生成AIの活用が広がる一方で、サイバー攻撃にAIを悪用する動きも確認されています。Anthropicが2026年9月10日に公表したAI悪用の調査報告には、盗まれた開発者トークンを足掛かりに、攻撃者が被害組織のクラウド環境の完全な管理権限を約3時間で取得した事例が記されています。AIサイバー攻撃への備えを考えるうえで、この事例は、認証情報の保護と、検知後に動ける体制を点検する材料となります。

AnthropicのAI悪用報告で何が確認されたのか

今回の報告では、2025年12月から2026年8月にかけてAnthropicが検知・対処したAI悪用活動が取り上げられています。サイバー攻撃におけるAIの使われ方には幅があり、攻撃者の補助として利用された例に加え、偵察、侵入、認証情報の収集、情報窃取などをAIに実行させる例や、複数の標的に対してAIエージェントが並行して処理する例も確認されています。一方、標的の選定や攻撃結果の確認、収益化などの重要な判断には、人間が引き続き関与していたとされています。

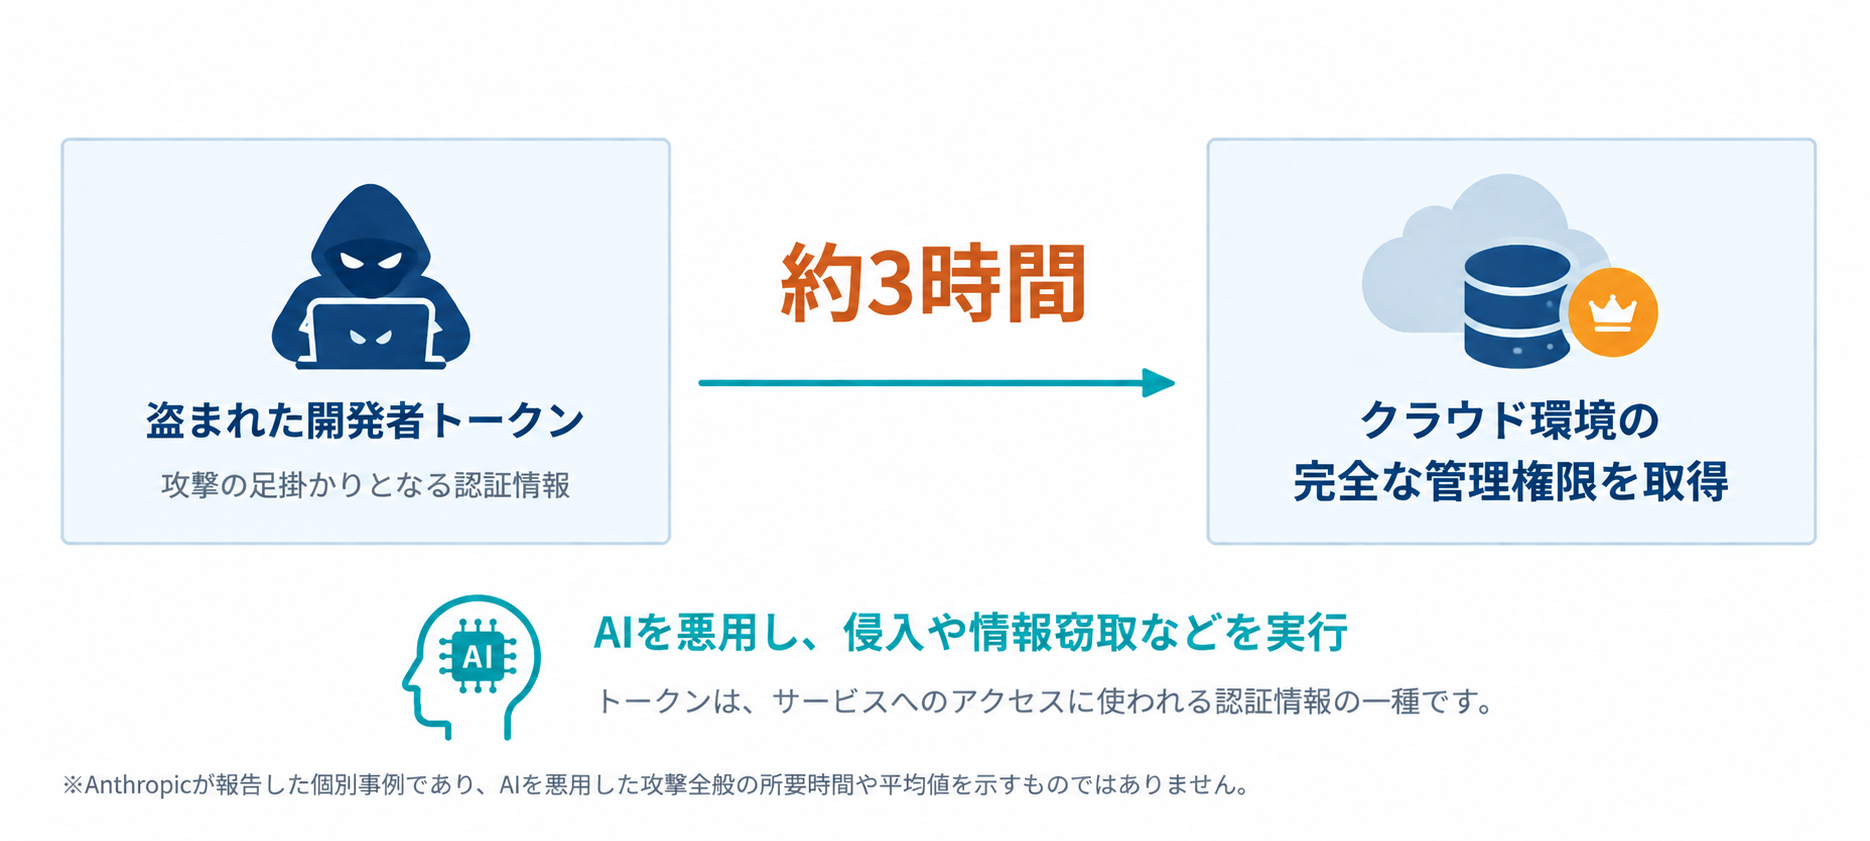
報告には、認証情報の悪用に関する事例も複数示されています。被害組織の環境から盗んだAIサービスのAPIキーを別の攻撃に利用した例に加え、盗まれた開発者トークンを足掛かりに、被害組織のクラウド環境の完全な管理権限を約3時間で取得した事例も報告されています。認証情報は情報を盗む入口となるだけでなく、攻撃に用いるAIの計算資源へのアクセスにも利用されていました。*4

なお、約3時間という数値は、Anthropicが観測した個別の侵害事例に関するものです。すべてのAIを使った攻撃が同じ速さで進むことや、従来の攻撃より何倍速いかを示す統計ではありません。この事例から企業が考えるべきなのは、約3時間という時間そのものではなく、認証情報が悪用された場合に、異常を検知し、調査やアクセス制限などの対応へ移るまでにどの程度の時間を要するかという点です。

図1:AI悪用による侵入の個別事例

開発者トークンから管理権限取得までの個別事例
出典:Anthropic「Detecting and countering misuse of AI: September 2026」(https://www.anthropic.com/threat-intelligence-report-september-2026)を基に作成

認証情報漏洩への対策は、トークンの権限まで確認する

認証情報の管理を見直すときは、人がログインに使うパスワードに加え、アプリケーションや開発環境が使うアクセスキー、トークンも対象にします。ここからは、クラウド環境で取り組める対策をAWSの公式資料を例に整理します。前述の被害事例のクラウド事業者をAWSと特定するものではありません。

AWSはIAMの推奨事項として、一時的な認証情報の利用、多要素認証(MFA)、業務に必要な範囲に絞った権限付与、使われていない認証情報や権限の定期的な見直しを挙げています*2。システムが継続的に使う認証情報についても、長期のアクセスキーを配布する構成から、IAMロールによる一時的な認証情報へ移行できるかを検討します。自社で点検する際は、認証情報を誰が管理し、どのシステムが使い、どのデータにアクセスできるのかを確認し、用途が終わったテスト用の権限や、担当者の異動後も残る認証情報などを整理します。認証情報の保護とあわせて、必要以上の権限を与えないことが重要です。

クラウドのログは、データへの操作まで記録されているか

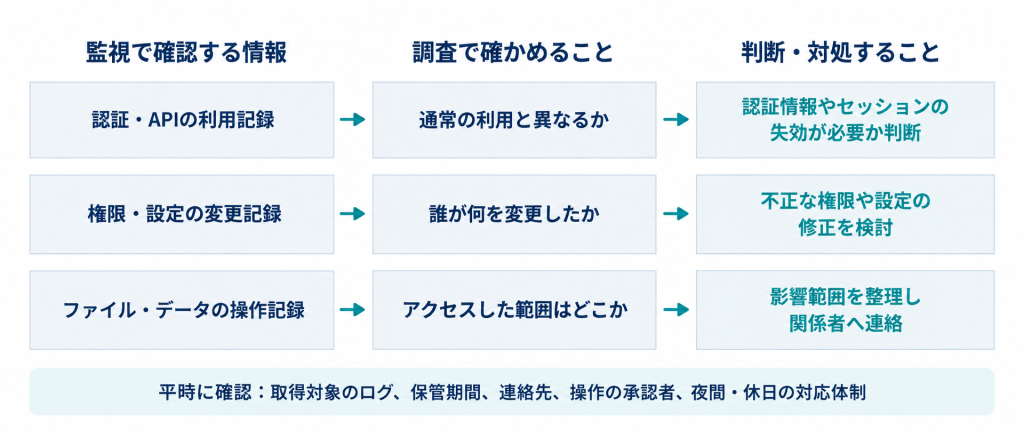
クラウド監視では、「ログを取得している」だけでなく、実際にどの操作まで記録されているかを確認する必要があります。例えばAWS CloudTrailでは、Amazon S3上のオブジェクトの読み取りなどはデータイベントに分類され、証跡やイベントデータストアでは初期設定で記録されないため、取得には設定と追加料金が必要です*3。自社の重要データについて、調査時に確認したい操作が記録に残るかを点検し、顧客データを保管する領域であれば、誰が、いつ、どのデータへアクセスしたかを追える設定になっているかを確認します。大量のログを一律に増やすのではなく、守るべきデータと必要な調査項目を先に決めると、取得範囲や費用も検討しやすくなります。

また、アクセスがあったという事実だけで、不正利用とは断定できません。AWSのGuardDutyの対応ガイドも、検知に関係するユーザーやロール、API操作を特定し、操作時刻や接続元IPアドレスを含めて正当な利用か確認するよう案内しています*4。担当者がこれらを照合できる情報と連絡先を持つことが、アラートを判断につなげる前提になります。

検知後は、どの認証情報の利用を止めるか判断する

認証情報の不正利用が疑われる場面では、影響するユーザーやロールと、その権限を特定する必要があります。API操作の内容を見れば、正常な処理との違いや調査すべき範囲を検討できます。確認の結果、正当な利用と判断できない場合は、該当するクラウドサービスの手順に沿って封じ込めを進めます。

ここで注意したいのが、すでに発行された一時的な認証情報の扱いです。AWSは、不正利用を止める手段として、一時的な認証情報に付与される権限の変更や、IAMロールの既存セッションの取り消し方法を説明しています*5。対象のロールを利用する正常なユーザーにも影響する場合があり、どの利用を止めるかを区別することが必要です。

緊急時の手順には、実行する操作だけでなく、その操作で停止する業務と、判断を行う担当者も記載しておきます。「認証情報を無効にする」とだけ書かれた手順を、自社のアカウントやサービスに当てはめて確認する作業です。担当部門が異なる場合も、現場で判断できる範囲をあらかじめ合意しておくことが、連絡待ちを減らすための実務的な準備になります。

図2:認証情報の悪用に備える監視と初動対応

出典:AWS「Remediating potentially compromised AWS credentials」(https://docs.aws.amazon.com/guardduty/latest/ug/compromised-creds.html)「Disabling permissions for temporary security credentials」(https://docs.aws.amazon.com/IAM/latest/UserGuide/id_credentials_temp_control-access_disable-perms.html)「SEC10-BP07 Run simulations」(https://docs.aws.amazon.com/wellarchitected/latest/framework/sec_incident_response_run_game_days.html)を基に弊社作成

「対応できるはず」を訓練で確かめる

検知から対応までの時間を短くしたいなら、まず自社の手順を一度動かして確かめることです。AWSのWell-Architected Frameworkでは、インシデント対応能力を評価する方法として演習を挙げ、机上演習では関係者の役割や責任、連絡手段、手順書を確認できると説明しています。*6

例えば「夜間に、通常と異なる認証情報の利用が通知された」という場面を設定し、担当者に連絡が届くか、正当な作業かを確認できるか、アクセス制限を誰が判断するかを話し合います。これは本稿で提案する訓練の例です。連絡先の更新漏れや判断権限の曖昧さが見つかれば、実際のインシデントが起こる前に修正できます。

演習では、通知を確認した時点、調査を始めた時点、対応を決めた時点を分けて記録すると、改善すべき箇所を具体化できます。約3時間という他社事例をそのまま自社の目標時間にするのではなく、自社の重要業務と運用体制に即して、対応を遅らせる要因を取り除くことが大切です。


監視からインシデント対応まで、セキュリティ体制を見直したい企業へ

こうした体制を自社だけで維持することが難しい場合は、監視や分析、対応を専門家と分担する方法があります。ブロードバンドセキュリティ(BBSec)の「G-MDR®」では、セキュリティ対策を統合的に監視・相関分析し、専門エンジニアが24時間365日体制で監視・運用を支援します。アラートの検知だけでなく、その後の調査や対応を含めたセキュリティ体制についてもご相談いただけます。

※外部サイトにリンクします。

セキュリティ対策について相談する

「アラートは検知できても、その後の調査や対応に不安がある」「24時間365日の監視体制を整えたい」といった課題がある場合は、BBSecまでお気軽にご相談ください。

導入を検討する際は、自社のクラウド環境や既存製品から連携できるログ、検知後に実行する対応、社内の承認が必要な操作を具体的に相談するとよいでしょう。すべてのクラウドサービスや復旧作業が無条件に対象になると考えず、自社に必要な監視範囲と対応範囲を確認することが大切です。


【参考情報】

編集責任:木下


ウェビナー開催のお知らせ

最新情報はこちら


Security NEWS TOPに戻る
バックナンバー TOPに戻る

DoS攻撃とDDoS攻撃の違いとは?仕組み・被害・対策を比較解説

Share
DoS攻撃とDDoS攻撃の違いとは?アイキャッチ画像

DoS攻撃とDDoS攻撃は、Webサイトやサーバーに大量の通信を送り付け、サービスを利用しにくくしたり、停止させたりするサイバー攻撃です。

どちらもサービス妨害を目的とする攻撃ですが、攻撃元の数や規模、検知・防御の難しさには大きな違いがあります。特にDDoS攻撃は、多数の端末から同時に通信が送られるため、正規のアクセスとの見分けが難しく、企業のWebサービスや業務システムに大きな影響を及ぼすおそれがあります。

本記事では、DoS攻撃とDDoS攻撃の仕組みや違い、企業に及ぼす被害、対策のポイントについて比較しながら解説します。

DDoS攻撃の基本的な仕組みや種類について知りたい方は、こちらの記事をご覧ください。「DDoS攻撃とは?仕組み・種類・被害・対策を企業向けに解説」

DoS攻撃とは

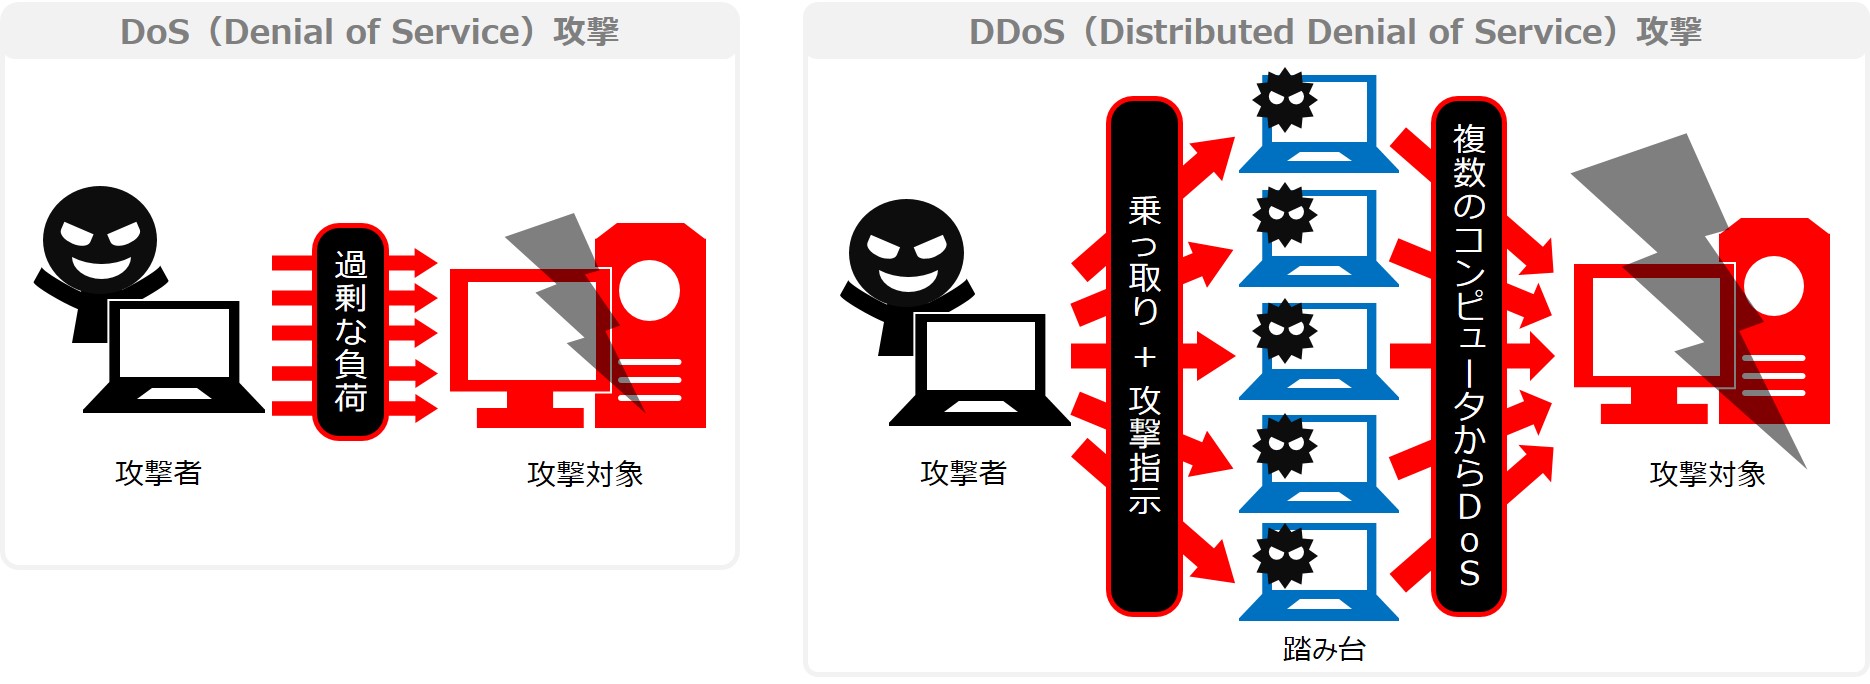
DoS攻撃とは、「Denial of Service attack」の略称で、サーバーやネットワーク機器に過剰な負荷をかけ、サービスを利用できない状態にするサイバー攻撃です。

攻撃者は、特定のWebサイトやサーバに対して大量のリクエストやデータを送り付けます。処理能力や通信容量を超える負荷が発生すると、システムの応答が遅くなったり、サービスが停止したりする可能性があります。

一方で、単純に大量の通信を送るだけでなく、Webアプリケーションやネットワーク機器の脆弱性、設定不備を悪用して、少ない通信でシステムを停止させる攻撃もあります。

例えば、次のような問題がDoS攻撃に悪用される可能性があります。

  • 極端に長い文字列を処理してしまう
  • アップロードできるファイル容量に上限がない
  • 短時間に送信されるリクエスト数を制限していない
  • ネットワーク機器やソフトウェアに脆弱性が残っている
  • 不要なサービスやポートが外部に公開されている

このような脆弱性や設定不備に起因するDoS攻撃については、システムの修正や設定の見直しによって、発生リスクを抑えることが可能です。

DDoS攻撃とは

DDoS攻撃とは、「Distributed Denial of Service attack」の略称で、複数の端末から一斉にDoS攻撃を行う手法です。

Distributedは”分散された”という意味であり、攻撃者は多数の端末を利用して、対象となるWebサイトやサーバーに大量の通信を送り付けます。

DDoS攻撃では、マルウェアに感染したパソコンやサーバー、ルーター、ネットワークカメラ、IoT機器などが攻撃に利用されることがあります。攻撃者の指示によって遠隔操作される端末の集まりは、ボットネットと呼ばれます。

端末の所有者が、自分の機器が攻撃に利用されていることに気づいていないケースも少なくありません。攻撃者は、こうした多数の端末から同時に通信を発生させることで、大規模な攻撃を実行します。

DDoS攻撃では、攻撃元となるIPアドレスが多数存在するため、特定の通信だけを遮断することが困難です。また、一般の利用者による正規のアクセスと攻撃通信が混在することもあり、単純なアクセス制限では対応できない場合があります。

そのため、DDoS攻撃への対応には、通信量の監視やアクセス制御だけでなく、CDN、WAF(ウェブアプリケーションファイアウォール)、DDoS対策サービス、クラウド側の防御機能などを組み合わせた対策が必要です。

DoS攻撃とDDoS攻撃の違い

Dos攻撃/DDos攻撃とはのサムネ
DoS攻撃/DDoS攻撃の概要図

DoS攻撃とDDoS攻撃は、どちらもサービスの停止や遅延を引き起こす攻撃です。大きな違いは、攻撃元の数と攻撃規模にあります。

DoS攻撃では、攻撃元が限られている場合、特定のIPアドレスを遮断することで対応できる可能性があります。

一方、DDoS攻撃では、数多くの端末から通信が送られるため、攻撃元を一括して遮断することが難しくなります。正常な利用者の通信まで遮断してしまうと、自らサービスを停止させる結果にもなりかねません。

また、DDoS攻撃は、大量の通信を送り付けるだけでなく、Webサーバーやアプリケーションに負荷の高い処理を繰り返させる形で実行されることもあります。

そのため、通信量だけを監視するのではなく、アクセスパターンやリクエスト内容、処理負荷なども含めて異常を検知する必要があります。

なぜDDoS攻撃が脅威なのか

DDoS攻撃が企業にとって大きな脅威となる理由は、攻撃規模が大きいことだけではありません。攻撃元が分散しており、正規のアクセスとの見分けが難しい点にあります。

多数の端末から同時に攻撃される

DDoS攻撃では、ボットネットに組み込まれた多数の端末が利用されます。

攻撃元が世界中に分散している場合、個別のIPアドレスを遮断しても、別の端末から攻撃が続く可能性があります。

また、攻撃元となる端末の多くは、一般の企業や個人が利用しているパソコン、サーバー、IoT機器などです。そのため、単純に特定の国や地域からの通信を遮断するだけでは、攻撃を防げないことがあります。

正規のアクセスと区別しにくい

DDoS攻撃には、ネットワーク回線を大量の通信で埋め尽くす攻撃だけでなく、通常のWebアクセスとよく似たリクエストを繰り返す攻撃もあります。

例えば、検索機能やログイン画面、商品一覧、APIなど、サーバー側で比較的大きな処理が必要となる機能にアクセスを集中させる手法です。

通信そのものは通常のアクセスと似ているため、攻撃だけを正確に遮断することが難しくなります。

短時間でも大きな損失につながる

Webサイトやオンラインサービスが停止すると、企業にはさまざまな影響が生じます。

  • 商品やサービスの販売機会を失う
  • 顧客がサービスを利用できなくなる
  • コールセンターや問い合わせ窓口への連絡が増える
  • 復旧対応や原因調査に人的コストがかかる
  • 顧客や取引先からの信用が低下する
  • SLA違反や契約上の問題が発生する

ECサイトや予約サービス、金融サービス、オンラインゲーム、SaaSなど、インターネット上でサービスを提供する企業では、短時間の停止でも売上や顧客満足度に大きな影響を与える可能性があります。

別の攻撃と同時に行われることがある

DDoS攻撃は、単独で実行されるとは限りません。

大量のアラートや障害対応によって企業の担当者を混乱させ、その間に別のシステムへの不正アクセスを試みるなど、陽動目的で利用される可能性もあります。

DDoS攻撃が発生した場合には、サービス復旧だけに集中するのではなく、不審なログインや設定変更、マルウェア感染、情報漏えいなど、別の異常が発生していないかも確認することが重要です。

企業が取るべき対策

DoS攻撃やDDoS攻撃を完全に防ぐことは容易ではありません。特に大規模なDDoS攻撃では、自社のサーバーやネットワーク機器だけで防御することは難しく、通信が自社環境に到達する前の段階で対処する必要があります。重要なのは、単一の製品や設定だけに依存せず、複数の対策を組み合わせることです。

  1. 必要のないサービス・プロセス・ポートは停止する
  2. OSや機器、ソフトウェアを更新する
  3. リクエスト数やデータ容量を制限する
  4. CDNやDDoS対策サービスを利用する
  5. 脆弱性対策が施されたパッチを適用する
  6. WAFを導入する
  7. システムを冗長化する
  8. 通信状況を監視する
  9. 脆弱性診断を実施する
  10. DoS攻撃/DDoS攻撃の端緒になりうる各種の不備を見つけて直す

自組織のセキュリティ状況を見直し、リスク状況を把握することにより、攻撃に備えることが大切です。どの対策のほうがより効果があるということではなく、それぞれ防御するレイヤーが異なるので複数組み合わせていく、「多層防御」がより効果的です。

WAF(ウェブアプリケーションファイアウォール)

WAFでは大量に不正に送信される大量のパケットのブロックや、一時的にアクセスが集中した際にはサーバが停止する前にアクセスの制限をかけるなどができます。また、適切なシグネチャ(Webアプリケーションへのアクセスパターンの定義ファイル)を設定しておくことで、攻撃コードの送信を検知して攻撃コードがアプリケーションに届く前に不正なコードの送信としてWAFで止めることが可能になります。

Webアプリケーション脆弱性診断

脆弱性診断を行うことで予め管理しているWebアプリケーションの脆弱性状況を把握し、脆弱性の修正を行うことによってスキャンされた際に脆弱性情報としてハッカーの目に留まることを防げます。脆弱性を悪用した攻撃についても同様でそもそも悪用できそうな脆弱性がない、という状態を維持することができます。

Webアプリケーション脆弱性診断のサービスバナー

脆弱性や設定不備に起因するDoS攻撃は予防できる

DoS攻撃/DDoS攻撃は攻撃の発生に気づくのが難しいという話を記事内で述べましたが、一方で、防ぐことができるタイプの攻撃も存在します。

一部のWebサイトでは、「長大な文字列を受け入れてしまう」「ファイルの容量を制限しない」など、DoS攻撃につけ込まれてしまう問題が存在することがあります。また、ネットワーク関連の設定の不備によってDoS攻撃を受ける可能性も存在します。しかし、こうした脆弱性は、修正による回避が可能です。

また、あなたの企業が直接DoS攻撃の攻撃対象とならなくても、上述のような脆弱性を放置しておくとDDoS攻撃の踏み台にされることもあります。その対策としては、各種機器・OS・ソフトウェアの脆弱性管理を適切に行うことや、脆弱性診断等のセキュリティ診断を定期的に実施して未知のリスクを把握し、対処することが重要です。


ここで余談ではありますが、診断実施に伴う「あるある」エピソードを。
セキュリティ診断を行う際には、必ず、実施の年月日や時間帯を関連する部署に周知しなくてはなりません。実は、診断実施に伴って事業部門等が「DoS攻撃が発生した!」と勘違いすることが、しばしばあるのです。もちろん、一般にインターネット上に公開しているシステムの場合には業務に差し支えるような検査の仕方をしないというのが大前提ですが、それでも、大量の問合せ等が発生すると何も知らされていない担当部署はサイバー攻撃と勘違いすることがあります。ついでにこの際に抜き打ちで社内のサイバー訓練を・・・と目論みたい気持ちが出たとしても、それを実行に移すのは大変危険です。訓練は訓練させる側にきちんとした検証シナリオがあってこそ効果を発揮します。まずは関係各所との連携を徹底するところから始めましょう。


DDoS攻撃では、サービス復旧だけでなく、不正アクセスや情報漏えいの有無も確認することが重要です。初動対応の流れや確認すべきポイントについては、こちらの記事で詳しく解説しています。
「DDoS攻撃を受けたらどうする?―初動対応から復旧までの流れを解説―」

まとめ

DoS攻撃とDDoS攻撃は、どちらもサーバーやネットワークに負荷をかけ、サービスの遅延や停止を引き起こす攻撃です。

DoS攻撃は1台または少数の端末から行われることが多いのに対し、DDoS攻撃は多数の端末から同時に実行されます。

DDoS攻撃は、攻撃元が分散しているため特定や遮断が難しく、正規のアクセスと攻撃通信を見分けにくい点が特徴です。

企業は、CDNやWAF、DDoS対策サービス、システムの冗長化、通信監視などを組み合わせて、被害を抑える必要があります。

また、脆弱性や設定不備を悪用するDoS攻撃については、OSやソフトウェアの更新、不要なサービスの停止、アクセス制御の見直し、脆弱性診断などによってリスクを低減できます。

攻撃を完全に防ぐことだけを目指すのではなく、異常を早期に検知し、サービスへの影響を最小限に抑え、迅速に復旧できる体制を整えておくことが重要です。

公開日:2022年8月3日
更新日:2026年8月5日

編集責任:木下


資料ダウンロードボタン
年二回発行されるセキュリティトレンドの詳細レポート。BBSecで行われた診断の統計データも掲載。
お問い合わせボタン
サービスに関する疑問や質問はこちらからお気軽にお問合せください。

Security Serviceへのリンクバナー画像
BBsecコーポレートサイトへのリンクバナー画像
セキュリティ緊急対応のバナー画像

Security NEWS TOPに戻る
バックナンバー TOPに戻る

WordPress脆弱性「wp2shell」とは?影響・対象バージョン・対策を解説

Share
wp2shellとは?WordPress脆弱性の対象バージョンと対策アイキャッチ画像

2026年7月、WordPress Coreに存在する2件の脆弱性を悪用し、認証前から管理者権限の取得や任意コード実行(RCE)につながる攻撃チェーン「wp2shell」が公表されました。WordPress.orgは修正版を公開し、対象バージョンへの強制自動更新を有効化していますが、すでにPoCや実攻撃が確認され、米国サイバーセキュリティ・インフラストラクチャセキュリティ庁(CISA)も「Known Exploited Vulnerabilities(KEV)カタログ」へ登録しています。本記事では、wp2shellの対象バージョンや仕組み、確認されている攻撃、侵害確認のポイント、企業が取るべき対策を解説します。

※本記事は2026年7月24日までに公開された情報もとに作成しています。ご覧いただく時期によっては古い情報となっている場合もありますので、ご承知おきください。

まず確認したいポイント

  • 影響を受けるバージョン:WordPress 6.9.0~6.9.4、7.0.0~7.0.1(6.8.0~6.8.5もSQLインジェクションの影響あり)
  • 対応方法:修正済バージョン(WordPress 6.9.5/7.0.2/6.8.6)へ更新
  • 更新後の確認:稼働バージョンと侵害の有無(管理者アカウント・プラグイン・PHPファイル・ログ)

自動更新が有効でも、更新が正常に完了しているとは限りません。実際に稼働しているバージョンを確認し、修正前のバージョンを公開していた場合は、更新に加えて侵害の有無も確認する必要があります。

wp2shellの対象バージョン

wp2shellの影響範囲はWordPressのバージョンによって異なります。まずは利用中のバージョンが対象かどうかを確認してください。特にWordPress 6.8系について、「wp2shellのRCE対象外」と「今回の脆弱性の影響をまったく受けない」を混同しないことが大切です。

WordPressバージョンCVE-2026-60137CVE-2026-63030wp2shellによる未認証RCE修正済バージョン
6.8未満対象外対象外対象外今回の2件については対象外。ただし、サポート状況を踏まえ最新バージョンを推奨
6.8.0~6.8.5影響あり対象外対象外6.8.6
6.9.0~6.9.4影響あり影響あり影響あり6.9.5
7.0.0~7.0.1影響あり影響あり影響あり7.0.2
7.1 Beta 1影響あり影響あり影響あり7.1 Beta 2

WordPress.orgは重大性を踏まえ、影響を受けるサイトへの強制自動更新を有効化しました。ただし、自動更新が無効な環境や、ファイル権限・通信の問題で更新に失敗した環境、運用上の理由でバージョンが固定されている環境も考えられます。自動更新の設定ではなく、現在稼働中のバージョンを基準に影響を判断してください。

wp2shellとは

wp2shellは単独の脆弱性名や3件目のCVEではありません。WordPress Coreに存在するCVE-2026-60137とCVE-2026-63030を連鎖させ、認証前のSQLインジェクションから管理者権限の取得、さらに任意コード実行へつなげる攻撃チェーンの通称です。

脆弱性概要wp2shellでの役割
CVE-2026-60137WP_Queryのauthor__not_inパラメータに関するSQLインジェクション攻撃者がデータベース処理を不正に操作する足掛かりになる
CVE-2026-63030WordPress REST APIのバッチ処理で発生するルート混同本来の検証と異なる処理経路を使わせ、SQLインジェクションを認証前から到達可能にする

WordPressのREST APIには、複数のサブリクエストをまとめて処理するバッチ機能があります。脆弱なバージョンでは、サブリクエストの入力を検証したルートと、実際に処理するルートの対応関係がずれる場合があります。その結果、本来は型や値を検証されるはずの入力が、適切な検証を受けないままデータベース処理へ到達し、SQLインジェクションが成立します。

発見者が示したフルチェーンでは、SQLインジェクションを起点に複数のWordPress内部処理を悪用し、一時的に管理者権限でREST APIを実行させて新しい管理者アカウントを作成します。その後、プラグインのアップロード機能を悪用して任意コード実行へ至ります。

wp2shellは脆弱なプラグインやテーマを前提とせず、WordPress Coreの脆弱性を連鎖させる攻撃です。Searchlight Cyberは、「脆弱なプラグインを必要とせず、標準的なWordPress環境で成立し得る」と説明しています*7。一方、Cloudflareは、同社が確認したRCE経路について「永続オブジェクトキャッシュを使用していない場合」という条件を示しています*2。永続オブジェクトキャッシュを使用していても、SQLインジェクション自体の影響は残るため、構成にかかわらず、影響を受けるWordPress Coreは修正版へ更新することが重要です。

wp2shellの影響

GitHubで公開された「Icex0/wp2shell-poc」は、Searchlight Cyberの公式チェッカーではなく、第三者による独立したPoCです。公開されたPoCには、SQLインジェクションの確認から管理者アカウント作成、任意コード実行までを再現する機能が実装されています。

公開されたPoCには、SQLインジェクションの確認から管理者アカウントの作成、任意コード実行までを再現する機能が実装されています。これにより、攻撃の検証や自動化が容易になりました。PoCの利用は、許可を得た環境での検証に限定すべきです。

実攻撃とKEV登録状況

修正版の公開後、複数のPoCが公開され、実環境では悪性プラグインやWebシェルを設置する攻撃も確認されました。

Wizは7月20日、同社が可視化できるクラウド環境において、複数の攻撃者が脆弱なWordPressを悪用した事例を確認したと報告しました*3。観測された活動には、悪性WordPressプラグインのアップロード、PHP Webシェルの設置、管理画面へのアクセス、管理者名やメールアドレスの列挙、ローカルファイルインクルージョンの試行が含まれます。一方、同社は同日時点で、横展開やデータ流出は確認していないとも述べています。

7月21日には、米国CISAがCVE-2026-60137とCVE-2026-63030をKEVカタログへ追加しました。KEVへの登録は、実際の悪用を裏付ける証拠があることを示します。ただし、攻撃件数や国内での被害規模まで示すものではありません。それでも、修正版公開後の短期間にPoCと実攻撃が確認されていることから、対象バージョンのWordPressをインターネットへ公開している場合は、対象環境では定期メンテナンスを待たず、緊急性の高いパッチとして扱う必要があります。

国内では独立行政法人情報処理推進機構(IPA)が7月22日に注意喚起を公開*4しています。また、JPCERT/CCも7月23日に「複数のセキュリティ企業が悪用を確認している」として、修正版への更新を呼びかけています*5。

侵害確認のポイント

ステップ1:稼働バージョンと公開期間を確認する

  • 現在のWordPress Coreのバージョンを確認する
  • 修正版へ更新済みの場合も、それ以前に脆弱な状態で公開していた期間がないか確認する(少なくとも2026年7月17日以降、可能であれば保存されている範囲全体のログを対象にする)
  • DNS、クラウド、レンタルサーバー、外部委託先を含め、管理対象外のWordPressや検証用サイトを含め、組織が現在公開されているWeb資産を棚卸しする

ステップ2:REST APIのバッチエンドポイントへの通信を調べる

  • WebサーバーやWAFのログで /wp-json/batch/v1 および ?rest_route=/batch/v1 への不審なリクエストを確認する
  • HTTP 207の応答、wp2shell/rezwp2shell を含むUser-Agentを補助的な手掛かりとして確認する(※単独で攻撃成功を示すものではない)
  • 送信元、リクエスト内容、後続する管理画面へのアクセス、ファイル作成などを時系列で突き合わせる

バッチAPIは正規の処理でも使われるため、HTTPステータスだけで侵害を断定することはできません。PoC固有のUser-Agentも容易に変更できる点に注意してください。

ステップ3:管理者アカウント、プラグイン、PHPファイルを確認する

  • WordPressのユーザー一覧で、作成者や作成時刻に心当たりのない管理者アカウントがないか確認する
  • インストールした記録のないプラグインがないか確認する
  • wp-content/pluginsやキャッシュ領域に追加・変更されたPHPファイルがないか確認する
  • Webサーバープロセスからシェルや不審な子プロセスが起動された記録がないか確認する

既知のファイル名やハッシュとの一致だけに頼るべきではありません。公開PoCは改変でき、攻撃者も名称や配置先を変えられます。通信、アカウント、ファイル、プロセスという複数の痕跡から判断してください。侵害の疑いがある場合は、証拠を保全したうえで対象を隔離し、組織のインシデント対応手順に従って調査を進めます。

今すぐ行うべき対策

WordPress Coreを修正版へ更新

根本対策は、6.8系なら6.8.6、6.9系なら6.9.5、7.0系なら7.0.2への更新です。別のブランチへ移行する場合は、そのブランチで今回の脆弱性が修正済みのバージョンを選びます。WordPressの管理画面だけでなく、構成管理ツールやホスティング事業者の管理画面も確認し、更新後に実際のバージョンが切り替わったことを検証します。

本番サイトの更新では、バックアップと復旧手順を確認し、プラグインやテーマとの互換性も検証します。ただし、今回のように実悪用が確認された脆弱性では、通常の更新サイクルをそのまま適用せず、リスクに応じて緊急変更として扱う判断が必要です。

すぐに更新できない場合はWAFで一時的に遮断

直ちにアップデートできない場合、Searchlight Cyberは暫定策として、未認証のバッチAPIへのアクセスを制限する方法を示しています。WAFやリバースプロキシで/wp-json/batch/v1とrest_route=/batch/v1の両方を対象にし、外部からの未認証アクセスを遮断します。

遮断条件は、URLをデコード・正規化した後の値で判定し、受信時のHTTPメソッドだけで絞り込まないようにします。サブディレクトリに設置したWordPressや、WAFを通らずオリジンサーバーへ直接接続できる経路も確認が必要です。

この対策は、正規のREST API利用に影響する可能性があります。また、WAFは脆弱なコードを修正するものではなく、設定や通信経路によっては防御を迂回されるおそれもあります。あくまで更新までの一時的なリスク低減策と位置づけ、WordPress Coreのアップデートを先送りしないでください。

更新後も侵害の有無を調査

修正版への更新は、この2件の脆弱性を利用した新たな侵入を防ぐための根本対策です。ただし、更新前に作成された管理者アカウントやWebシェルは削除されません。脆弱な状態で公開していたサイトは、更新後もログ、アカウント、プラグイン、ファイル改変を確認します。

侵害が確認された場合は、単に不審なファイルを削除して公開を再開するのではなく、影響範囲を特定し、信頼できるバックアップからの復旧、認証情報や秘密情報の変更、再侵入経路の遮断までを一連のインシデント対応として行う必要があります。

よくある質問

▼ wp2shellはWordPressプラグインの脆弱性ですか?
▼ WordPress 6.8系はwp2shellの影響を受けますか?
▼ 自動更新を有効にしていれば対策済みですか?
▼ WAFだけでwp2shellを防げますか?
▼ wp2shellを利用した実攻撃は確認されていますか?
▼ 修正版へ更新すれば侵害調査は不要ですか?

まとめ

wp2shellは、WordPress Coreに存在する2件の脆弱性を組み合わせ、認証前から管理者権限の取得や任意コード実行(RCE)につながる攻撃チェーンです。対象となるWordPressバージョンでは、すでにPoCや実攻撃が確認され、CISAのKEVカタログにも登録されています。

影響を受けるバージョンを利用している場合は、修正版への更新を速やかに実施してください。また、修正前のバージョンをインターネットに公開していた場合は、更新だけでなく、管理者アカウントやプラグイン、PHPファイル、アクセスログなどを確認し、侵害の有無も調査することが重要です。

今回の事例は、脆弱性情報の公開後、短期間でPoCや実攻撃が確認された事例でもあります。今後の緊急対応を迅速化するため、平時から公開資産を継続的に把握できる運用体制を整えることが重要です。

【関連記事】

【参考情報】


【コラム】AIを活用した脆弱性研究

今回のwp2shellは、AIを活用した脆弱性研究の事例としても注目されました。Searchlight CyberのAdam Kues氏は、GPT-5.6 Sol Ultraをコード監査に活用し、約10時間で攻撃チェーンを構築できたと報告しています。一方で、調査対象の選定や検証、WordPressへの責任ある報告は研究者自身が行っており、「AIが単独で脆弱性を発見した」わけではありません。本件は、AIの活用によって脆弱性研究が効率化される一方、修正版公開後からPoCや実攻撃が出現するまでの期間が短くなる可能性を示した事例としても注目されています。

参考:

編集責任:木下


BBSec(ブロードバンドセキュリティ)では、Webアプリケーション診断、プラットフォーム診断、クラウド環境診断、脆弱性管理支援など、企業のセキュリティリスクを可視化する各種サービスを提供しています。外部サービスや委託先を含めたセキュリティ体制の見直し、情報漏えいリスクへの備え、インシデント発生前の予防対策を検討している企業は、ぜひご相談ください。


ウェビナー開催のお知らせ

最新情報はこちら

Security Serviceへのリンクバナー画像
BBsecコーポレートサイトへのリンクバナー画像
セキュリティ緊急対応のバナー画像

Security NEWS TOPに戻る
バックナンバー TOPに戻る

IT資産管理を効率化する方法とは?担当者が押さえたい運用のポイント

Share
IT資産管理を効率化する方法とは?アイキャッチ画像

IT資産管理を継続するには、台帳を作成するだけでは十分ではありません。定期的な棚卸しや資産台帳の整備、ツールの活用、運用ルールの見直しなど、継続して管理できる仕組みづくりが重要です。本記事では、IT資産管理を効率化するための基本ステップと、実務で押さえたい運用のポイントを解説します。

IT資産管理の基本について知りたい方は、まず「IT資産管理とは」をご覧ください。
「IT資産管理とは?企業のセキュリティ対策で最初に取り組むべき理由を解説」

IT資産管理は重要だと分かっていても、実際の運用では「台帳が更新されない」「管理対象が多すぎる」「クラウドやSaaSまで把握しきれない」といった悩みが起こりがちです。特に、少人数の情報システム部門や兼任体制の企業では、手作業だけでIT資産を正確に管理し続けるのは現実的ではありません。

IT資産管理で押さえるべき基本ステップ

IT資産管理を効率化するには、いきなりツールを導入するのではなく、基本ステップを整理することが大切です。最初に行うべきことは、管理対象の範囲を決めることです。PC、サーバー、ネットワーク機器、スマートフォン、タブレット、ソフトウェア、クラウドサービス、SaaS、アカウント、ライセンスのうち、どこまでをIT資産管理の対象にするのかを明確にします。次に、現在のIT資産を棚卸しします。棚卸しによって、台帳に載っていない端末、使われていないSaaS、放置されたクラウド環境、サポート期限が近いソフトウェアなどを洗い出します。その後、資産台帳を整備し、資産の種類、利用者、管理責任者、重要度、バージョン、サポート期限、最終確認日などを記録します。

棚卸しを定期的に行う

IT資産棚卸しは、IT資産管理の出発点です。棚卸しでは、以下のような複数の情報源を突き合わせます。ひとつの情報源だけに頼ると、見落としが発生しやすいため、複数の情報を照合することが重要です。

  • 購買台帳・リース契約
  • MDM/EDR
  • Active DirectoryやID管理基盤
  • クラウド管理画面
  • SaaSの契約情報 – ネットワーク接続情報

たとえば、購買台帳には存在するのにEDRには表示されない端末があれば、未セットアップ、未接続、廃棄漏れの可能性があります。逆に、EDRやネットワーク上には存在するのに購買台帳や資産台帳にない端末があれば、未登録端末や持ち込み端末の可能性があります。クラウド環境では、誰が作成したか分からないインスタンス、公開設定のまま放置されたストレージ、検証後に削除されていないリソースを確認します。棚卸しの頻度は、企業規模やIT環境によって異なりますが、少なくとも年1回の一斉棚卸しだけでは変化に追いつきにくくなっています。端末の入れ替え、SaaS契約、クラウド環境の作成など、変化が多い領域については、月次や四半期単位で確認する運用が望ましいでしょう。

どのような資産が見落とされやすいかについては「見落としがちなIT資産がセキュリティ事故を招く?企業で起こりやすい5つの管理課題」もあわせてご覧ください。

資産台帳を整備する

棚卸しで見つけたIT資産は、資産台帳に整理します。台帳は、単に資産名を並べるためのものではありません。脆弱性対応、パッチ適用、ライセンス管理、費用管理、インシデント対応に使える情報でなければ、実務では役に立ちません。資産台帳には、資産ID、資産種別、製品名、メーカー、OSやソフトウェアのバージョン、利用者、所属部門、管理責任者、設置場所、IPアドレス、利用目的、業務上の重要度、保存・処理する情報の種類、サポート期限、ライセンス情報、最終確認日などを記録します。すべてを最初から完璧に埋める必要はありませんが、脆弱性対応やインシデント対応に必要な項目は優先して整備するべきです。

NIST SP 1800-5では、有効なIT資産管理は物理資産と仮想資産を結びつけ、資産が何で、どこにあり、どのように使われているかを把握できるようにするものと説明されています。 この視点を踏まえると、台帳は固定的な一覧ではなく、現場の利用実態を反映する情報基盤として設計する必要があります。

ツールで自動化する

IT資産管理を効率化するうえで、ツールによる自動化は有効です。管理対象が少ないうちは手作業でも対応できますが、端末、クラウド、SaaS、アカウント、ソフトウェアが増えると、人手だけで最新状態を維持するのは難しくなります。IT資産管理ツールを使えば、端末情報、インストール済みソフトウェア、OSバージョン、利用者情報、接続状況などを自動収集しやすくなります。MDMはモバイル端末やPCの管理に役立ち、EDRは端末の稼働状況やセキュリティ状態の把握に活用できます。クラウド環境では、クラウド管理ツールやCSPMによって、リソース、設定、公開状態、権限の可視化を進められます。SaaSについては、ID管理基盤やSaaS管理ツールと連携し、利用アカウントや不要ライセンスを確認します。

IT資産管理ツールによって可視化した資産情報は、脆弱性管理にも活用できます。資産台帳とスキャン結果を結びつけることで、どの資産にどの脆弱性が存在するのかを把握しやすくなります。

運用ルールを整備する

IT資産管理は、ツールを導入するだけでは定着しません。新しい端末を購入したとき、SaaSを契約したとき、クラウド環境を作成したとき、従業員が異動・退職したとき、機器を廃棄したときに、誰が、いつ、どの情報を更新するのかを決めておく必要があります。

ライフサイクル管理

調達から廃棄までのライフサイクルにIT資産管理を組み込むことも重要です。購入申請時に資産登録を行い、利用開始時に管理責任者を設定し、定期的に利用状況を確認し、不要になったらアカウント停止やデータ消去、契約解除、廃棄証跡の保管まで行う。この流れが決まっていないと、台帳はすぐに古くなります。

シャドーIT対策

シャドーIT対策では、禁止だけでなく申請しやすい仕組みも必要です。現場が必要なツールを安全に使える申請ルート、承認済みSaaSの一覧、例外利用時の確認項目を整備することで、非公式な利用を減らしやすくなります。英国のサイバーセキュリティ機関NCSCも、「シャドーITは従業員が業務上の課題を解決しようとして発生することが多く、責めるのではなく、報告しやすいセキュリティ文化を作ることが重要」だと説明しています*6。

IT資産の可視化を脆弱性管理やパッチ管理につなげる

近年では、社内で管理しているIT資産だけでなく、インターネット上に公開されている資産を継続的に把握・管理するために、ASM(Attack Surface Management)を活用する企業も増えています。

IT資産の可視化はゴールではありません。可視化した資産情報を、脆弱性管理やパッチ管理につなげることが重要です。NIST SP 800-40 Rev.4では、パッチ管理を、パッチやアップデートを識別し、優先順位付けし、取得し、適用し、適用結果を検証するプロセスとして説明しています。 その前提として、どの資産が存在し、どのソフトウェアやバージョンを利用しているかを把握している必要があります。たとえば、重大な脆弱性が公開された場合、資産台帳が整備されていれば、対象バージョンを利用している端末やサーバーをすばやく抽出できます。重要システム、外部公開システム、個人情報を扱うシステムなどを優先して対応する判断も可能になります。逆に、資産情報がなければ、全社に一斉確認を依頼するしかなく、対応に時間がかかります。

IT資産管理、脆弱性管理、パッチ管理は別々の業務ではなく、つながった運用として設計することが重要です。IT資産を把握し、リスクを評価し、優先順位をつけ、対策し、結果を確認する。この流れができて初めて、セキュリティ対策は継続的に機能します。

まとめ:効率化の目的は、管理を楽にすることではなく対応を早くすること

IT資産管理を効率化する目的は、単に運用負荷を減らすことではありません。IT資産を継続的に把握し、脆弱性への対応やインシデント発生時の初動対応を迅速に行える状態を維持することが重要です。そのためには、定期的な棚卸しや資産台帳の整備、ツールによる自動化、運用ルールの見直しを組み合わせ、自社のIT環境に合わせた継続的な運用を構築しましょう。

【参考情報】

CIS(Center for Internet Security)「The 18 CIS Critical Security Controls」(https://www.cisecurity.org/controls/cis-controls-list)

【関連記事】

編集責任:木下


公開IT資産を可視化してみませんか?

社内で管理しているIT資産と、インターネット上から見える資産は必ずしも一致しません。攻撃者視点で公開資産を可視化する「アタックサーフェス調査サービス」をご紹介します。

BBSecのアタックサーフェス調査サービス

インターネット上で「攻撃者にとって対象組織はどう見えているか」調査・報告するサービスです。攻撃者と同じ観点に立ち、企業ドメイン情報をはじめとする、公開情報(OSINT)を利用して攻撃可能なポイントの有無を、弊社セキュリティエンジニアが調査いたします。


Security Serviceへのリンクバナー画像
BBsecコーポレートサイトへのリンクバナー画像
セキュリティ緊急対応のバナー画像

Security NEWS TOPに戻る
バックナンバー TOPに戻る

見落としがちなIT資産がセキュリティ事故を招く?企業で起こりやすい5つの管理課題

Share
「見落としがちなIT資産管理の課題5選」アイキャッチ画像

前回記事では、IT資産管理の基本と重要性を解説しました。管理されていない端末やクラウド環境、シャドーIT、サポート終了製品など、見落とされたIT資産が被害につながるケースも少なくありません。今回は、管理が行き届かない場合に実際どのような問題が起こりやすいのか、企業で起こりやすい5つの管理課題を具体的に見ていきます。

IT資産管理の基本について知りたい方は、まず「IT資産管理とは」をご覧ください。
「IT資産管理とは?企業のセキュリティ対策で最初に取り組むべき理由を解説」

セキュリティ事故は、必ずしも高度な攻撃だけで起こるわけではありません。実際には、管理されていない端末、放置されたクラウド環境、退職者のアカウント、サポート終了ソフトウェアなど、見落としがちなIT資産がきっかけになることがあります。IT資産管理が不十分な状態では、脆弱性情報が公開されても対象資産を特定できず、インシデント発生時にも影響範囲をすばやく把握できません。

なぜ管理漏れが起こるのか

IT資産の管理漏れは、担当者の怠慢だけで起こるものではありません。むしろ、事業スピードに管理体制が追いつかないことで発生します。新しいSaaSを部門単位で契約する、検証用にクラウド環境を作成する、テレワーク用に端末を追加する、業務委託先にアカウントを付与する。こうした日常的な業務の中で、台帳更新や承認プロセスが後回しになると、実態とのズレが広がっていきます。

企業で起こりやすい5つの管理課題

台帳が更新されない

IT資産管理で最も起こりやすい課題は、資産台帳が更新されないことです。導入時には正確だった台帳も、ソフトウェア更新やクラウド環境の追加が反映されなければ、すぐに実態とずれていきます。特にExcelやGoogleスプレッドシートで管理している場合、更新担当者が限られ、現場の変更が反映されないまま時間が経過しがちです。その結果、台帳上は存在するのに実際には廃棄済みの機器、逆に台帳にはないが稼働している資産が発生します。インシデント対応時にこの状態だと、影響範囲の特定に時間がかかり、初動対応の遅れにつながります。

シャドーITが増える

シャドーITとは、情報システム部門や管理部門が把握していないIT資産やサービスが、業務目的で利用されている状態を指します。英国のサイバーセキュリティ機関NCSCでは、「シャドーITは悪意によって生まれるとは限らず、従業員が業務を進めるために、承認済みのツールやプロセスでは対応できない課題を解決しようとして発生することが多い」と説明しています。たとえば、ファイル共有が不便だから個人用クラウドストレージを使う、社内承認に時間がかかるため部門でSaaSを契約する、開発検証のために個人名義に近い形でクラウド環境を作る、といった行動です。本人に悪意がなくても、会社のセキュリティポリシー、バックアップ、アクセス制御、監査ログ、退職時のアカウント削除の対象外になるため、情報漏洩や不正アクセスのリスクが高まります。シャドーIT対策で重要なのは、単に禁止することではありません。なぜ現場が非公式な手段を使わざるを得なかったのかを把握し、業務に必要なツールを安全に使える仕組みに変えることです。

クラウド資産が把握できない

クラウド環境では、サーバやストレージ、データベース、コンテナ、API、アカウント、権限設定などが短時間で作成・変更・削除されます。オンプレミス環境のように物理的なサーバーが目に見えるわけではないため、管理対象から漏れやすいのが特徴です。検証用に作ったクラウド環境が放置され、インターネットに公開されたままになる。開発者が一時的に広い権限を付与し、その後も戻されない。ログ設定やバックアップ設定が本番環境と異なる。こうした状態は、クラウド利用が進む企業ほど起こりやすくなります。米国サイバーセキュリティ・インフラストラクチャセキュリティ庁(CISA)の「Cybersecurity Performance Goals」でも、既知の資産だけでなく、未知の資産、シャドー資産、未管理資産を特定し、新たな脆弱性への検知・対応を速めることが目的として示されています。

EOL(End of Life)・EOS(End of Service)を見逃す

サポートが終了したOS、ネットワーク機器、VPN機器、業務アプリケーション、ミドルウェアを使い続けることも、IT資産管理上の大きな課題です。サポートが終了した製品は、脆弱性が発見されても修正プログラムが提供されない可能性があります。資産台帳にサポート期限や保守期限が記録されていなければ、更新計画を立てることもできません。

EOL・EOSについては前回記事でも触れていますので、あわせてご覧ください。

また、ソフトウェア資産の構成管理まで行いたい場合、EOL・EOS対策の延長としてSBOM(ソフトウェア部品表)も重要になります。経済産業省「ソフトウェア管理に向けたSBOMの導入に関する手引 Ver.2.0」では、資産管理台帳だけでは、下位コンポーネントとして利用されるOSSなどに脆弱性が見つかった場合に、間接的な影響を検知できない場合があると説明されています。

SBOMについては、「SBOMとは?ソフトウェア部品表の基本と企業が導入すべき理由」でも解説しています。あわせてご覧ください。

部門ごとに管理している

IT資産管理が部門ごとに分断されていることも、企業でよく見られる課題です。情報システム部門はPCとネットワーク機器を管理し、開発部門はクラウド環境を管理し、総務部門はリース契約を管理し、各事業部がSaaS契約を管理している。このような状態では、全社としてどのIT資産が存在するのかを把握できません。部門ごとの管理は、現場のスピードを保つうえでは便利です。しかし、セキュリティ事故が起きたときには、誰が責任者なのか、どの情報が保存されているのか、どの範囲に影響があるのかが分からなくなります。特に、SaaSやクラウドサービスでは、管理者権限を持つ担当者が異動・退職した後に、契約やアカウントだけが残り続けるケースもあります。

管理課題を解決するポイント

IT資産管理の課題を解決するには、台帳を作るだけでは不十分です。重要なのは、資産が増える、変わる、使われなくなるタイミングで、台帳や管理システムが自然に更新される運用を作ることです。まず、IT資産管理の対象範囲を明確にします。PCやサーバだけでなく、クラウド環境、SaaS、アカウント、ネットワーク機器、ソフトウェア、ライセンスまで含めるかを決めます。次に、資産ごとに管理責任者を定めます。所有者が曖昧な資産は、脆弱性対応や費用管理、廃棄判断が遅れやすくなります。そのうえで、購買、入社、異動、退職、クラウド作成、SaaS契約、機器廃棄といった業務フローにIT資産管理を組み込みます。ツールを導入する場合も、単体で完結させるのではなく、ID管理、EDR、MDM、脆弱性管理、クラウド管理と連携させることで、実態に近い情報を保ちやすくなります。

課題を解決する具体的な運用方法については「IT資産管理を効率化する方法とは?担当者が押さえたい運用のポイント」をご覧ください。

まとめ:見えていないIT資産は、守れない

IT資産管理の課題は、すぐに大きな障害として表面化するとは限りません。しかし、管理漏れ、シャドーIT、クラウド資産の放置、サポートが終了した製品・機器の見逃し、部門ごとの分断が積み重なると、セキュリティ事故の温床になります。

次回は、こうした課題を解決するための具体的な運用方法について解説します。

【参考情報】

編集責任:木下


公開IT資産を可視化してみませんか?

社内で管理しているIT資産と、インターネット上から見える資産は必ずしも一致しません。攻撃者視点で公開資産を可視化する「アタックサーフェス調査サービス」をご紹介します。

BBSecのアタックサーフェス調査サービス

インターネット上で「攻撃者にとって対象組織はどう見えているか」調査・報告するサービスです。攻撃者と同じ観点に立ち、企業ドメイン情報をはじめとする、公開情報(OSINT)を利用して攻撃可能なポイントの有無を、弊社セキュリティエンジニアが調査いたします。


Security Serviceへのリンクバナー画像
BBsecコーポレートサイトへのリンクバナー画像
セキュリティ緊急対応のバナー画像

Security NEWS TOPに戻る
バックナンバー TOPに戻る

インシデント対応体制とは?CSIRTの役割と企業が整えるべき運用のポイント

Share
「インシデント対応体制とはCSIRTの役割と企業が整えるべき運用のポイント」アイキャッチ画像

サイバー攻撃や情報漏えいなどのセキュリティインシデントでは、迅速かつ適切な対応が被害の拡大防止につながります。そのためには、担当者任せではなく、役割分担や連絡体制をあらかじめ整備しておくことが重要です。本記事では、インシデント対応体制の基本的な考え方をはじめ、CSIRTやSOCの役割、企業が体制を構築・運用する際のポイントを解説します。

インシデント管理の全体像については、以下の記事をご覧ください。
「セキュリティインシデント管理とは?企業が押さえるべき対応フローと体制の全体像」

サイバー攻撃や情報漏洩、ランサムウェア感染、不正アクセスなどのセキュリティインシデントは、発生してから担当者が個別に対応するだけでは十分に対処できません。インシデント対応では、技術的な調査や復旧だけでなく、経営判断、法務確認、顧客対応、広報対応、取引先との調整など、複数の部門が関係します。

そのため、企業にはあらかじめインシデント対応体制を整備しておくことが求められます。誰が異常を受け付け、誰が初動対応を判断し、誰が調査を進め、誰が経営層や外部関係者へ報告するのかが決まっていなければ、発生直後の混乱を避けることはできません。JPCERT/CCは「CSIRTマテリアル」について、組織的なインシデント対応体制である「組織内CSIRT」の構築を支援する目的で作成したものと説明しています。また、すべての組織が同じ形のCSIRTを持つべきというものではなく、それぞれの組織の状況に応じた適切な形があるとしています。つまり、インシデント対応体制は、大企業だけが整備する特別な仕組みではなく、企業規模や事業内容に応じて現実的に設計すべきものです。

なぜ体制が必要なのか

インシデント対応体制が必要な理由は、セキュリティインシデントが一部門だけで完結する問題ではないためです。たとえば、マルウェア感染が発生した場合、情報システム部門は端末隔離やログ調査を行います。しかし、個人情報漏洩の可能性があれば法務や個人情報保護の担当部門が関与し、顧客影響があれば営業やカスタマーサポートが対応し、外部公表が必要になれば広報や経営層の判断が必要になります。

不正アクセスやランサムウェア感染では、技術的な調査と同時に、事業継続の判断も必要になります。システムを停止するのか、どの業務を優先して復旧するのか、取引先へいつ説明するのかといった判断は、現場担当者だけで決められるものではありません。事前に体制がなければ、関係者への連絡が遅れ、対応の優先順位も曖昧になります。

NIST SP 800-61 r2「Computer Security Incident Handling Guide」でも、効果的なインシデント対応は複雑な取り組みであり、成功する対応能力を確立するには、計画とリソースが必要であるとされています。また、インシデント対応では、IT部門だけでなく、法務などの内部関係者や、外部のインシデント対応チーム、法執行機関などとの連携も想定されています。

体制がない企業では、インシデントが発生したときに「誰に報告すればよいか分からない」「誰が判断責任を持つのか分からない」「外部ベンダーに何を依頼すればよいか分からない」という状態になりがちです。平時であれば多少の確認不足は補えますが、インシデント発生時には時間が限られています。対応の遅れは、被害拡大や情報漏洩、事業停止、信用低下につながる可能性があります。

独立行政法人情報処理推進機構(IPA)が公開するプラクティス・ナビ「指示7 インシデント発生時の緊急対応体制の整備」の中で、CSIRT等の対応体制が整備されていないこと、証拠保全ルールや外部報告・公表ルールが定められていないこと、想定インシデントに応じた分析・対応手順がないこと、CSIRT業務が属人化していること、演習を行っていないことを課題として挙げています。

インシデント対応体制とは、単に担当者の名前を決めることではありません。発生時に必要な判断、作業、報告、連携を整理し、組織として動ける状態にすることです。対応体制が整っていれば、発生直後の混乱を抑え、被害拡大防止、原因調査、復旧、再発防止までを一貫して進めやすくなります。

インシデント対応体制の基本構成

インシデント対応体制は、企業規模や業種、システム構成によって異なります。ただし、多くの企業に共通する基本構成として、CSIRT、SOC、各部門の連携があります。これらはそれぞれ役割が異なり、単独で機能するものではありません。CSIRTは、インシデント対応を組織として進めるための中核的な役割を担います。インシデントの受付、事実確認、対応方針の調整、関係部門への連絡、外部機関や専門ベンダーとの連携、再発防止策の整理などを担うことが一般的です。企業によっては、専任組織として設置される場合もあれば、情報システム部門やセキュリティ担当者を中心に兼任体制で運用される場合もあります。SOCは、Security Operation Centerの略で、主に監視や検知、分析を担う機能です。EDR、SIEM、ファイアウォール、クラウド監査ログ、認証ログなどを監視し、不審な通信や挙動を検知します。SOCは、インシデントの兆候を早期に発見し、CSIRTや情報システム部門へエスカレーションする役割を持ちます。自社内にSOCを持つ企業もありますが、専門ベンダーのSOCやMDRサービスを活用する企業もあります。

各部門の役割も重要です。情報システム部門は、端末、サーバ、ネットワーク、クラウド環境の技術的対応を担います。法務部門は、個人情報保護法や契約上の責任、監督官庁への報告要否などを確認します。広報部門は、外部公表やメディア対応、顧客向け説明文の調整を担います。営業部門やカスタマーサポート部門は、顧客や取引先からの問い合わせ対応を担います。経営層は、事業停止や外部公表、重大なリスク判断について意思決定を行います。

これらの体制は、実際のインシデント対応フローの中で機能します。具体的な対応手順については、以下の記事で詳しく解説しています。
「インシデント対応フローとは?発生時に企業が取るべき手順と判断ポイント」

重要なのは、CSIRT、SOC、各部門の役割を分けるだけでなく、連携の流れを決めておくことです。SOCが検知したアラートを誰に報告するのか、CSIRTがどの基準で重大度を判断するのか、法務や広報をどのタイミングで巻き込むのか、経営層への報告基準は何かを定めておかなければ、体制図があっても実際には動きません。インシデント対応体制は、組織図上の箱を作ることではなく、実際に発生したときに機能する連絡・判断・対応の仕組みを作ることです。

CSIRTとは何か

CSIRTとは、Computer Security Incident Response Teamの略で、コンピューターセキュリティインシデントに対応するチームを意味します。JPCERT/CCによれば、CSIRTは「Computer Security Incident Response Team=コンピューターセキュリティインシデントに対応するチーム」の略であると説明されています。CSIRTの役割は、単に技術的な調査を行うことだけではありません。組織内で発生したインシデントの情報を集約し、対応方針を整理し、関係部門をつなぎ、必要に応じて外部機関や専門ベンダーと連携することが重要な役割です。企業によっては、脆弱性情報の収集、注意喚起、セキュリティ教育、訓練、再発防止策の推進など、平時の活動もCSIRTが担う場合があります。

JPCERT/CCの公開する資料「組織内 CSIRT の役割とその範囲」では、組織内CSIRTの役割には違いがあり、インシデントへの直接対応、支援的対応、調整役としての対応などが示されています。つまり、CSIRTは必ずしもすべての技術対応を自ら行う必要はありません。企業の体制に応じて、現場対応を支援する立場、部門間を調整する立場、外部専門家との窓口になる立場など、現実的な役割を設計することが重要です。

CSIRTが必要とされる理由は、インシデント発生時に情報と判断を一元化するためです。インシデント対応では、端末の隔離、ログ調査、外部連絡、顧客説明、法務判断、復旧作業など、さまざまな対応が同時に発生します。これらが各部門でばらばらに進むと、情報の食い違いや判断の遅れが起こりやすくなります。CSIRTが中心となって情報を集約すれば、経営層への報告も整理しやすくなります。経営層が必要とするのは、単なる技術情報ではなく、事業への影響、顧客への影響、復旧見通し、法的・契約上のリスク、外部公表の必要性などです。CSIRTは、技術部門と経営判断をつなぐ役割を担うことで、インシデント対応を企業全体のリスク対応として進めやすくします。ただし、CSIRTは設置するだけでは機能しません。連絡先が古い、権限が曖昧、判断基準がない、訓練をしていない、担当者が兼任で実質的に動けないといった状態では、有事に十分な役割を果たせません。CSIRTの必要性を理解したうえで、自社の規模やリソースに合った運用を設計することが大切です。

体制が機能しない原因

インシデント対応体制が機能しない原因として、最も多いのが属人化です。特定の担当者だけがシステム構成を理解している、ログの確認方法を知っている、外部ベンダーとの連絡先を把握している、過去のインシデント対応の経緯を覚えているという状態では、その担当者が不在のときに対応が止まります。属人化は、日常業務では見えにくい問題です。詳しい担当者がいれば、普段のトラブルはその人が解決できてしまいます。しかし、インシデント発生時には、短時間で多くの判断と作業が必要になります。特定の個人に情報や判断が集中すると、対応速度が落ち、確認漏れや連絡漏れが起こりやすくなります。

IPAのプラクティス・ナビ「プラクティス7-4 CSIRT業務の属人化回避も兼ねたインシデントや脅威に関する情報の共有・蓄積」では、CSIRT業務の属人化回避を目的とした情報共有・蓄積の重要性を示しています。公開されている事例でも、CSIRT設立の中核だった従業員が退職した際に対応能力が低下し、その後、業務を属人化させない仕組みの整備が必要になったことが紹介されています。

もう一つの原因は、判断基準がないことです。どのアラートをインシデントとして扱うのか、どの段階でCSIRTを招集するのか、端末隔離やシステム停止を誰が判断するのか、外部報告や公表を検討する基準は何かが決まっていなければ、現場は迷います。判断基準がないと、対応は担当者の経験や感覚に依存します。経験豊富な担当者であれば適切に判断できる場合もありますが、担当者が変われば対応品質も変わります。また、重大なインシデントほど、技術的な判断だけでなく、事業影響や法務リスク、顧客影響を含めた判断が必要になります。判断基準が曖昧なままでは、経営層への報告も遅れやすくなります。

体制が機能しない企業では、形式的な体制図だけが存在していることもあります。CSIRTという名前はあるものの、実際のメンバー、役割、権限、連絡手順、訓練計画が決まっていない状態です。このような体制では、インシデント発生時に「誰が何をするのか」を改めて確認することになり、初動対応が遅れます。 さらに、部門間の連携不足も大きな要因です。情報システム部門が技術対応を進めていても、法務や広報、営業、経営層への共有が遅れると、顧客説明や外部公表の準備が間に合いません。反対に、経営層や広報が十分な事実確認を待たずに情報発信を進めると、誤った説明につながる可能性があります。インシデント対応体制を機能させるには、体制図を作るだけでなく、情報共有の流れ、判断権限、報告基準、記録方法を具体化する必要があります。

体制構築のポイント

インシデント対応体制を構築するうえで重要なのは、まず対応フローを明確にすることです。検知、初動対応、調査、復旧、再発防止という流れの中で、誰がどの工程を担当するのかを整理します。たとえば、従業員からの不審メール報告を誰が受け付けるのか、SOCや監視サービスのアラートを誰が確認するのか、感染端末の隔離を誰が実施するのか、経営層への報告を誰が行うのかを定めます。このとき、細かすぎる手順書を作ることよりも、実際に使える判断ルールを整備することが大切です。インシデントは事案ごとに状況が異なるため、すべてを手順書通りに進められるとは限りません。だからこそ、重大度の判断基準、エスカレーション条件、外部連携の基準、証拠保全の原則、復旧判断の考え方を整理しておく必要があります。

IPA「サイバーセキュリティ経営ガイドライン Ver3.0 実践のためのプラクティス集 第4版」では、インシデント発生時の緊急対応体制の整備として、司令塔としてのCSIRTの設置、従業員の初動対応の規定、想定されるインシデントに関するセキュリティ分析計画の事前策定、情報共有・蓄積、インシデント対応演習などが示されています。

次に重要なのが、訓練です。手順書や体制図を作っても、実際に動かしていなければ、有事に機能するとは限りません。インシデント対応訓練では、ランサムウェア感染、不正アクセス、情報漏洩、Webサイト改ざん、委託先からの侵害連絡など、想定シナリオをもとに、連絡、判断、報告、初動対応の流れを確認します。訓練では、技術対応だけでなく、経営層への報告、法務確認、広報文案の検討、顧客問い合わせへの対応、外部ベンダーへの連絡も含めて確認することが望ましいです。実際に演習してみると、連絡先が古い、判断者が不在時の代替ルートがない、ログの取得範囲が不足している、委託先との責任分界点が曖昧といった課題が見つかります。

体制構築では、外部リソースの活用も現実的な選択肢になります。すべての企業が専任CSIRTや自社SOCを持てるわけではありません。特に中堅・中小企業では、情報システム部門が日常業務とセキュリティ対応を兼任しているケースも多くあります。その場合は、外部SOC、MDR、インシデント対応支援ベンダー、フォレンジック調査会社、顧問弁護士、保険会社など、必要な支援先を平時から整理しておくことが重要です。ただし、外部委託すればすべて任せられるわけではありません。外部ベンダーが調査や監視を支援しても、最終的な事業判断、顧客対応、外部公表、再発防止策の実行は企業自身が行う必要があります。外部リソースは、自社の対応体制を補完するものとして位置づけることが大切です。

インシデント対応体制の整備は、情報漏洩対策全体の一部でもあります。あわせて以下の記事もご確認ください。
「情報漏洩対策とは何か ―企業が知るべき原因・リスク・防止策の全体像―」

まとめ

インシデント対応体制とは、セキュリティインシデントが発生したときに、企業が組織として対応するための仕組みです。CSIRT、SOC、情報システム部門、法務、広報、営業、経営層などが連携し、検知、初動対応、調査、復旧、再発防止を進められる状態を整えることが重要です。CSIRTは、インシデント対応の司令塔や調整役として、情報を集約し、対応方針を整理し、関係部門や外部機関との連携を担います。SOCは、監視や検知、分析を通じて、インシデントの兆候を早期に発見する役割を持ちます。各部門は、それぞれの専門性に基づいて、技術対応、法務判断、顧客説明、広報対応、経営判断を担います。

一方で、体制は作るだけでは機能しません。属人化した対応、曖昧な判断基準、古い連絡先、訓練不足、部門間連携の弱さがあると、インシデント発生時に初動が遅れます。特に、誰が判断し、誰が報告し、誰が外部と連携するのかが曖昧な状態では、対応の品質は担当者個人に依存してしまいます。 企業がまず取り組むべきことは、自社のインシデント対応フローを整理し、役割分担と連絡ルートを明確にすることです。そのうえで、重大度の判断基準、証拠保全ルール、外部報告・公表の検討基準、委託先や外部ベンダーとの連携方法を定め、定期的な訓練によって実効性を確認する必要があります。インシデント対応体制は、セキュリティ部門だけのための仕組みではありません。情報漏洩対策、事業継続、顧客信頼、経営リスク管理を支える重要な基盤です。自社の規模に合った現実的な体制から整備し、継続的に見直していくことが、インシデント発生時の被害最小化につながります。

【参考情報】

編集責任:木下


サイバーインシデント緊急対応

サイバーセキュリティ緊急対応電話受付ボタン
SQAT緊急対応バナー

ウェビナー開催のお知らせ

最新情報はこちら


資料ダウンロードボタン
年二回発行されるセキュリティトレンドの詳細レポート。BBSecで行われた診断の統計データも掲載。
お問い合わせボタン
サービスに関する疑問や質問はこちらからお気軽にお問合せください。

Security Serviceへのリンクバナー画像
BBsecコーポレートサイトへのリンクバナー画像
セキュリティ緊急対応のバナー画像

Security NEWS TOPに戻る
バックナンバー TOPに戻る

ウェビナーダイジェスト動画

Share

アーカイブ動画

過去ご好評いただいたウェビナーの抜粋動画を無料で公開しています。


ピックアップ

ウェビナーダイジェスト版:2026年、企業が直面するサイバー脅威― IPA 『情報セキュリティ10大脅威 2026』から考える対応戦略

2026年

ウェビナータイトル画面「2026年、企業が直面するサイバー脅威― IPA 『情報セキュリティ10大脅威 2026』から考える対応戦略」2026.3.18(水)開催
2026年、企業が直面するサイバー脅威― IPA 『情報セキュリティ10大脅威 2026』から考える対応戦略 ―
再生時間:05:01

2025年

ウェビナータイトル画面「フィッシング攻撃の最新脅威と被害事例〜企業を守る多層防御策〜」2025.9.10(水)開催
フィッシング攻撃の最新脅威と被害事例〜企業を守る多層防御策〜
再生時間:05:01
ウェビナータイトル画面「進化するランサムウェア攻撃」2025.7.16(水)開催
進化するランサムウェア攻撃-国内最新事例から学ぶ!被害を防ぐ実践ポイント10項目を解説-
再生時間:05:00
ウェビナータイトル画面「ランサムウェア対策の要! ペネトレーションテストとは?」2025.1.22(水)開催
ランサムウェア対策の要! ペネトレーションテストとは?-ペネトレーションテストの効果、脆弱性診断との違い-
再生時間:04:55

2024年

ウェビナーダイジェスト版:脆弱性診断の新提案!スピード診断と短納期で解決する「SQAT with Swift Delivery」セミナー2024.12.18(水)開催
脆弱性診断の新提案!スピード診断と短納期で解決する「SQAT® with Swift Delivery」セミナー
再生時間:05:09
ウェビナーダイジェスト版:中小企業に迫るランサムウェア!  サプライチェーン攻撃とは- サプライチェーン攻撃から企業を守るための取り組み2024.11.20(水)開催
中小企業に迫るランサムウェア! サプライチェーン攻撃とは- サプライチェーン攻撃から企業を守るための取り組み
再生時間:05:11
2024.11.13(水)開催
ウェブ担当者必見!プライバシー保護規制対応と情報セキュリティ
-サイバー攻撃への事前・事後対応-

再生時間:05:07
2024.8.7(水)開催
AWS・Azure・GCPユーザー必見!企業が直面するクラウドセキュリティリスク
再生時間:05:18
2024.7.10(水)開催
ランサムウェアの脅威を知る~脅威に備えるためのランサムウェア対策
再生時間:05:02
2024.6.19(水)開催
サイバー攻撃に備えるために定期的な脆弱性診断の実施を!-ツール診断と手動診断の比較-
再生時間:05:04
2024.5.22(水)開催
対応必須! 情報セキュリティ事故発生時の緊急対応とは
再生時間:05:09
2024.4.24(水)開催
知っておきたいIPA『情報セキュリティ10大脅威 2024』~セキュリティ診断による予防的コントロール~
再生時間:05:19
2024.4.17(水)開催
変化する不確実性の時代における「安心・安全・安定のWebサイト運営」セミナー
再生時間:03:00

2023年

2023.11.15(水)開催
Webアプリケーションの脆弱性対策-攻撃者はどのように攻撃するのか-
再生時間:05:42
2023.10.18(水)開催
自動車産業・製造業におけるセキュリティ対策のポイント-サプライチェーン攻撃の手口と対策方法-
再生時間:04:56
2023.8.9(水)開催
DevSecOpsを実現!-ソースコード診断によるセキュリティ対策のすすめ-
再生時間:05:29
2023.7.20(水)開催
今さら聞けない!PCI DSSで求められる脆弱性診断あれこれ
再生時間:05:00
2023.6.21(水)開催
今さら聞けない!クラウドセキュリティあれこれ
再生時間:05:00
2023.5.17(水)開催
今さら聞けない!ペネトレーションテストあれこれ
再生時間:05:20
2023.4.19(水)開催
知っておきたいIPA『情報セキュリティ10大脅威 2023』~セキュリティ診断による予防的コントロール~
再生時間:05:00
2023.3.15(水)開催
予防で差がつく!脆弱性診断の話
再生時間:04:57
2023.1.27(水)開催
今さら聞けない!ソースコード診断あれこれ
再生時間:05:00

2022年

2022.6.22(水)開催
テレワーク運用時代のセキュリティ情報の集め方-セキュリティに求められる情報収集とは-
再生時間:04:51
ウェビナーダイジェスト版:企業の対策すべき脆弱性入門2022.4.21(水)開催
企業の対策すべき脆弱性入門
再生時間:05:13

TOP-更新情報に戻る


年二回発行されるセキュリティトレンドの詳細レポート。BBSecで行われた診断の統計データも掲載。
サービスに関する疑問や質問はこちらからお気軽にお問合せください。

Security Serviceへのリンクバナー画像
BBsecコーポレートサイトへのリンクバナー画像
セキュリティ緊急対応のバナー画像