eMudhraの中間CA秘密鍵が復元可能に ―証明書の信頼問題と企業のTLS対策

Share
eMudhraの中間CA秘密鍵が復元可能に ―証明書の信頼問題と企業のTLS対策アイキャッチ画像

HTTPS通信では、サーバー証明書の検証によって接続先の正当性を確認します。しかし、その信頼の根拠となる認証局の秘密鍵が第三者に悪用されると、なりすましの危険が生じます。2026年10月、認証局eMudhraの中間CA証明書8件に対応する秘密鍵が、第三者でも容易に復元できる状態だったことが明らかになりました。MozillaやGoogleは対象証明書の信頼を遮断する対策を進め、関連ソフトウェアの更新も行われています。企業が確認すべきなのは、自社サイトで使用するSSL/TLS証明書だけではありません。外部サービスへ接続する業務アプリの証明書検証機能も対象です。本記事では、問題の概要と影響範囲、API通信を含むシステムの確認事項を整理します。

※本記事は2026年10月22日時点で公表されている情報を基に作成しています。認証局の調査結果や各ソフトウェアの対応状況は、今後変更される可能性があります。

中間証明書とは サーバー証明書を信頼につなぐ役割

中間証明書は、ルート認証局から個々のサーバー証明書へ信頼をつなぐ証明書です。一般的な証明書チェーンでは、ブラウザやOSなどが信頼するルート証明書を起点に、中間CA証明書、その下のサーバー証明書へと署名の関係が続きます。接続する側はこの関係などを検証し、相手の証明書を受け入れてよいか判断します。

Webサイトの運営者が持つ秘密鍵と、中間CAが証明書に署名するための秘密鍵は役割が異なります。後者を第三者が使用できる状態になると、攻撃者は対象の中間CAが正規に発行したかのように見える証明書を偽造できるおそれがあります。今回、問題となったのはこの署名用の秘密鍵です。通信経路に介入できる攻撃者が偽の証明書を提示し、接続側が受け入れると、通信内容を読み取られたり書き換えられたりするおそれがあります。

図1:中間CAの秘密鍵とサーバー証明書の信頼の関係
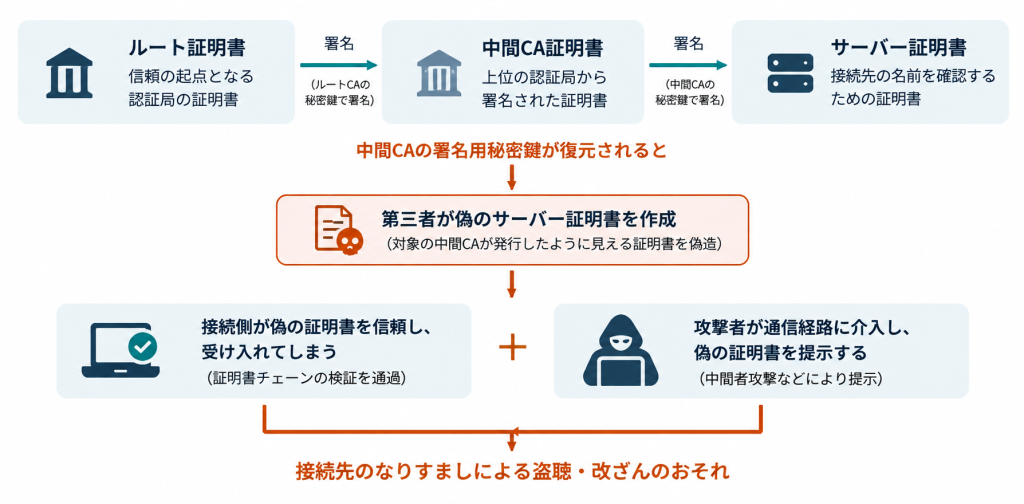
中間CAの秘密鍵とサーバー証明書の信頼の関係
出典:株式会社インターネットイニシアティブ「サーバ証明書の仕組みに関すること」、Mozilla Corporation(Firefox Security Team)「Protecting Firefox users following the compromise of eMudhra intermediate certificates」、Mozilla Foundation(Bugzilla)「eMudhra: Private key compromise of Intermediate Certificates(Bug 2083449)」を基に弊社作成。
※TLSの証明書チェーンと攻撃成立の条件を簡略化した概念図です。実際には複数の中間CAやクロス署名が存在する場合があります。秘密鍵の復元だけで通信の盗聴・改ざんが成立することを示すものではありません。

eMudhraの中間CAで秘密鍵の生成に問題が発覚

Mozillaの調査記録によると、対象8件のうち6件はTLS用、2件はコード署名用です。Mozillaは2026年10月17日20時06分(UTC)に報告を受け、通常設定のFirefox向けには同日22時59分までにOneCRLによる遮断を配信しました。日本時間では10月18日5時06分の受領から、同日7時59分までの対応です。対象の鍵は楕円曲線暗号P-384を使っていましたが、秘密鍵の値はすべて256未満の整数でした。独立して検証した研究者Scott Helme氏も、公開証明書から対象の鍵をノートPCで1秒未満に復元できたと報告しています。十分なランダム性を持つ値が必要なところ、極端に小さな値が使われていたことが問題であり、適切に生成されたP-384の鍵まで容易に復元できるという話ではありません。

eMudhraは、2025年4月30日の鍵生成作業で、鍵を移送するためのwrap/unwrap工程に問題があり、正常な鍵とは別に弱い鍵が生成されたと説明しています。同社はHSM(ハードウェアセキュリティモジュール)を使用していたとしていますが、10月21日の更新時点で正確な根本原因は確定していません。現段階では、同社が説明する作業工程の問題と、今後の調査で確定する原因を分けて捉える必要があります。

ブラウザだけでなく業務アプリの証明書検証も確認

Chromeは10月17日に対象TLS中間CAの公開鍵をCRLSetで遮断しました。Googleによると、その遮断前に対象の中間CA配下のTLS証明書はCertificate Transparency(CT)のログに登録されていませんでした。このため、CTを必須とする標準設定のChromeなどでは、対象CAを使った偽造証明書が信頼される状態ではなかったと説明しています。

CTは、証明書の発行を公開ログで検証できるようにする仕組みです。認証局が証明書を失効させたという情報や、ブラウザ独自のブロックリストとは役割が異なります。失効情報やブロックリストを受け取らないアプリに、ブラウザと同じ対策が自動的に行き渡るとは限りません。業務アプリで証明書を検証するのは、HTTPライブラリやOS、独自の信頼ストアなどです。SDKだけの更新で対策が済むとは限りません。自社サイトの証明書の発行元が別でも、外部APIへ接続するアプリが対象CAを信頼する場合は確認が必要です。

図2:証明書を提示する側と検証する側の確認範囲
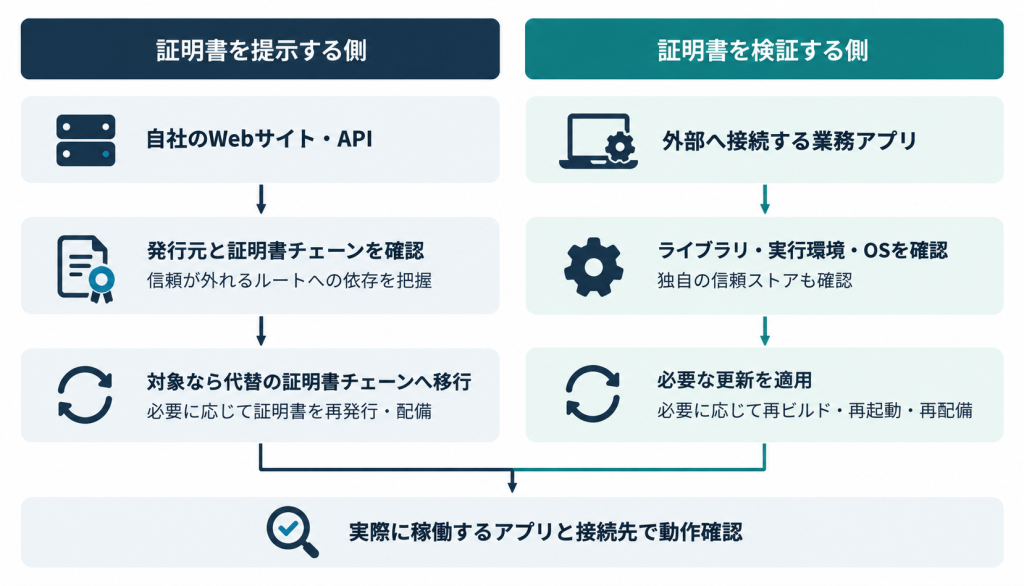
証明書を提示する側と検証する側の確認範囲
出典:Mozilla Foundation(Bugzilla)「eMudhra: Private key compromise of Intermediate Certificates(Bug 2083449)」、Google LLC(Chrome Root Program)「Compromised eMudhra Intermediate Certificatesへの公式投稿」、Cloudflare, Inc.「8 eMudhra certificates are compromised. Here’s what you need to know」を基に編集部作成。
※企業における確認対象を整理した概念図です。記載したすべての製品や環境が影響を受けることを示すものではありません。対応の要否は、実際の証明書チェーン、検証機能の実装、ソフトウェアの更新状況によって異なります。

中間CA証明書の失効とルートCAの信頼取り消し

eMudhraは、問題の8件の中間CAからエンドユーザー向け証明書を発行していなかったと説明しています。ただし、それだけで第三者による偽造の可能性がなくなるわけではありません。誰かが秘密鍵を復元し、認証局の正規の発行手続きを経ずに証明書を作ることが問題だからです。

Mozillaは、中間CAだけを個別に拒否する仕組みを持たないソフトウェアも保護するため、上位のルート証明書「emSign ECC Root CA – G3」の信頼を緊急に取り消す方針を示しました。GoogleもChrome Root Store v43で同ルートを削除する予定です。Googleが示した安定版への反映予定は、10月27日午前の米国太平洋夏時間で、10月22日時点では今後の対応に当たります。

ルートの信頼が外れると、問題の弱い鍵を使っていない別の中間CA配下であっても、そのルートにつながる正規のサーバー証明書が検証に失敗する場合があります。eMudhraは当初、移行が必要な証明書を約3万件と見積もりました。この数字は被害件数やWebサイト数ではありません。対象の階層を利用している場合は、有効期限を待たず、提供元の案内に沿って代替の証明書チェーンへ移行する必要があります。

FirefoxやGoなどの修正版と適用時の注意

Mozillaは10月20日、OneCRLの更新を受け取れない設定の利用者も保護するため、Firefox 158.0.1、Firefox ESR 115.43.1/153.5.1を公表しました。さらにAndroid版は10月21日に158.0.2が公開され、起動時に同梱のOneCRLブロックリストを適用する処理が修正されています。Android版では158.0.1だけを確認して対応済みとせず、この追加修正を含む更新を適用します。

Go 1.27.3および1.26.10では、対象の中間CA証明書を含む証明書チェーンを検証時に拒否する処理が追加されました。Goの脆弱性情報ではCVE-2026-111943、GO-2026-6809として管理されています。Go製アプリを運用する場合は、修正を取り込んだ製品版の有無を確認し、自社開発なら修正版でビルドした実行ファイルを配備することが対応になります。CloudflareはWARPなどのクライアントとcloudflaredの更新を公開しています。コンテナやアプリの依存関係も確認し、必要な再起動・再配備まで行います。

証明書の期限管理に検証経路の管理を加える

まず、WebサイトやAPIが提示する証明書チェーンを把握し、信頼が取り消される階層に依存していないかを確認します。同時に、外部のサービスへ接続する業務アプリについて、使用している証明書の検証機能と信頼ストアを調べます。証明書を提示する側と検証する側を分けると、証明書の交換が必要なのか、ソフトウェアやCA証明書の更新が必要なのかを整理できます。更新後は、実際の業務アプリで動作を確認します。ブラウザでの確認結果を、別の検証機能を使うバッチ処理やAPIクライアントの安全性の根拠にはできません。証明書エラーが出ても検証を無効にせず、チェーンや設定の原因を調べます。

今回の事案は、サーバー証明書が有効期限内であっても、認証局に対する信頼の変更によって証明書の交換やソフトウェアの更新が必要になることを示しています。企業には、証明書の発行元や有効期限だけでなく、証明書チェーンや検証に使用するソフトウェア、更新の管理体制まで把握し、継続的に確認することが求められます。


関連記事|TLS通信の安全性を確認するために

TLS通信の安全性を維持するには、証明書の信頼性に加え、暗号設定やTLSバージョンの適切な管理も重要です。基本的な仕組みから具体的な確認方法まで、以下の記事で紹介しています。

【参考情報】

編集責任:木下

ウェビナー開催のお知らせ

最新情報はこちら

Security Serviceへのリンクバナー画像
BBsecコーポレートサイトへのリンクバナー画像
セキュリティ緊急対応のバナー画像

Security NEWS TOPに戻る
バックナンバー TOPに戻る

CVE-2026-99999 PwnEscapeとは ―Linux仮想化基盤への影響と企業の対策

Share
CVE-2026-99999 PwnEscapeとはアイキャッチ画像

CVE-2026-99999(通称PwnEscape)は、LinuxカーネルのIPv4ネットワーク処理に存在する脆弱性です。仮想マシンからホストのメモリ情報が漏えいする問題が確認され、研究者の検証環境ではホストの停止や管理者権限でのコード実行も実証されています。

本記事では、実証結果と実際の被害を区別しながら、PwnEscapeの仕組みや影響範囲、修正版の確認方法を解説します。

PwnEscapeで問題となったLinuxのチェックサム処理

チェックサムは、通信データの誤りを検出するために使われる値です。仮想化環境では、その計算をゲスト側ですべて済ませず、ホスト側などの後続処理に任せる仕組みがあります。その際、どこから計算し、結果をどこに書くかを示すメタデータも受け渡されます。

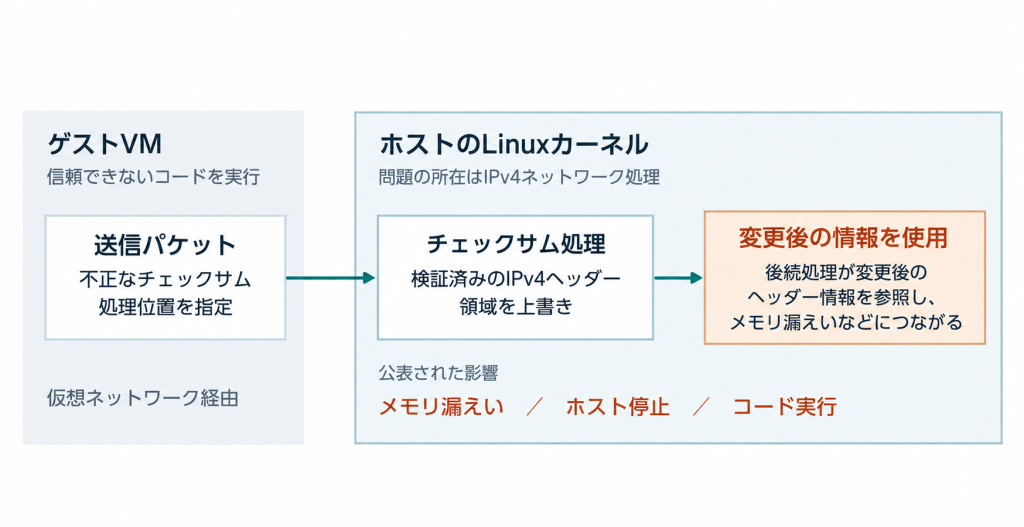
図1:PwnEscapeがホストへ影響する経路

PwnEscapeで仮想マシンからホストへ影響が及ぶ仕組み。ゲストVMから渡された不正なチェックサムメタデータが、ホストのIPv4ヘッダーを後から変更し、メモリ漏えいなどにつながる流れ。
出典:Linux Kernel Organization「Commit 6785011」(https://github.com/torvalds/linux/commit/6785011f8b16abf40b1e9d8b2e332232b3e68822)、CVE-2026-99999(https://raw.githubusercontent.com/CVEProject/cvelistV5/main/cves/2026/99xxx/CVE-2026-99999.json)、Vercel Inc. Findings from the $1M Vercel Sandbox challenge(https://vercel.com/blog/findings-from-the-1-million-dollar-vercel-sandbox-challenge)を基に弊社作成。
※通信処理を簡略化しています。通常のインターネット通信の受信による攻撃を示すものではありません。
※攻撃には、ゲストVMなどから問題の処理経路へ到達できる条件が必要です。実証環境と確認された影響は図2をご参照ください。

PwnEscapeでは、このメタデータの検証が不足していました。ホストがIPv4ヘッダーを読み取った後、不正な指定に従ってチェックサム処理を行うと、すでに確認したヘッダーを書き換えてしまいます。後続の処理が変更後の情報を信頼することで、メモリ漏えいなどの問題につながります。Linuxの修正は、チェックサムを完成させる前に、計算開始位置がIPv4ヘッダーと重ならないかを検証するものです。

Vercel本番環境と研究者環境で実証された範囲

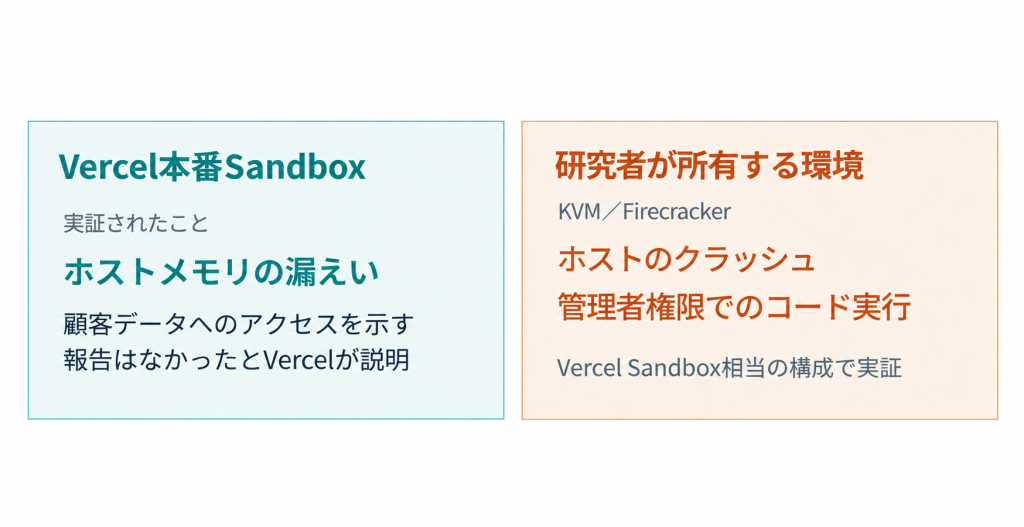
図2:公表資料で確認できる実証環境と結果

公表資料で確認できる実証環境と結果。Vercel本番Sandboxではホストメモリ漏えい、研究者所有のKVMとFirecracker環境ではホスト停止と管理者権限でのコード実行が実証されたことを比較した図。
出典:Vercel Inc. Findings from the $1M Vercel Sandbox challenge(https://vercel.com/blog/findings-from-the-1-million-dollar-vercel-sandbox-challenge)を基に弊社作成。
※Vercel本番環境でのホスト乗っ取りや、顧客情報へのアクセスが確認されたことを示すものではありません。
研究者による実証結果と、実際の攻撃への悪用状況は区別して記載しています。

Vercelは2026年10月14日、Sandboxのセキュリティ調査結果を公表しました*1。研究者Paulos Yibelo氏が、microVM内から送信する細工したパケットによってホストメモリを漏えいさせる攻撃を発見し、Vercelの本番Sandboxで実証したと説明しています。ホストのクラッシュと、ホスト上での管理者権限によるコード実行は、研究者が所有するKVMおよびFirecrackerの環境で実証されています。これらはVercel Sandboxに相当する構成での実証結果であり、Vercelの本番環境でホストの乗っ取りが確認されたことを意味するものではありません。また、Vercelは顧客のファイル、秘密情報、アプリケーションデータへのアクセスを示す報告はなかったと説明しています。

実際の攻撃への悪用状況については、公表資料の評価に違いが見られます。Red Hatには悪用を示唆する記述がある一方、CVE公式データに含まれるCISAの2026年10月16日付評価では「Exploitation: none」とされています。ただし、この評価は悪用が存在しないことを保証するものではありません。本記事では悪用の有無を断定せず、研究者による実証結果と区別して扱います。

信頼できないVMを実行するホストでは優先的な確認が必要

優先して確認したいのは、利用者が持ち込むコードや、信頼できないゲストVMを実行するLinuxホストです。AlmaLinuxは、クラウド、VPS提供基盤、コード実行用サンドボックスなど、他者のVMを運用する環境で特に重要な問題だと説明しています*2。障害がホストに及べば、その上で動く複数のVMも影響を受けます。「KVM escape」という呼び方は、ゲストとホストの隔離境界を越える影響を表しています。欠陥の所在はホスト側のLinuxネットワーク処理です。CVE公式レコードの攻撃元区分はLocalで、説明されているのはゲストやローカルの仮想デバイスを経由する経路です。通常のインターネット通信を受信するだけで任意のLinuxサーバーが侵害される、という意味ではありません。

一方、VMを動かしていないことだけで影響なしとも判断できません。Red Hatは、ローカルの攻撃者から問題の処理に到達する可能性も説明しています。利用している製品、カーネルの修正状況、攻撃に必要な操作を許しているかを、ベンダーの情報に沿って確認する必要があります。

CVSS 9.3の意味と修正版の確認方法

Linux CNAによるCVSS v3.1の評価は9.3(Critical)です。Red Hatは8.8、Importantと評価しており、必要な権限の扱いが異なります。点数だけで一律に判断せず、自社の環境で攻撃条件が成立するかと、ホスト停止時に影響する業務を併せて確認することが大切です。

CVE公式レコードは、影響するコードがLinux 2.6.27にさかのぼることを示しています。各安定版系列で修正を含むバージョンとして、5.10.272、5.15.223、6.1.190、6.6.159、6.12.113、6.18.57、7.2.11が記載されています。ただし、企業向けディストリビューションには、従来のカーネルを維持したまま修正を取り込むバックポートがあります。例えばAlmaLinuxは8、9、10向けに、それぞれのパッケージ体系で修正版を案内しています。上流Linuxのバージョン番号との大小比較だけで、対策済みかどうかは決められません。

提供段階にも注意が必要です。AlmaLinuxの2026年10月16日付発表では、AlmaLinux 8、9、10向けの修正カーネルがtestingリポジトリで提供されており、10月21日時点でも公式発表に本番向けリポジトリへの移行は記載されていません。また、Ubuntuの公式情報では、主要なlinuxパッケージの対応状況が「Needs evaluation(評価待ち)」となっています*3。脆弱性の修正コードが公開されていても、利用製品の本番向け更新が提供されているとは限らないため、各ベンダーの最新情報を確認する必要があります。

ホストの更新を完了し対応状況を残す

対策の基本は、修正が適用されたホストカーネルへの更新です。AlmaLinuxは更新後の再起動と、稼働カーネルの確認を案内しています。仮想化ホストの再起動はゲストにも影響するため、事前にVMの移行や停止を計画する必要があります。運用では、利用している製品とホストの一覧に、ベンダーが示す修正版、更新の実施日、更新後に稼働しているカーネルをひも付けて管理すると、確認漏れを減らせます。クラウドサービスを利用していてホストを直接管理できない場合は、サービス提供者の案内と契約上の管理範囲を確認し、必要に応じて対応状況を問い合わせてください。

暫定策を採用するときも、適用条件の確認が欠かせません。CloudLinuxはチェックサムオフロードの無効化などを紹介していますが、部分的かつ未検証の緩和策と明記しています*4。設定変更を修正済みカーネルへの更新と同等に扱わず、利用製品の案内に従って判断する必要があります。

AIを活用した研究でも確認の中心は実証結果

研究者は、PwnEscapeの調査でAIを利用したと説明しています*5。人間が研究の方向付けや検証を主導し、AIをソースコードの解析や攻撃経路の検討に活用したという内容です。今回の事例は、研究者がAIを活用して脆弱性の発見や検証を進めたものです。AIが自律的に本番環境を侵害した、という説明にはなっていません。企業側の対応では、発見手法への注目に加え、どの製品に影響するか、どこまで実証されたか、修正は提供されているかを追う必要があります。今回のように評価や提供状況が資料ごとに異なるケースでは、情報源と確認日を残すことが、その後の判断を支えます。

脆弱性情報の収集と対応管理を支えるBBSecのSAS

脆弱性情報を見つけた後は、自社に関係する製品を選別し、必要な対応とその進捗を管理することが重要です。ブロードバンドセキュリティ(BBSec)の「脆弱性情報提供 SAS(Secure Net Alert Mail Service)」は、登録したシステム情報を基に必要な脆弱性情報を絞り込み、メールと管理画面で提供します。脆弱性ごとの対応ステータス管理や、環境に応じた脅威判定に用いるCVSS計算機能も備えています。日本語の情報を重視するベーシック、情報の早さを重視するエクスプレスなど、運用に合わせたプランを選べます。入手した情報への対応方法については、セキュリティ・アドバイザリのオプションで助言を受けることもできます。

さらに、対応計画や社内ルールを含めて体制を見直したい場合には、BBSecの「情報セキュリティ・アドバイザリ」が、現状の把握、実施計画のレビュー、対策推進への助言を通じて支援します。脆弱性情報の収集負担や対応管理に課題がある方は、SASの活用と併せてご相談ください。

PwnEscapeへの対応では、まず自社またはサービス提供者が管理するホストの修正状況を確認することが出発点です。担当者と対応期限を定め、修正版への更新が実際の稼働環境に反映されたところまで追跡してください。

【参考情報】

編集責任:木下

ウェビナー開催のお知らせ

最新情報はこちら

Security NEWS TOPに戻る
バックナンバー TOPに戻る

2026年2Q KEVカタログ掲載CVEの統計と分析

Share
2026年2Q KEVカタログ掲載CVEの統計と分析アイキャッチ画像

前回記事では、米CISAから公開された「KEVカタログ(Known Exploited Vulnerabilities)」へ2026年第1四半期(1Q)に追加された脆弱性を統計的に分析し、実際に悪用された脆弱性から見える攻撃傾向について解説しました。本記事では、2026年4月1日から6月30日までにKEVカタログへ追加された脆弱性を対象に、前回四半期との比較を交えながら、2026年第2四半期(2Q)に見られた特徴を整理します。

2026年2四半期(2Q)の統計データ概要

2026年2QにKEVカタログへ追加された脆弱性は75件でした。2026年第1四半期(1Q)と比較すると4件増加しており、件数だけを見ると大きな変化ではありません。しかし、KEVは「実際に悪用されたことが確認された脆弱性」を掲載するカタログであるため、追加件数の増減以上に「どのような脆弱性が追加されたのか」を見ることが重要です。

月別では追加件数にばらつきが見られ、一時的な集中というよりは、四半期を通じて継続的に新たな悪用事例が確認されたことが分かります。

月別のKEV追加件数

月追加件数構成比
4月3141.3%
5月2128.0%
6月2330.7%

このことは、攻撃者が特定の大型脆弱性だけを狙うのではなく、新たに公開された脆弱性や過去の脆弱性を継続的に攻撃対象へ組み込んでいることを示唆しています。

主要ベンダー別の内訳

KEVへ追加された脆弱性をベンダー別に見ると、複数の脆弱性が同一ベンダーへ集中しているケースが確認されました。一方で、2026年2Qの特徴は、特定ベンダーへの極端な集中というよりも、ネットワーク機器、リモート管理ツール、業務システム、Webアプリケーションなど、幅広い製品群に悪用対象が広がっていることです。

企業が保有するIT資産は多様化しており、攻撃者もそれに合わせて侵入口を分散させています。そのため、「Microsoft製品だけを優先する」「VPN製品だけを重点管理する」といった限定的な運用では十分とは言えません。

ベンダー別KEV追加件数(上位10社)

順位ベンダーQ2件数Q1件数増減
1Microsoft1512+3
2Cisco74+3
3SimpleHelp30新規
3Ubiquiti30新規
3Ivanti32+1
3Adobe30新規
7LiteSpeed20新規
7Oracle20新規
7Google23-1
7BerriAI20新規

特に管理用途で利用される製品やインターネットへ公開される機器は、侵害された場合の影響が大きく、継続して攻撃対象となっています。

脆弱性タイプ(CWE)の分布

CWE件数
CWE-22(パストラバーサル)6
CWE-20(不適切な入力検証)5
CWE-94(コードインジェクション)5
CWE-287(不適切な認証)5
CWE-306(重要な機能の使用に対する認証の欠如)4
CWE-502(不適切なデータ逆シリアル化)3
CWE-78(OSコマンドインジェクション)3
CWE-284(不適切なアクセス制御)3
CWE-89(SQLインジェクション)3

KEVに追加された脆弱性をCWE別に分類すると、依然として攻撃者が初期侵入に利用しやすい脆弱性が多く確認されました。代表的な脆弱性として以下が上位を占めています。

  • OSコマンドインジェクション
  • 認証回避
  • 不適切な認可
  • パストラバーサル
  • リモートコード実行(RCE)

これらはいずれも、攻撃者が認証前または低権限の状態からシステムへ侵入し、その後の権限昇格や横展開につなげやすい脆弱性です。特に認証回避や認可不備は、CVSSスコア以上に実運用への影響が大きく、VPN機器や管理画面、リモート保守製品などで繰り返し悪用されています。

脆弱性の種類を見ると、「攻撃者が最初にシステムへ入り込むための入り口」が依然として重点的に狙われていることが分かります。

攻撃の自動化容易性(Automatable)

2026年第2Qも、自動化が容易である「Yes」と評価された脆弱性が一定数確認されました。攻撃者は現在、脆弱性を発見すると短期間でスキャンツールへ組み込み、インターネット上の対象を広範囲に探索するケースが一般的です。認証回避やリモートコード実行(RCE)の脆弱性は、PoC(概念実証コード)が公開されると、数日から数週間で大規模なスキャンの対象になることも珍しくありません。

企業側としては、「実際に狙われてから対応する」のではなく、自動化攻撃の対象になり得る脆弱性については、公開直後から迅速なパッチ適用や緩和策の実施を検討する必要があります。

CVSSスコア分布‐CVSSだけでは優先順位は決められない‐

重大度Q2件数Q2構成比Q1件数
Critical(9.0~10.0)2736.0%30
High(7.0~8.9)3850.7%34
Medium(4.0~6.9)1013.3%7
Low/None00%0

KEVへ登録された脆弱性のCVSSを集計すると、CriticalとHighを合わせて全体の約87%を占めました。これは高リスク脆弱性が多いことを示していますが、一方でMedium評価の脆弱性もKEVへ登録されています。つまり、CVSSがそれほど高くなくても、実際に悪用されれば優先的な対応対象になるという点が、KEVの大きな特徴です。

CVSSは技術的な深刻度を示す指標ですが、攻撃者が利用するかどうかまでは評価していません。そのため、脆弱性管理ではCVSSとKEVを組み合わせて優先順位を判断することが重要になります。また、現在はCVSS v3.xとCVSS v4.0が混在しており、単純なスコア比較には注意が必要です。評価体系が異なるため、スコアだけで危険性の増減を判断すべきではありません。

実際にランサムウェア攻撃に悪用された脆弱性

2026年第2Qでは、12件(全体の16.0%)の脆弱性でランサムウェアとの関連が確認されました。件数だけを見ると全体の一部に見えますが、ランサムウェア攻撃で利用される脆弱性は、侵入後に高い権限を取得できるものや、企業ネットワーク全体へ影響を及ぼしやすいものが多い点に注意が必要です。

一方で、「Unknown」と分類された脆弱性は、「ランサムウェアでは利用されていない」という意味ではありません。現時点で公開情報から確認できていないことを示しており、今後の調査やインシデント分析によって状況が変わる可能性があります。

第1四半期(1Q)との比較

追加件数だけを見ると、2Qは1Qから大きく増加したわけではありません。しかし、登録された脆弱性の内容を見ると、いくつかの特徴が見えてきます。

まず、攻撃対象が特定のベンダーに集中するのではなく、ネットワーク機器やリモート管理ツール、業務システム、Webアプリケーション、開発環境など、多様な製品へ広がっている点が挙げられます。また、認証回避や認可不備といった初期侵入につながる脆弱性が引き続き多く確認されました。こうした傾向からは、攻撃者が新たな攻撃手法を次々と生み出すというよりも、既知の脆弱性を効率的に悪用し、侵入の足掛かりとして利用している状況がうかがえます。

さらに、KEVには公開から時間が経過した脆弱性も継続して追加されています。これは、攻撃者が古い脆弱性を積極的に狙っているというよりも、パッチ未適用のシステムやサポート終了製品が依然として運用されている実態を反映している可能性があります。脆弱性が公表されてから時間が経過していても、適切な更新が行われていなければ、引き続き攻撃対象となることを示していると言えるでしょう。

統計から見える3つのポイント

2026年2QのKEVを俯瞰すると、特に注目すべき点は次の3つです。

攻撃対象の分散

従来は特定ベンダーのゼロデイ脆弱性が大きく注目されることがありましたが、第2四半期は幅広い製品が攻撃対象となりました。企業は個別製品への対応だけでなく、自社が保有する資産全体を把握した上で、継続的に脆弱性を管理する必要があります。

自動化攻撃への対応

Automatableと評価された脆弱性は、公開後短期間で大規模なスキャンの対象になる可能性があります。攻撃が始まってから対応するのではなく、KEVへの追加を一つの判断材料として優先的に対処することが重要です。

CVSSだけでは優先順位を決められない

高いCVSSスコアを持つ脆弱性への対応はもちろん重要ですが、実際に攻撃で悪用されているという事実は、運用上さらに重要な意味を持ちます。KEVは、その「実際の悪用」という観点を補完する情報源として活用できます。

まとめ

2026年2Qは、件数そのものよりも、攻撃対象の多様化や、自動化しやすい脆弱性、認証回避など初期侵入を容易にする脆弱性が継続して悪用されている点が特徴的でした。これらは特定の業種や製品に限った問題ではなく、多くの組織が共通して直面するリスクと言えるでしょう。定期的にKEVの追加状況を確認し、自社資産との照合やパッチ適用の優先順位付けへ活用することは、限られたリソースで効果的な脆弱性管理を実施するための重要な取り組みとなります。

件数や分類だけでは、実際の攻撃者がどのような製品を標的とし、どのような脆弱性を悪用しているのかまでは見えてきません。実際に攻撃で悪用された事例の分析については以下の記事をご覧ください。
「2026年2Q KEVカタログに見る攻撃トレンド ― 実際に悪用された脆弱性から読み解く攻撃者の狙い」

【参考情報】

編集責任:木下


BBSecでは

アタックサーフェス調査サービス

インターネット上で「攻撃者にとって対象組織はどう見えているか」調査・報告するサービスです。攻撃者と同じ観点に立ち、企業ドメイン情報をはじめとする、公開情報(OSINT)を利用して攻撃可能なポイントの有無を、弊社セキュリティエンジニアが調査いたします。


サイバーインシデント緊急対応

セキュリティインシデントの再発防止や体制強化を確実に行うには、専門家の支援を受けることも有効です。BBSecでは緊急対応支援サービスをご提供しています。突然の大規模攻撃や情報漏洩の懸念等、緊急事態もしくはその可能性が発生した場合は、BBSecにご相談ください。セキュリティのスペシャリストが、御社システムの状況把握、防御、そして事後対策をトータルにサポートさせていただきます。

サイバーセキュリティ緊急対応電話受付ボタン
SQAT緊急対応バナー

ウェビナー開催のお知らせ

  • 2026年8月19日(水)14:00~15:00「セキュリティ対策の有効性を検証する ―ペネトレーションテストの実施ポイントと脆弱性診断との違い―」
  • 2026年8月26日(水)「AI時代に見直すセキュリティ対策 ~ASMの考え方で始める攻撃対象領域の可視化とリスク対策~」
  • 最新情報はこちら


    資料ダウンロードボタン
    年二回発行されるセキュリティトレンドの詳細レポート。BBSecで行われた診断の統計データも掲載。
    お問い合わせボタン
    サービスに関する疑問や質問はこちらからお気軽にお問合せください。

    Security Serviceへのリンクバナー画像
    BBsecコーポレートサイトへのリンクバナー画像
    セキュリティ緊急対応のバナー画像

    Security NEWS TOPに戻る
    バックナンバー TOPに戻る

    DDoS攻撃とは?仕組み・種類・被害・対策を企業向けに解説

    Share

    Security NEWS TOPに戻る
    バックナンバー TOPに戻る

    DDoS攻撃とは?仕組み・種類・被害・対策を企業向けに解説アイキャッチ画像

    DDoS攻撃は、大量の通信を送り付けて、Webサイトやサーバーを利用しにくくするサイバー攻撃です。サービス停止や業務の停滞を招くおそれがあるため、企業は仕組みと対策を理解しておく必要があります。本記事では、DDoS攻撃の種類や被害、基本的な対策を解説します。

    DoS攻撃との違いを詳しく知りたい方、実際にDDoS攻撃を受けた場合の初動対応や復旧の流れについて知りたい方は以下の記事もあわせてご覧ください。
    「DoS攻撃とDDoS攻撃の違いとは」
    「DDoS攻撃を受けたらどうする?」

    DDoS攻撃とは

    DDoS攻撃(Distributed Denial of Service attack)は、Webサイトやサーバー、ネットワーク機器などに大量の通信やリクエストを送り付け、正常なサービス提供を妨害するサイバー攻撃です。攻撃を受けると、Webサイトの表示遅延やサービス停止、ネットワークの応答遅延などが発生し、正規の利用者がサービスを利用できなくなることがあります。

    DDoS攻撃の特徴は、攻撃者が多数の端末やネットワークを利用する点にあります。攻撃者は、マルウェアなどに感染した機器で構成される「ボットネット」を悪用します。

    世界中の端末から一斉に通信を送るため、単一の送信元を遮断するだけでは防ぎにくい攻撃です。近年では、ECサイトや金融機関、自治体、医療機関など、幅広い組織が標的となっています。企業規模を問わず対策が求められています。

    また、DDoS攻撃は、サービス停止だけを目的とするものではありません。攻撃による混乱に乗じて、不正アクセスや情報窃取など、別の攻撃を試みる「陽動」として利用されるケースもあります。

    DDoS攻撃を理解するためには、まずDoS攻撃との違いや、どのような目的で実行されるのかを知ることが重要です。

    DoS攻撃との違い

    DoS攻撃は、単一または少数の端末からサービスを妨害する攻撃です。DDoS攻撃は、多数の端末から分散して通信を送るため、攻撃元の特定や遮断が難しくなります。

    DoS攻撃とDDoS攻撃の違いについては、以下の記事で詳しく解説しています。ぜひあわせてご覧ください。「DoS攻撃とDDoS攻撃の違いとは」

    なぜDDoS攻撃が行われるのか

    DDoS攻撃の目的は、単にWebサイトやサービスを停止させることだけではありません。企業活動を妨害したり、金銭を要求したり、別のサイバー攻撃を成功させるための陽動として利用されたりするなど、さまざまな目的で実行されます。

    例えば、ECサイトや予約システムを停止させることで売上機会の損失を狙うケースや、競合他社への業務妨害を目的とした攻撃が報告されています。

    また、サービス停止による混乱の中で、不正アクセスや情報窃取を試みることもあります。このような「陽動攻撃」として、DDoS攻撃が利用されるケースもあります。

    近年では、IoT機器の普及やボットネットの大規模化が進んでいます。その結果、専門的な知識がなくても、攻撃サービスを利用して大規模なDDoS攻撃を実行できる環境が問題視されています。

    こうしたサービスは、DDoS-for-Hire、すなわちDDoS請負サービスなどと呼ばれます。そのため、企業規模を問わず、DDoS攻撃を想定した備えが重要になっています。

    DDoS攻撃の仕組み

    DDoS攻撃は、多数の端末やサーバから、標的へ一斉に大量の通信を送る攻撃です。サーバやネットワーク機器に過剰な負荷をかけ、正常なサービス提供を妨げます。

    攻撃対象は、Webサイトだけではありません。DNSサーバやVPN、API、クラウドサービスなど、多岐にわたります。

    攻撃者は、自ら大量の通信を送るのではありません。マルウェアに感染したIoT機器やパソコン、サーバーなどを遠隔操作します。そして、ボットネットを構築して攻撃を実行するのが一般的です。

    また、DDoS攻撃は、大量の通信によって回線帯域を圧迫するものだけではありません。ネットワーク機器に負荷をかける攻撃や、Webアプリケーションへ大量のリクエストを送る攻撃など、複数の手法があります。

    そのため、自社サービスを守るためには、攻撃の仕組みを理解し、それぞれの手法に応じた対策を講じることが重要です。

    ボットネットによる分散攻撃

    DDoS攻撃では、多くの場合「ボットネット(Botnet)」と呼ばれるネットワークが悪用されます。ボットネットとは、マルウェアに感染したパソコンやサーバ、IoT機器などが攻撃者の遠隔操作下に置かれた状態のネットワークです。攻撃者はこれらの端末へ一斉に指示を送り、標的に大量の通信を発生させます。

    近年では、監視カメラやルーター、ネットワーク機器など、十分なセキュリティ対策が施されていないIoT機器がボットネットに組み込まれる事例も確認されています。機器の所有者が気付かないまま攻撃に加担しているケースも少なくありません。

    ボットネットを利用したDDoS攻撃では、世界中に分散した多数の端末から同時に通信が送られるため、単一の送信元を遮断するだけでは十分な対策が難しくなります。

    攻撃の流れ

    DDoS攻撃は、一般的に次のような流れで実行されます。

    1. ボットネットの構築
      攻撃者は、マルウェアに感染したパソコンやサーバー、IoT機器などを遠隔操作できる状態にし、ボットネットを構築します。
    2. 攻撃対象の選定
      WebサイトやECサイト、VPN、DNSサーバー、APIなど、攻撃対象となるシステムを選定します。
    3. 攻撃命令の送信
      攻撃者がボットネットへ攻撃命令を送ると、多数の端末が一斉に標的へ通信やリクエストを送信します。
    4. サービスへの影響
      大量の通信によってネットワーク回線やサーバー、ネットワーク機器、Webアプリケーションに負荷がかかり、応答遅延やサービス停止などが発生します。

    攻撃の種類によっては、ネットワーク帯域を圧迫するだけでなく、ファイアウォールやロードバランサーなどのネットワーク機器に負荷をかけるものや、Webアプリケーションへ大量のリクエストを送るものもあります。そのため、攻撃の種類に応じた対策を講じることが重要です。

    DDoS攻撃の主な種類

    DDoS攻撃にはさまざまな手法がありますが、大きく分けると「ボリューム攻撃」「プロトコル攻撃」「アプリケーション層攻撃」の3種類に分類できます。

    攻撃対象や攻撃方法が異なるため、サービスへの影響や有効な対策もそれぞれ異なります。攻撃の種類を理解することは、自社サービスがどのようなリスクにさらされているのかを把握し、適切な対策を講じるための第一歩です。

    ここでは、代表的な3つの攻撃手法について解説します。

    ボリューム攻撃

    ボリューム攻撃は、大量の通信を送り付けてネットワーク回線の帯域を圧迫し、正規の利用者がサービスへアクセスできない状態にする攻撃です。DDoS攻撃の中でも代表的な手法であり、回線容量を超える通信が発生すると、サーバーが正常に稼働していてもサービスを利用できなくなることがあります。

    代表的な手法として、UDP FloodやDNS Amplification(DNSリフレクション攻撃)、NTP Amplificationなどがあります。特にDNSやNTPなどの公開サーバーを悪用する反射・増幅型攻撃では、小さなリクエストを利用して何倍もの通信量を発生させるため、攻撃者は比較的少ない通信量でも大きな負荷を与えることができます。

    プロトコル攻撃

    プロトコル攻撃は、TCP/IPなどの通信プロトコルの仕組みを悪用し、サーバーやファイアウォール、ロードバランサーなどのネットワーク機器に負荷をかける攻撃です。通信回線そのものを埋め尽くすボリューム攻撃とは異なり、ネットワーク機器やサーバーの処理能力を消費させることで、正常な通信を妨害します。

    代表的な手法としては、SYN Floodがあります。TCP通信の接続要求(SYNパケット)を大量に送り付けることで、サーバは接続待ちの状態を維持し続けることになり、新たな正規ユーザからの接続を受け付けられなくなる場合があります。このほか、Ping FloodやSmurf攻撃などもプロトコル攻撃の一種として知られています。

    アプリケーション層攻撃

    アプリケーション層攻撃は、WebサイトやWebアプリケーション、APIなどを標的とするDDoS攻撃です。利用者が直接アクセスするサービスが狙われます。

    通信量そのものはそれほど多くなくても、サーバーが処理に時間を要するリクエストを大量に送ることで、CPUやメモリなどのリソースを消費させ、サービスの応答遅延や停止を引き起こします。

    代表的な手法としてHTTP Floodがあります。通常のWeb閲覧と同じHTTPリクエストを大量に送信するため、正規のアクセスと見分けにくく、単純な通信量の監視だけでは検知が難しい場合があります。また、検索機能やログイン画面、APIなど、サーバー負荷の高い処理を集中的に狙う攻撃も確認されています。

    DDoS攻撃による被害

    DDoS攻撃による影響は、単にWebサイトが一時的に閲覧できなくなるだけではありません。サービス停止による売上機会の損失や業務の停滞、顧客対応の負荷増加など、企業活動全体へ影響が及ぶ可能性があります。

    また、長時間にわたってサービスが利用できない状態が続くと、企業の信頼低下やブランドイメージの毀損につながるおそれもあります。

    近年では、DDoS攻撃を単独で行うだけでなく、その混乱に乗じて不正アクセスや情報窃取など別の攻撃を試みるケースも報告されています。そのため、DDoS攻撃は単なる通信障害ではなく、企業の事業継続に関わるセキュリティリスクとして捉えることが重要です。

    ここでは、企業が受ける代表的な被害について解説します。

    サービス停止

    DDoS攻撃による代表的な被害は、Webサイトやオンラインサービスの停止です。

    大量の通信やリクエストが送られると、サーバーやネットワーク機器に過剰な負荷がかかります。その結果、Webページの表示遅延やタイムアウト、エラーが発生し、正規の利用者がサービスを利用できなくなることがあります。

    特に、ECサイトや予約システム、会員向けサービス、決済サービスなど、インターネットを通じて提供されるサービスでは、短時間の停止であっても売上機会の損失や顧客満足度の低下につながる可能性があります。

    さらに、DDoS攻撃ではサーバー自体に障害が発生していなくても、回線帯域の逼迫やネットワーク機器への負荷によってサービスが利用できなくなる場合があります。そのため、システムが正常に稼働しているように見えても、利用者からは「サービスが停止している」と認識されるケースも少なくありません。

    業務への影響

    DDoS攻撃の影響は、Webサイトの停止だけにとどまりません。公開サービスと社内システムが同じネットワークや認証基盤を利用している場合には、VPNや業務システム、クラウドサービスなどへ影響が及び、日常業務に支障をきたすことがあります。

    また、サービス停止に伴い、顧客や取引先からの問い合わせが急増し、カスタマーサポートや営業部門の対応負荷が高まることもあります。

    ECサイトでは注文処理や決済が滞り、BtoBサービスでは取引先の業務に影響を与えるなど、事業継続にも大きな影響を及ぼす可能性があります。さらに、障害対応のために情報システム部門やセキュリティ担当者が長時間の対応を余儀なくされ、本来予定していた業務が停滞するケースも少なくありません。

    企業の信頼低下

    DDoS攻撃によるサービス停止が長時間続いたり、繰り返し発生したりすると、企業に対する信頼の低下につながるおそれがあります。利用者は「サービスが安定して利用できない企業」という印象を持つ可能性があり、顧客離れや新規顧客の獲得機会の損失につながることもあります。

    さらに、DDoS攻撃をきっかけに、自社のセキュリティ対策やインシデント対応体制が十分であるかを取引先や顧客から問われることもあります。そのため、平時から適切な対策を講じるとともに、攻撃発生時には迅速かつ適切な対応を行うことが、企業の信頼維持につながります。

    企業が実施すべきDDoS攻撃対策

    DDoS攻撃は、完全に防ぐことが難しいサイバー攻撃の一つです。そのため、攻撃を受けることを前提に、被害を最小限に抑えるための対策を講じることが重要です。ここでは、企業が押さえておきたい代表的なDDoS攻撃対策を紹介します。

    通信の監視と異常検知

    DDoS攻撃による被害を最小限に抑えるためには、通信状況を継続的に監視し、通常とは異なるアクセスを早期に検知できる体制を整えることが重要です。

    アクセス数や通信量、リクエスト数などの推移を日頃から把握しておくことで、異常な増加が発生した際に迅速な対応につなげることができます。

    近年では、SIEM(Security Information and Event Management)やネットワーク監視ツールを活用し、異常な通信を自動で検知・通知する仕組みを導入する企業も増えています。

    DDoS攻撃は短時間で通信量が急増するケースが多いため、異常を検知してから対応を開始するまでの時間が重要です。

    CDN・WAF・DDoS対策サービスの活用

    DDoS攻撃は、攻撃元が世界中の多数の端末に分散しているため、自社設備だけで防ぎきることは難しく、外部サービスとの連携が対策の基本方針になります。特に、大量の通信が発生するボリューム攻撃では、自社ネットワークに到達する前に不要な通信を分散・遮断する仕組みが重要になります。

    • CDN(Content Delivery Network):コンテンツを複数のサーバーに分散して配信することで、通信負荷を分散し、サービスの継続性向上に役立ちます。
    • WAF(Web Application Firewall):Webアプリケーションへの不正なアクセスや不審なリクエストを検知・制御する機能を備えており、特にアプリケーション層を狙った攻撃への対策として有効です。
    • DDoS対策サービス:専用の設備で攻撃トラフィックを検知・吸収・フィルタリングし、正常な通信のみを自社環境へ転送する仕組みを提供しています。

    攻撃の規模やサービスの重要度に応じて、ISPやクラウド事業者が提供する対策サービスも含め、自社に適した構成を検討するとよいでしょう。

    自社の対策状況に不安がある場合

    「どのサービスを、どこまで導入すべきか」の判断が難しい場合は、専門会社によるDDoS耐性評価・セキュリティ診断を活用するのも一つの方法です。現状のリスクを可視化したうえで、優先度をつけて対策を進めることができます。

    インシデント対応体制の整備

    DDoS攻撃は、技術的な対策だけで完全に防ぐことは困難です。そのため、攻撃を受けた際に迅速かつ適切に対応できる体制をあらかじめ整備しておくことが重要です。

    具体的には、攻撃発生時の連絡体制や対応手順を文書化し、情報システム部門だけでなく、経営層や広報部門、カスタマーサポート部門など、関係者の役割を明確にしておくことが求められます。

    また、ISPやクラウド事業者、セキュリティベンダーなどの連絡先や支援体制を事前に確認しておくことで、緊急時の対応を円滑に進められます。

    まとめ

    DDoS攻撃は、大量の通信によってWebサイトやネットワークサービスを利用できない状態にするサイバー攻撃です。攻撃手法にはボリューム攻撃、プロトコル攻撃、アプリケーション層攻撃などがあり、それぞれ特徴や有効な対策が異なります。

    企業は、通信の監視や異常検知、CDN・WAF・DDoS対策サービスの活用に加え、インシデント対応体制の整備など、多層的な対策を講じることが重要です。また、攻撃を完全に防ぐことは難しいため、被害を最小限に抑えるための備えも欠かせません。

    攻撃発生時の具体的な対応手順や、復旧までの流れについては、以下の記事で詳しく解説しています。あわせてご覧ください。
    「DDoS攻撃を受けたらどうする?初動対応から復旧までの流れを解説」

    【関連記事】

    DDos攻撃について、SQAT.jpでは以下の記事でも解説しています。こちらもあわせてぜひご覧ください。

    【参考情報】


    DDoS対策や公開システムのセキュリティに不安はありませんか?

    DDoS攻撃への備えには、ネットワークやWebアプリケーションのリスクを把握することが重要です。BBSecでは、脆弱性診断をはじめ、お客様の環境に応じたセキュリティ評価をご提供しています。

    Webアプリケーション脆弱性診断バナー

    アクセス急増の原因が複雑で判断が難しい場合や、継続的な運用に不安がある場合は、第三者の視点を取り入れることも有効です。定期的なセキュリティ診断や評価を通じて、自社では気づきにくいリスクを把握することができます。


    公開日:2021年6月23日
    更新日:2026年7月29日

    編集責任:木下


    資料ダウンロードボタン
    年二回発行されるセキュリティトレンドの詳細レポート。BBSecで行われた診断の統計データも掲載。
    お問い合わせボタン
    サービスに関する疑問や質問はこちらからお気軽にお問合せください。

    Security Serviceへのリンクバナー画像
    BBsecコーポレートサイトへのリンクバナー画像
    セキュリティ緊急対応のバナー画像

    Security NEWS TOPに戻る
    バックナンバー TOPに戻る

    APT攻撃対策とは?検知・監視・初動対応の考え方

    Share
    APT攻撃対策とは?検知・監視・初動対応の考え方アイキャッチ画像

    前回記事で解説した通り、APT攻撃は標的組織を事前に調査したうえで侵入し、権限昇格や横展開を重ねながら目的の情報に近づいていきます。一度侵入を許すと長期間にわたり情報窃取や不正活動が継続するケースも少なくありません。そのためAPT攻撃対策では「侵入させない」ことだけを目指すのではなく、侵入前対策・侵入後対策・インシデント対応体制を組み合わせ、早期発見と被害最小化を実現する仕組みが欠かせません。本記事では、その具体的な対策内容について解説します。

    APT攻撃の侵入経路や攻撃の流れについて詳しく知りたい方は、「APT攻撃の手口とは?侵入から情報窃取までの流れを解説」で、初期侵入から情報窃取までのプロセスを解説しています。ぜひあわせてご覧ください。

    なぜAPT攻撃は防ぎにくいのか

    APT攻撃が防ぎにくい理由は、攻撃者が特定の組織を狙い、時間をかけて侵入経路を探すためです。一般的なマルウェア感染やばらまき型攻撃とは異なり、APT攻撃では、攻撃者が標的組織の業務、取引先、利用システム、従業員の役割などを事前に調査します。そのうえで、標的型メールや脆弱性の悪用、正規アカウントの不正利用など、検知されにくい手口を選びます。また、APT攻撃では、最初の侵入後すぐに目立つ被害が発生するとは限りません。攻撃者は内部ネットワークに潜伏し、権限昇格や横展開を行いながら、機密情報や認証情報の所在を探ります。正規の管理ツールや盗まれたID・パスワードを使って活動する場合もあり、従来型の境界防御だけでは不審な動きを見落とす可能性があります。そのため、APT攻撃対策では、入口を守る対策に加えて、侵入後の異常を検知する仕組み、ログをもとに調査できる体制、被害を最小化する初動対応が欠かせません。さらに、入口対策だけでなく、「侵入を前提」とした検知・監視・対応体制も必要です。

    侵入前対策

    APT攻撃への備えとして、まず重要になるのは侵入前対策です。侵入前対策とは、攻撃者が組織内へ入り込む可能性を下げるための基本的な防御策です。完全な防御は難しいものの、攻撃者にとって侵入しにくい環境を作ることで、被害の発生確率を下げることができます。 なかでも重要なのが、多要素認証、脆弱性管理、標的型メール対策です。これらは単独ではなく、多層防御の考え方で組み合わせることが重要です。複数の対策を組み合わせ、攻撃者が一つの弱点を突破しても、次の段階へ進みにくい状態をつくることが求められます。

    MFA(多要素認証)

    IDとパスワードだけに頼らず、スマートフォンアプリ、セキュリティキー、生体認証など、複数の認証要素を組み合わせて本人確認を行う仕組みです。APT攻撃では、フィッシングメールやマルウェアによって認証情報が盗まれることがあります。IDとパスワードだけで社内システムやクラウドサービスへアクセスできる環境では、攻撃者が正規ユーザになりすましてログインするリスクが高まります。MFAを導入することで、パスワードが漏えいした場合でも、不正ログインを防げる可能性が高まります。ただし、MFAを導入すればすべての攻撃を防げるわけではありません。近年は、MFAを突破しようとするフィッシングや、認証疲れを狙った攻撃も確認されています。そのため、可能であればフィッシング耐性の高い認証方式(例:FIDO2、パスキーなど)を採用し、管理者アカウントやリモートアクセス、クラウド管理画面など、重要度の高い環境から優先的に適用することが重要です。

    脆弱性管理

    APT攻撃では、VPN機器、公開サーバ、メールサーバ、業務システム、クラウド環境などの脆弱性が侵入経路として悪用されることがあります。特に、インターネットからアクセス可能な機器やシステムに未修正の脆弱性が残っている場合、攻撃者にとって侵入の足がかりになります。脆弱性管理では、単に脆弱性情報を収集するだけでなく、自社のどのシステムに影響があるのか、外部公開されているのか、悪用事例があるのか、業務上の重要度は高いのかを踏まえて、対応の優先順位を決める必要があります。すべての脆弱性へ同時に対応することは現実的ではないため、実際に悪用されている脆弱性や、外部から攻撃可能なシステムを優先して修正する考え方が重要です。また、パッチ適用がすぐに難しい場合には、一時的な回避策、アクセス制限、監視強化、不要サービスの停止などを組み合わせる必要があります。APT攻撃では、脆弱性の放置が初期侵入や横展開につながる可能性があるため、脆弱性管理は単なる情報システム部門の運用作業ではなく、経営リスクを下げるための重要な取り組みといえます。

    標的型メール対策

    標的型メールは、APT攻撃の代表的な侵入経路の一つです。現在はメールだけでなく、チャットやクラウドサービスを悪用した攻撃も増えています。標的型メール対策では、メールセキュリティ製品による検査だけでなく、従業員教育、訓練、報告しやすい仕組みの整備が重要です。攻撃メールを完全に遮断することは難しいため、従業員が不審なメールに気づき、開封前または開封後すぐに報告できる体制を作る必要があります。また、メールをきっかけに認証情報が入力されるケースもあるため、MFAやアクセス制御と組み合わせて対策することが効果的です。標的型メール対策は、単独で完結するものではなく、認証管理、端末防御、ログ監視、インシデント対応と連動させることで、初めてAPT攻撃への実効性が高まります。

    標的型攻撃の手口の詳細は「標的型攻撃とは?代表的な手口と企業が取るべき対策を解説」をご参照ください。

    侵入後対策

    APT攻撃では、侵入前対策をすり抜けられる可能性があります。そのため、侵入後に攻撃者の活動を検知し、被害拡大を防ぐ仕組みが必要です。侵入後対策の中心になるのが、EDR、SIEM、ログ監視です。従来のセキュリティ対策では、外部からの攻撃を境界で防ぐことに重点が置かれてきました。しかし、クラウド利用、テレワーク、サプライチェーン連携が広がる現在では、社内と社外の境界があいまいになっています。APT攻撃への対策では、端末、サーバー、ネットワーク、クラウド、IDの動きを継続的に監視し、通常とは異なる振る舞いを早期に見つけることが重要です。

    EDR

    EDRは、Endpoint Detection and Responseの略で、PCやサーバーなどのエンドポイント上の不審な挙動を検知し、調査や対応を支援する仕組みです。APT攻撃では、マルウェアの実行、認証情報の窃取、管理ツールの悪用、不審なプロセスの起動などが端末上で発生することがあります。EDRは、こうした端末上の動きを可視化し、攻撃の兆候を把握するために有効です。EDRの重要な役割は、単にマルウェアを検知することではありません。侵入後に何が起きたのか、どの端末からどの端末へ移動したのか、どのファイルが操作されたのか、どのアカウントが使われたのかを調査するための情報を提供する点にあります。APT攻撃では、発見時点で攻撃がすでに横展開している場合もあります。そのため、EDRによって端末単位の挙動を把握し、感染端末の隔離、プロセス停止、調査対象の特定などを迅速に行える状態を整えておく必要があります。最近では、EDRに加え、メールやクラウドも含めて分析するXDRを導入する企業も増えています。

    SIEM

    SIEMは、Security Information and Event Managementの略で、複数のシステムからログを集約し、相関分析(複数のログを組み合わせて関連性を分析すること)を行う仕組みです。APT攻撃では、個々のログだけを見ると小さな異常に見える行動が、複数のログを組み合わせることで攻撃の流れとして見えてくることがあります。たとえば、通常とは異なる国や地域からのログイン、深夜帯の管理者権限利用、短時間での大量アクセス、普段使わない端末からの認証、ファイルサーバへの大量アクセスなどは、単独では見逃されることがあります。しかし、SIEMで複数のログを関連付けることで、初期侵入、権限昇格、横展開、情報窃取の兆候を把握しやすくなります。SIEMを有効に活用するには、ログを集めるだけでなく、どのログを監視対象にするのか、どのような条件でアラートを出すのか、誰が確認するのか、アラート発生後にどのような初動を取るのかを事前に決めておく必要があります。そしてツールを導入するだけではなく、運用設計まで含めて整えることも重要です。社内で運用が難しい場合は、SOCサービスなど外部監視サービスを利用する方法もあります。

    ログ監視

    ログ監視は、APT攻撃対策の基盤となる取り組みです。攻撃者の行動は、認証ログ、端末ログ、プロキシログ、DNSログ、VPNログ、クラウドサービスの監査ログ、ファイルアクセスログなどに痕跡として残ることがあります。しかし、ログが取得されていなかったり、保存期間が短かったり、必要な項目が記録されていなかったりすると、インシデント発生後に攻撃の流れを追跡できません。特にAPT攻撃では、侵入から発見までに時間がかかることがあるため、一定期間のログを保管し、過去にさかのぼって調査できる状態を作る必要があります。ログ監視では、単に大量のログを保存するだけでは不十分です。重要なのは、通常時のアクセス傾向を把握し、そこから外れた動きを見つけることです。普段アクセスしないサーバーへの接続、短時間での権限変更、退職者アカウントの利用、海外からのVPN接続、大量のファイル圧縮や外部送信など、攻撃の兆候となる行動を継続的に確認する必要があります。保持期間は法令や業種要件、インシデント対応を考慮して決める必要があります。

    ゼロトラストの考え方

    ここまで紹介した侵入前対策・侵入後対策は、いずれもゼロトラストという一つの考え方の実装例と捉えることができます。

    ゼロトラストとは、社内ネットワークにいるから安全、正規ユーザだから安全といった前提を置かず、ユーザ、端末、アプリケーション、データへのアクセスを継続的に確認する考え方です。従来の境界防御では、社内ネットワークの内側を比較的信頼する考え方が一般的でした。しかし、APT攻撃では、一度内部へ侵入した攻撃者が正規アカウントや管理ツールを悪用し、横展開する可能性があります。そのため、社内ネットワーク内の通信であっても、常に正当性を確認し、必要最小限の権限だけを付与することが前提になります。ゼロトラストの実現には、MFA、ID管理、端末管理、アクセス制御、ログ監視、ネットワーク分離、継続的なリスク評価などが関係します。単一の製品を導入すれば完成するものではなく、組織の業務やシステム構成に合わせて段階的に整備していく必要があります。

    APT攻撃への対策としてゼロトラストを取り入れることで、攻撃者が一つのアカウントや端末を悪用しても、重要情報へ簡単に到達できない環境を作りやすくなります。侵入を前提に、被害範囲を限定し、異常を早期に検知するという点で、ゼロトラストはAPT対策と相性のよい考え方です。

    インシデント対応体制

    APT攻撃への対策では、検知した後の初動対応によって被害の大きさが大きく左右されます。初動対応では「封じ込め(Containment)」「根絶(Eradication)」「復旧(Recovery)」の順で進める考え方が一般的です。不審な挙動を発見しても、対応手順や判断基準が決まっていなければ、関係者への連絡、端末隔離、証拠保全、外部報告、復旧判断が遅れてしまいます。その間に攻撃者が横展開を進めたり、情報を外部へ持ち出したりする可能性があります。

    インシデント対応体制では、まず「誰が判断するのか」を明確にする必要があります。情報システム部門、セキュリティ担当、経営層、法務、広報、事業部門、外部専門家など、関係者の役割を事前に決めておくことが重要です。特にAPT攻撃では、技術的な調査だけでなく、事業影響、顧客対応、取引先対応、法的対応、広報対応が必要になる場合があります。 また、初動対応では、証拠を消さないことも重要です。感染が疑われる端末をすぐに初期化してしまうと、侵入経路や攻撃範囲を調査するための情報が失われる可能性があります。端末の隔離、ログ保全、アカウント停止、通信遮断、影響範囲の確認などを、状況に応じて慎重に実施する必要があります。平時からインシデント対応手順を整備し、訓練を行っておくことで、実際の攻撃発生時に混乱を減らすことができます。APT攻撃対策は、技術的な防御だけではなく、組織としてどのように判断し、対応するかまで含めた取り組みです。

    まとめ

    APT攻撃対策では、侵入を完全に防ぐことだけを目指すのではなく、侵入前対策、侵入後対策、インシデント対応体制を組み合わせることが重要です。MFA、脆弱性管理、標的型メール対策によって侵入リスクを下げ、EDR、SIEM、ログ監視によって侵入後の不審な動きを早期に検知します。さらに、インシデント対応体制を整備し、攻撃が疑われる場合に迅速な初動対応を取れるようにしておくことで、被害の拡大を抑えることができます。APT攻撃は、攻撃者が時間をかけて目的達成を狙う攻撃であるため、企業側も継続的な監視と改善を前提に備える必要があります。

    次の記事はこちら
    「APT攻撃事例から学ぶ ―国内外の被害事例と企業が取るべき対策―」
    APT攻撃は実際にどのような企業・組織で発生しているのでしょうか。代表的な国内外の事例から、攻撃の特徴や企業が学ぶべきポイントを解説します。

    【参考情報】

    編集責任:木下


    APT攻撃への備えをご検討中の方へ

    APT攻撃は、侵入を完全に防ぐことが難しい高度なサイバー攻撃です。侵入経路の把握や脆弱性管理、監視体制の強化など、継続的な対策が求められます。弊社、ブロードバンドセキュリティ(BBSec)では、脆弱性診断、アタックサーフェス管理調査、セキュリティ運用サービス、コンサルティングサービスなど、企業のセキュリティ対策を支援するサービスを提供しています。


    ウェビナー開催のお知らせ

    最新情報はこちら


    資料ダウンロードボタン
    年二回発行されるセキュリティトレンドの詳細レポート。BBSecで行われた診断の統計データも掲載。
    お問い合わせボタン
    サービスに関する疑問や質問はこちらからお気軽にお問合せください。

    Security Serviceへのリンクバナー画像
    BBsecコーポレートサイトへのリンクバナー画像
    セキュリティ緊急対応のバナー画像

    Security NEWS TOPに戻る
    バックナンバー TOPに戻る

    IT資産管理を効率化する方法とは?担当者が押さえたい運用のポイント

    Share
    IT資産管理を効率化する方法とは?アイキャッチ画像

    IT資産管理を継続するには、台帳を作成するだけでは十分ではありません。定期的な棚卸しや資産台帳の整備、ツールの活用、運用ルールの見直しなど、継続して管理できる仕組みづくりが重要です。本記事では、IT資産管理を効率化するための基本ステップと、実務で押さえたい運用のポイントを解説します。

    IT資産管理の基本について知りたい方は、まず「IT資産管理とは」をご覧ください。
    「IT資産管理とは?企業のセキュリティ対策で最初に取り組むべき理由を解説」

    IT資産管理は重要だと分かっていても、実際の運用では「台帳が更新されない」「管理対象が多すぎる」「クラウドやSaaSまで把握しきれない」といった悩みが起こりがちです。特に、少人数の情報システム部門や兼任体制の企業では、手作業だけでIT資産を正確に管理し続けるのは現実的ではありません。

    IT資産管理で押さえるべき基本ステップ

    IT資産管理を効率化するには、いきなりツールを導入するのではなく、基本ステップを整理することが大切です。最初に行うべきことは、管理対象の範囲を決めることです。PC、サーバー、ネットワーク機器、スマートフォン、タブレット、ソフトウェア、クラウドサービス、SaaS、アカウント、ライセンスのうち、どこまでをIT資産管理の対象にするのかを明確にします。次に、現在のIT資産を棚卸しします。棚卸しによって、台帳に載っていない端末、使われていないSaaS、放置されたクラウド環境、サポート期限が近いソフトウェアなどを洗い出します。その後、資産台帳を整備し、資産の種類、利用者、管理責任者、重要度、バージョン、サポート期限、最終確認日などを記録します。

    棚卸しを定期的に行う

    IT資産棚卸しは、IT資産管理の出発点です。棚卸しでは、以下のような複数の情報源を突き合わせます。ひとつの情報源だけに頼ると、見落としが発生しやすいため、複数の情報を照合することが重要です。

    • 購買台帳・リース契約
    • MDM/EDR
    • Active DirectoryやID管理基盤
    • クラウド管理画面
    • SaaSの契約情報 – ネットワーク接続情報

    たとえば、購買台帳には存在するのにEDRには表示されない端末があれば、未セットアップ、未接続、廃棄漏れの可能性があります。逆に、EDRやネットワーク上には存在するのに購買台帳や資産台帳にない端末があれば、未登録端末や持ち込み端末の可能性があります。クラウド環境では、誰が作成したか分からないインスタンス、公開設定のまま放置されたストレージ、検証後に削除されていないリソースを確認します。棚卸しの頻度は、企業規模やIT環境によって異なりますが、少なくとも年1回の一斉棚卸しだけでは変化に追いつきにくくなっています。端末の入れ替え、SaaS契約、クラウド環境の作成など、変化が多い領域については、月次や四半期単位で確認する運用が望ましいでしょう。

    どのような資産が見落とされやすいかについては「見落としがちなIT資産がセキュリティ事故を招く?企業で起こりやすい5つの管理課題」もあわせてご覧ください。

    資産台帳を整備する

    棚卸しで見つけたIT資産は、資産台帳に整理します。台帳は、単に資産名を並べるためのものではありません。脆弱性対応、パッチ適用、ライセンス管理、費用管理、インシデント対応に使える情報でなければ、実務では役に立ちません。資産台帳には、資産ID、資産種別、製品名、メーカー、OSやソフトウェアのバージョン、利用者、所属部門、管理責任者、設置場所、IPアドレス、利用目的、業務上の重要度、保存・処理する情報の種類、サポート期限、ライセンス情報、最終確認日などを記録します。すべてを最初から完璧に埋める必要はありませんが、脆弱性対応やインシデント対応に必要な項目は優先して整備するべきです。

    NIST SP 1800-5では、有効なIT資産管理は物理資産と仮想資産を結びつけ、資産が何で、どこにあり、どのように使われているかを把握できるようにするものと説明されています。 この視点を踏まえると、台帳は固定的な一覧ではなく、現場の利用実態を反映する情報基盤として設計する必要があります。

    ツールで自動化する

    IT資産管理を効率化するうえで、ツールによる自動化は有効です。管理対象が少ないうちは手作業でも対応できますが、端末、クラウド、SaaS、アカウント、ソフトウェアが増えると、人手だけで最新状態を維持するのは難しくなります。IT資産管理ツールを使えば、端末情報、インストール済みソフトウェア、OSバージョン、利用者情報、接続状況などを自動収集しやすくなります。MDMはモバイル端末やPCの管理に役立ち、EDRは端末の稼働状況やセキュリティ状態の把握に活用できます。クラウド環境では、クラウド管理ツールやCSPMによって、リソース、設定、公開状態、権限の可視化を進められます。SaaSについては、ID管理基盤やSaaS管理ツールと連携し、利用アカウントや不要ライセンスを確認します。

    IT資産管理ツールによって可視化した資産情報は、脆弱性管理にも活用できます。資産台帳とスキャン結果を結びつけることで、どの資産にどの脆弱性が存在するのかを把握しやすくなります。

    運用ルールを整備する

    IT資産管理は、ツールを導入するだけでは定着しません。新しい端末を購入したとき、SaaSを契約したとき、クラウド環境を作成したとき、従業員が異動・退職したとき、機器を廃棄したときに、誰が、いつ、どの情報を更新するのかを決めておく必要があります。

    ライフサイクル管理

    調達から廃棄までのライフサイクルにIT資産管理を組み込むことも重要です。購入申請時に資産登録を行い、利用開始時に管理責任者を設定し、定期的に利用状況を確認し、不要になったらアカウント停止やデータ消去、契約解除、廃棄証跡の保管まで行う。この流れが決まっていないと、台帳はすぐに古くなります。

    シャドーIT対策

    シャドーIT対策では、禁止だけでなく申請しやすい仕組みも必要です。現場が必要なツールを安全に使える申請ルート、承認済みSaaSの一覧、例外利用時の確認項目を整備することで、非公式な利用を減らしやすくなります。英国のサイバーセキュリティ機関NCSCも、「シャドーITは従業員が業務上の課題を解決しようとして発生することが多く、責めるのではなく、報告しやすいセキュリティ文化を作ることが重要」だと説明しています*6。

    IT資産の可視化を脆弱性管理やパッチ管理につなげる

    近年では、社内で管理しているIT資産だけでなく、インターネット上に公開されている資産を継続的に把握・管理するために、ASM(Attack Surface Management)を活用する企業も増えています。

    IT資産の可視化はゴールではありません。可視化した資産情報を、脆弱性管理やパッチ管理につなげることが重要です。NIST SP 800-40 Rev.4では、パッチ管理を、パッチやアップデートを識別し、優先順位付けし、取得し、適用し、適用結果を検証するプロセスとして説明しています。 その前提として、どの資産が存在し、どのソフトウェアやバージョンを利用しているかを把握している必要があります。たとえば、重大な脆弱性が公開された場合、資産台帳が整備されていれば、対象バージョンを利用している端末やサーバーをすばやく抽出できます。重要システム、外部公開システム、個人情報を扱うシステムなどを優先して対応する判断も可能になります。逆に、資産情報がなければ、全社に一斉確認を依頼するしかなく、対応に時間がかかります。

    IT資産管理、脆弱性管理、パッチ管理は別々の業務ではなく、つながった運用として設計することが重要です。IT資産を把握し、リスクを評価し、優先順位をつけ、対策し、結果を確認する。この流れができて初めて、セキュリティ対策は継続的に機能します。

    まとめ:効率化の目的は、管理を楽にすることではなく対応を早くすること

    IT資産管理を効率化する目的は、単に運用負荷を減らすことではありません。IT資産を継続的に把握し、脆弱性への対応やインシデント発生時の初動対応を迅速に行える状態を維持することが重要です。そのためには、定期的な棚卸しや資産台帳の整備、ツールによる自動化、運用ルールの見直しを組み合わせ、自社のIT環境に合わせた継続的な運用を構築しましょう。

    【参考情報】

    CIS(Center for Internet Security)「The 18 CIS Critical Security Controls」(https://www.cisecurity.org/controls/cis-controls-list)

    【関連記事】

    編集責任:木下


    公開IT資産を可視化してみませんか?

    社内で管理しているIT資産と、インターネット上から見える資産は必ずしも一致しません。攻撃者視点で公開資産を可視化する「アタックサーフェス調査サービス」をご紹介します。

    BBSecのアタックサーフェス調査サービス

    インターネット上で「攻撃者にとって対象組織はどう見えているか」調査・報告するサービスです。攻撃者と同じ観点に立ち、企業ドメイン情報をはじめとする、公開情報(OSINT)を利用して攻撃可能なポイントの有無を、弊社セキュリティエンジニアが調査いたします。


    Security Serviceへのリンクバナー画像
    BBsecコーポレートサイトへのリンクバナー画像
    セキュリティ緊急対応のバナー画像

    Security NEWS TOPに戻る
    バックナンバー TOPに戻る

    サッポロHD海外2社に不正アクセス ―海外グループ会社を狙うサイバー攻撃リスクとは

    Share
    「サッポロHD海外2社に不正アクセス」アイキャッチ画像

    サッポロホールディングスが公表した海外グループ会社2社への不正アクセスは、海外拠点を狙ったサイバー攻撃リスクを改めて浮き彫りにしました。現時点では情報漏洩の有無や影響範囲は調査中ですが、海外子会社や現地法人のセキュリティがグループ全体の事業継続や信頼に影響を及ぼす可能性があります。本記事では、本件の概要を整理するとともに、海外拠点が攻撃の入口になりやすい理由や、企業が見直すべき認証管理、ログ監視、脆弱性管理などの対策について解説します。

    ※本記事は2026年6月30日までに公開された情報もとに作成しています。ご覧いただく時期によっては古い情報となっている場合もありますので、ご承知おきください。


    サッポロホールディングス株式会社は2026年6月24日、同社の海外グループ会社2社のシステムに対して不正アクセスが発生したことを公表しました*2。対象となったのは、POKKA PTE. LTD.とSLEEMAN BREWERIES LTD.です。サイバー攻撃の恐れがある不正な通信ログを検知し、初動調査を行った結果、不正アクセスが判明したとされています。

    今回の事案で注目すべきなのは、国内本社ではなく海外グループ会社で不正アクセスが確認された点です。企業のグローバル展開が進むなか、海外子会社、海外拠点、現地法人、委託先、販売会社などを含めたセキュリティ対策は、もはや一部門だけの問題ではありません。サイバー攻撃は、もっとも守りが弱い場所から侵入し、グループ全体の信頼や事業継続に影響を及ぼす可能性があります。 サッポロホールディングスの公表によると、POKKA PTE. LTD.では2026年6月14日、SLEEMAN BREWERIES LTD.では同年6月17日に不正アクセスを確認しています。安全確保のため、関係するシステムや機器は遮断され、外部専門家の協力のもと原因や影響範囲の調査が進められています。公表時点では、情報漏洩の事実および影響範囲は確認中であり、国内事業への影響は確認されていません。また、2社への不正アクセスについて、現時点で因果関係は認められていないとされています。

    サッポロHDの海外グループ会社で何が起きたのか

    今回の不正アクセスは、サッポロホールディングスの海外グループ会社であるPOKKA PTE. LTD.とSLEEMAN BREWERIES LTD.において確認されました。POKKA PTE. LTD.は海外飲料事業、SLEEMAN BREWERIES LTD.は海外酒類事業に関係する企業です。サッポロホールディングスは海外酒類事業を北米中心に展開しており、海外飲料事業ではシンガポール、マレーシア、中東など約60か国でPOKKAブランドを展開していると説明しています。

    このことから、今回の事案は単なる「海外拠点のトラブル」として片付けるべきものではありません。企業が海外展開を進めるほど、システム、ネットワーク、アカウント、取引先、現地運用体制は複雑になります。国内本社のセキュリティレベルが高くても、海外子会社や現地拠点の監視体制、認証管理、端末管理、ログ管理が十分でなければ、攻撃者にとって侵入口になり得ます。ただし、現時点で公表されている情報からは、ランサムウェア攻撃であったか、特定の攻撃グループが関与したか、どのような情報が外部に流出したかは確認できません。したがって、本件を「情報漏洩事故」や「ランサムウェア被害」と断定することは避ける必要があります。一次ソースから確認できるのは、不正な通信ログの検知、不正アクセスの判明、関係システム・機器の遮断、外部専門家による調査、情報漏洩の有無は確認中という点です。

    なぜ海外グループ会社はサイバー攻撃の入口になりやすいのか

    海外グループ会社や海外子会社は、サイバー攻撃の入口になりやすい構造的なリスクを抱えています。理由の一つは、拠点ごとにIT環境やセキュリティ運用の成熟度が異なりやすいことです。本社ではEDR、ログ監視、多要素認証、脆弱性管理が整備されていても、海外拠点では現地事情や人員不足により、同じ水準の対策が実施されていないケースがあります。

    もう一つの理由は、グループ会社が業務上、本社や他拠点とつながっていることです。販売、製造、物流、会計、メール、クラウドサービスなど、業務に必要な連携がある以上、一つの拠点への不正アクセスが、別拠点への攻撃や認証情報の悪用につながる可能性は否定できません。今回のサッポロホールディングスの発表では2社間の因果関係は認められていないとされていますが、企業一般のリスクとしては、海外拠点を含めたグループ全体のセキュリティ統制が重要になります。

    独立行政法人情報処理推進機構(IPA)から公開された「情報セキュリティ10大脅威 2026」でも、組織向け脅威の上位に「サプライチェーンや委託先を狙った攻撃」が挙げられています。これは、攻撃者が必ずしも本丸である大企業や本社を直接狙うのではなく、関係会社、委託先、取引先、外部サービスなどを経由して侵入を試みるリスクが高まっていることを示しています。

    不正通信ログの検知が示す「早期発見」の重要性

    今回の公表で見落としてはならないのが、「サイバー攻撃の恐れがある不正な通信ログを検知した」という点です。不正アクセスは、必ずしも最初から目に見える被害として現れるわけではありません。ファイルが暗号化される、Webサイトが改ざんされる、顧客情報が公開されるといった被害が起きる前に、攻撃者がネットワーク内で探索や権限拡大を行っている場合があります。

    そのため、企業にとって重要なのは、攻撃を完全に防ぐことだけではなく、異常な通信、不審なログイン、通常と異なる端末挙動を早期に見つける体制です。ログを取得していても、監視や分析ができていなければ、攻撃の兆候を見逃してしまいます。特に海外拠点では、時差、言語、現地ベンダーとの契約、運用担当者の違いにより、インシデントの発見や報告が遅れる可能性があります。 不正アクセス対策では、ファイアウォールやウイルス対策ソフトだけでは不十分です。EDRによる端末監視、SIEMによるログ分析、SOCによる常時監視、ID管理、多要素認証、脆弱性診断、ペネトレーションテストなどを組み合わせ、攻撃を受けた場合でも早期に検知し、被害を最小化する考え方が求められます。

    情報漏洩が確認されていない段階でも対応が必要な理由

    サッポロホールディングスは、公表時点で情報漏洩の事実および影響範囲は確認中としています。ここで重要なのは、「漏洩が確認されていない」ことと「リスクがない」ことは同じではないという点です。サイバー攻撃では、外部送信の痕跡、認証情報の悪用、攻撃者の侵入経路、アクセスされたファイル、影響を受けたシステムを慎重に調査する必要があります。

    調査中の段階では、企業は被害範囲を過小評価することも、過度に断定することも避けなければなりません。公表内容において「確認中」「影響が確認された場合は速やかに報告」といった表現が使われているのは、調査結果に基づいて正確に説明する姿勢の表れといえます。企業が同様の事案に備えるためには、インシデント発生後の連絡体制、初動対応手順、システム遮断の判断基準、外部専門家への相談ルート、顧客・取引先への説明方針を事前に整備しておくことが重要です。サイバー攻撃を受けてから対応を考えるのではなく、攻撃を受ける前提で準備しておくことが、事業継続と信頼維持につながります。

    海外拠点を持つ企業が見直すべきセキュリティ対策

    海外グループ会社や海外子会社を持つ企業は、まずグループ全体のIT資産を把握する必要があります。どの拠点にどのシステムがあり、誰が管理し、どのネットワークとつながっているのかが分からなければ、リスクの評価も対策の優先順位付けもできません。

    次に重要なのが、認証情報の管理です。海外拠点のVPN、メール、クラウドサービス、業務システムに対して多要素認証を導入し、不要なアカウントや退職者アカウントを放置しないことが求められます。攻撃者は、脆弱性だけでなく、漏洩したID・パスワードや使い回された認証情報を悪用することがあります。

    また、脆弱性管理も欠かせません。海外拠点では、本社の管理外にあるサーバ、ネットワーク機器、リモートアクセス環境、業務アプリケーションが残っている場合があります。定期的な脆弱性診断や外部公開資産の棚卸しを行い、攻撃者から見える入口を減らすことが重要です。

    さらに、ログ監視とインシデント対応訓練も見直すべきです。不正通信ログを検知しても、その意味を判断できる人がいなければ対応は遅れます。検知、報告、遮断、調査、復旧、再発防止までの流れを整備し、海外拠点を含めて実効性を確認しておく必要があります。

    サイバー攻撃対策は「国内本社だけ」では足りない

    今回のサッポロホールディングスの事案は、海外グループ会社への不正アクセスとして公表されました。国内事業への影響は確認されていないとされていますが、企業にとっては、海外拠点を含むグループ全体のセキュリティを見直すきっかけになります。

    サイバー攻撃は、企業規模や知名度に関係なく、システムの弱点、管理のすき間、監視の遅れを突いてきます。特に海外展開を進める企業では、本社、海外子会社、委託先、取引先、クラウドサービスを含めた全体像を把握し、どこから攻撃されても早期に検知・対応できる体制を作ることが欠かせません。 不正アクセス、情報漏洩、ランサムウェア、サプライチェーン攻撃への備えは、もはや情報システム部門だけの課題ではありません。経営リスクとしてセキュリティを捉え、グループ全体で守る仕組みを整えることが、企業の信頼と事業継続を守るための第一歩です。

    まとめ

    サッポロホールディングスの海外グループ会社2社で確認された不正アクセスは、海外拠点を持つ企業にとって重要な示唆を含んでいます。公表時点では情報漏洩の有無や影響範囲は確認中であり、国内事業への影響も確認されていません。しかし、海外子会社や現地法人を含むグループ全体のセキュリティ管理が求められる時代であることは明らかです。

    企業は、海外拠点のセキュリティ対策を現地任せにせず、IT資産の把握、認証管理、脆弱性診断、ログ監視、インシデント対応体制の整備を進める必要があります。攻撃を完全に防ぐことが難しい今、重要なのは、侵入の兆候を早く見つけ、被害を広げない仕組みを持つことです。 サイバー攻撃対策を見直す際は、国内本社だけでなく、海外グループ会社、委託先、取引先、クラウド環境まで含めた全体像を確認することが欠かせません。今回の事案は、グローバル企業だけでなく、海外取引や外部委託を行うすべての企業にとって、自社のセキュリティ体制を点検する機会といえるでしょう。

    【参考情報】

    サッポロビール株式会社「当社の海外グループ会社2社のシステムへの不正アクセス発生について」(2026年6月24日公表)(https://www.sapporobreweries.com/notice/detail/20260624000010.html)

    編集責任:木下


    BBSecの脆弱性診断・セキュリティ対策支援サービス

    BBSec(ブロードバンドセキュリティ)では、Webアプリケーション診断、プラットフォーム診断、クラウド環境診断、脆弱性管理支援など、企業のセキュリティリスクを可視化する各種サービスを提供しています。外部サービスや委託先を含めたセキュリティ体制の見直し、情報漏えいリスクへの備え、インシデント発生前の予防対策を検討している企業は、ぜひご相談ください。


    ウェビナー開催のお知らせ

  • 2026年7月8日(水)13:00~14:00「企業は何から対策すべきか?― OWASP Top 10:2025から読み解く、最新のセキュリティリスクと対策の考え方 ―」
  • 2026年7月15日(水)14:00~15:00「AI事業者ガイドライン第1.2版に基づくセキュリティ対策の実践ポイント~生成AIからAIエージェントへ~」
  • 2026年7月22日(水)14:00~15:00「そのIT資産、本当に把握できていますか?~見落としがちなセキュリティリスクと対策の第一歩~」
  • 最新情報はこちら


    Security Serviceへのリンクバナー画像
    BBsecコーポレートサイトへのリンクバナー画像
    セキュリティ緊急対応のバナー画像

    Security NEWS TOPに戻る
    バックナンバー TOPに戻る

    インシデント対応体制とは?CSIRTの役割と企業が整えるべき運用のポイント

    Share
    「インシデント対応体制とはCSIRTの役割と企業が整えるべき運用のポイント」アイキャッチ画像

    サイバー攻撃や情報漏えいなどのセキュリティインシデントでは、迅速かつ適切な対応が被害の拡大防止につながります。そのためには、担当者任せではなく、役割分担や連絡体制をあらかじめ整備しておくことが重要です。本記事では、インシデント対応体制の基本的な考え方をはじめ、CSIRTやSOCの役割、企業が体制を構築・運用する際のポイントを解説します。

    インシデント管理の全体像については、以下の記事をご覧ください。
    「セキュリティインシデント管理とは?企業が押さえるべき対応フローと体制の全体像」

    サイバー攻撃や情報漏洩、ランサムウェア感染、不正アクセスなどのセキュリティインシデントは、発生してから担当者が個別に対応するだけでは十分に対処できません。インシデント対応では、技術的な調査や復旧だけでなく、経営判断、法務確認、顧客対応、広報対応、取引先との調整など、複数の部門が関係します。

    そのため、企業にはあらかじめインシデント対応体制を整備しておくことが求められます。誰が異常を受け付け、誰が初動対応を判断し、誰が調査を進め、誰が経営層や外部関係者へ報告するのかが決まっていなければ、発生直後の混乱を避けることはできません。JPCERT/CCは「CSIRTマテリアル」について、組織的なインシデント対応体制である「組織内CSIRT」の構築を支援する目的で作成したものと説明しています。また、すべての組織が同じ形のCSIRTを持つべきというものではなく、それぞれの組織の状況に応じた適切な形があるとしています。つまり、インシデント対応体制は、大企業だけが整備する特別な仕組みではなく、企業規模や事業内容に応じて現実的に設計すべきものです。

    なぜ体制が必要なのか

    インシデント対応体制が必要な理由は、セキュリティインシデントが一部門だけで完結する問題ではないためです。たとえば、マルウェア感染が発生した場合、情報システム部門は端末隔離やログ調査を行います。しかし、個人情報漏洩の可能性があれば法務や個人情報保護の担当部門が関与し、顧客影響があれば営業やカスタマーサポートが対応し、外部公表が必要になれば広報や経営層の判断が必要になります。

    不正アクセスやランサムウェア感染では、技術的な調査と同時に、事業継続の判断も必要になります。システムを停止するのか、どの業務を優先して復旧するのか、取引先へいつ説明するのかといった判断は、現場担当者だけで決められるものではありません。事前に体制がなければ、関係者への連絡が遅れ、対応の優先順位も曖昧になります。

    NIST SP 800-61 r2「Computer Security Incident Handling Guide」でも、効果的なインシデント対応は複雑な取り組みであり、成功する対応能力を確立するには、計画とリソースが必要であるとされています。また、インシデント対応では、IT部門だけでなく、法務などの内部関係者や、外部のインシデント対応チーム、法執行機関などとの連携も想定されています。

    体制がない企業では、インシデントが発生したときに「誰に報告すればよいか分からない」「誰が判断責任を持つのか分からない」「外部ベンダーに何を依頼すればよいか分からない」という状態になりがちです。平時であれば多少の確認不足は補えますが、インシデント発生時には時間が限られています。対応の遅れは、被害拡大や情報漏洩、事業停止、信用低下につながる可能性があります。

    独立行政法人情報処理推進機構(IPA)が公開するプラクティス・ナビ「指示7 インシデント発生時の緊急対応体制の整備」の中で、CSIRT等の対応体制が整備されていないこと、証拠保全ルールや外部報告・公表ルールが定められていないこと、想定インシデントに応じた分析・対応手順がないこと、CSIRT業務が属人化していること、演習を行っていないことを課題として挙げています。

    インシデント対応体制とは、単に担当者の名前を決めることではありません。発生時に必要な判断、作業、報告、連携を整理し、組織として動ける状態にすることです。対応体制が整っていれば、発生直後の混乱を抑え、被害拡大防止、原因調査、復旧、再発防止までを一貫して進めやすくなります。

    インシデント対応体制の基本構成

    インシデント対応体制は、企業規模や業種、システム構成によって異なります。ただし、多くの企業に共通する基本構成として、CSIRT、SOC、各部門の連携があります。これらはそれぞれ役割が異なり、単独で機能するものではありません。CSIRTは、インシデント対応を組織として進めるための中核的な役割を担います。インシデントの受付、事実確認、対応方針の調整、関係部門への連絡、外部機関や専門ベンダーとの連携、再発防止策の整理などを担うことが一般的です。企業によっては、専任組織として設置される場合もあれば、情報システム部門やセキュリティ担当者を中心に兼任体制で運用される場合もあります。SOCは、Security Operation Centerの略で、主に監視や検知、分析を担う機能です。EDR、SIEM、ファイアウォール、クラウド監査ログ、認証ログなどを監視し、不審な通信や挙動を検知します。SOCは、インシデントの兆候を早期に発見し、CSIRTや情報システム部門へエスカレーションする役割を持ちます。自社内にSOCを持つ企業もありますが、専門ベンダーのSOCやMDRサービスを活用する企業もあります。

    各部門の役割も重要です。情報システム部門は、端末、サーバ、ネットワーク、クラウド環境の技術的対応を担います。法務部門は、個人情報保護法や契約上の責任、監督官庁への報告要否などを確認します。広報部門は、外部公表やメディア対応、顧客向け説明文の調整を担います。営業部門やカスタマーサポート部門は、顧客や取引先からの問い合わせ対応を担います。経営層は、事業停止や外部公表、重大なリスク判断について意思決定を行います。

    これらの体制は、実際のインシデント対応フローの中で機能します。具体的な対応手順については、以下の記事で詳しく解説しています。
    「インシデント対応フローとは?発生時に企業が取るべき手順と判断ポイント」

    重要なのは、CSIRT、SOC、各部門の役割を分けるだけでなく、連携の流れを決めておくことです。SOCが検知したアラートを誰に報告するのか、CSIRTがどの基準で重大度を判断するのか、法務や広報をどのタイミングで巻き込むのか、経営層への報告基準は何かを定めておかなければ、体制図があっても実際には動きません。インシデント対応体制は、組織図上の箱を作ることではなく、実際に発生したときに機能する連絡・判断・対応の仕組みを作ることです。

    CSIRTとは何か

    CSIRTとは、Computer Security Incident Response Teamの略で、コンピューターセキュリティインシデントに対応するチームを意味します。JPCERT/CCによれば、CSIRTは「Computer Security Incident Response Team=コンピューターセキュリティインシデントに対応するチーム」の略であると説明されています。CSIRTの役割は、単に技術的な調査を行うことだけではありません。組織内で発生したインシデントの情報を集約し、対応方針を整理し、関係部門をつなぎ、必要に応じて外部機関や専門ベンダーと連携することが重要な役割です。企業によっては、脆弱性情報の収集、注意喚起、セキュリティ教育、訓練、再発防止策の推進など、平時の活動もCSIRTが担う場合があります。

    JPCERT/CCの公開する資料「組織内 CSIRT の役割とその範囲」では、組織内CSIRTの役割には違いがあり、インシデントへの直接対応、支援的対応、調整役としての対応などが示されています。つまり、CSIRTは必ずしもすべての技術対応を自ら行う必要はありません。企業の体制に応じて、現場対応を支援する立場、部門間を調整する立場、外部専門家との窓口になる立場など、現実的な役割を設計することが重要です。

    CSIRTが必要とされる理由は、インシデント発生時に情報と判断を一元化するためです。インシデント対応では、端末の隔離、ログ調査、外部連絡、顧客説明、法務判断、復旧作業など、さまざまな対応が同時に発生します。これらが各部門でばらばらに進むと、情報の食い違いや判断の遅れが起こりやすくなります。CSIRTが中心となって情報を集約すれば、経営層への報告も整理しやすくなります。経営層が必要とするのは、単なる技術情報ではなく、事業への影響、顧客への影響、復旧見通し、法的・契約上のリスク、外部公表の必要性などです。CSIRTは、技術部門と経営判断をつなぐ役割を担うことで、インシデント対応を企業全体のリスク対応として進めやすくします。ただし、CSIRTは設置するだけでは機能しません。連絡先が古い、権限が曖昧、判断基準がない、訓練をしていない、担当者が兼任で実質的に動けないといった状態では、有事に十分な役割を果たせません。CSIRTの必要性を理解したうえで、自社の規模やリソースに合った運用を設計することが大切です。

    体制が機能しない原因

    インシデント対応体制が機能しない原因として、最も多いのが属人化です。特定の担当者だけがシステム構成を理解している、ログの確認方法を知っている、外部ベンダーとの連絡先を把握している、過去のインシデント対応の経緯を覚えているという状態では、その担当者が不在のときに対応が止まります。属人化は、日常業務では見えにくい問題です。詳しい担当者がいれば、普段のトラブルはその人が解決できてしまいます。しかし、インシデント発生時には、短時間で多くの判断と作業が必要になります。特定の個人に情報や判断が集中すると、対応速度が落ち、確認漏れや連絡漏れが起こりやすくなります。

    IPAのプラクティス・ナビ「プラクティス7-4 CSIRT業務の属人化回避も兼ねたインシデントや脅威に関する情報の共有・蓄積」では、CSIRT業務の属人化回避を目的とした情報共有・蓄積の重要性を示しています。公開されている事例でも、CSIRT設立の中核だった従業員が退職した際に対応能力が低下し、その後、業務を属人化させない仕組みの整備が必要になったことが紹介されています。

    もう一つの原因は、判断基準がないことです。どのアラートをインシデントとして扱うのか、どの段階でCSIRTを招集するのか、端末隔離やシステム停止を誰が判断するのか、外部報告や公表を検討する基準は何かが決まっていなければ、現場は迷います。判断基準がないと、対応は担当者の経験や感覚に依存します。経験豊富な担当者であれば適切に判断できる場合もありますが、担当者が変われば対応品質も変わります。また、重大なインシデントほど、技術的な判断だけでなく、事業影響や法務リスク、顧客影響を含めた判断が必要になります。判断基準が曖昧なままでは、経営層への報告も遅れやすくなります。

    体制が機能しない企業では、形式的な体制図だけが存在していることもあります。CSIRTという名前はあるものの、実際のメンバー、役割、権限、連絡手順、訓練計画が決まっていない状態です。このような体制では、インシデント発生時に「誰が何をするのか」を改めて確認することになり、初動対応が遅れます。 さらに、部門間の連携不足も大きな要因です。情報システム部門が技術対応を進めていても、法務や広報、営業、経営層への共有が遅れると、顧客説明や外部公表の準備が間に合いません。反対に、経営層や広報が十分な事実確認を待たずに情報発信を進めると、誤った説明につながる可能性があります。インシデント対応体制を機能させるには、体制図を作るだけでなく、情報共有の流れ、判断権限、報告基準、記録方法を具体化する必要があります。

    体制構築のポイント

    インシデント対応体制を構築するうえで重要なのは、まず対応フローを明確にすることです。検知、初動対応、調査、復旧、再発防止という流れの中で、誰がどの工程を担当するのかを整理します。たとえば、従業員からの不審メール報告を誰が受け付けるのか、SOCや監視サービスのアラートを誰が確認するのか、感染端末の隔離を誰が実施するのか、経営層への報告を誰が行うのかを定めます。このとき、細かすぎる手順書を作ることよりも、実際に使える判断ルールを整備することが大切です。インシデントは事案ごとに状況が異なるため、すべてを手順書通りに進められるとは限りません。だからこそ、重大度の判断基準、エスカレーション条件、外部連携の基準、証拠保全の原則、復旧判断の考え方を整理しておく必要があります。

    IPA「サイバーセキュリティ経営ガイドライン Ver3.0 実践のためのプラクティス集 第4版」では、インシデント発生時の緊急対応体制の整備として、司令塔としてのCSIRTの設置、従業員の初動対応の規定、想定されるインシデントに関するセキュリティ分析計画の事前策定、情報共有・蓄積、インシデント対応演習などが示されています。

    次に重要なのが、訓練です。手順書や体制図を作っても、実際に動かしていなければ、有事に機能するとは限りません。インシデント対応訓練では、ランサムウェア感染、不正アクセス、情報漏洩、Webサイト改ざん、委託先からの侵害連絡など、想定シナリオをもとに、連絡、判断、報告、初動対応の流れを確認します。訓練では、技術対応だけでなく、経営層への報告、法務確認、広報文案の検討、顧客問い合わせへの対応、外部ベンダーへの連絡も含めて確認することが望ましいです。実際に演習してみると、連絡先が古い、判断者が不在時の代替ルートがない、ログの取得範囲が不足している、委託先との責任分界点が曖昧といった課題が見つかります。

    体制構築では、外部リソースの活用も現実的な選択肢になります。すべての企業が専任CSIRTや自社SOCを持てるわけではありません。特に中堅・中小企業では、情報システム部門が日常業務とセキュリティ対応を兼任しているケースも多くあります。その場合は、外部SOC、MDR、インシデント対応支援ベンダー、フォレンジック調査会社、顧問弁護士、保険会社など、必要な支援先を平時から整理しておくことが重要です。ただし、外部委託すればすべて任せられるわけではありません。外部ベンダーが調査や監視を支援しても、最終的な事業判断、顧客対応、外部公表、再発防止策の実行は企業自身が行う必要があります。外部リソースは、自社の対応体制を補完するものとして位置づけることが大切です。

    インシデント対応体制の整備は、情報漏洩対策全体の一部でもあります。あわせて以下の記事もご確認ください。
    「情報漏洩対策とは何か ―企業が知るべき原因・リスク・防止策の全体像―」

    まとめ

    インシデント対応体制とは、セキュリティインシデントが発生したときに、企業が組織として対応するための仕組みです。CSIRT、SOC、情報システム部門、法務、広報、営業、経営層などが連携し、検知、初動対応、調査、復旧、再発防止を進められる状態を整えることが重要です。CSIRTは、インシデント対応の司令塔や調整役として、情報を集約し、対応方針を整理し、関係部門や外部機関との連携を担います。SOCは、監視や検知、分析を通じて、インシデントの兆候を早期に発見する役割を持ちます。各部門は、それぞれの専門性に基づいて、技術対応、法務判断、顧客説明、広報対応、経営判断を担います。

    一方で、体制は作るだけでは機能しません。属人化した対応、曖昧な判断基準、古い連絡先、訓練不足、部門間連携の弱さがあると、インシデント発生時に初動が遅れます。特に、誰が判断し、誰が報告し、誰が外部と連携するのかが曖昧な状態では、対応の品質は担当者個人に依存してしまいます。 企業がまず取り組むべきことは、自社のインシデント対応フローを整理し、役割分担と連絡ルートを明確にすることです。そのうえで、重大度の判断基準、証拠保全ルール、外部報告・公表の検討基準、委託先や外部ベンダーとの連携方法を定め、定期的な訓練によって実効性を確認する必要があります。インシデント対応体制は、セキュリティ部門だけのための仕組みではありません。情報漏洩対策、事業継続、顧客信頼、経営リスク管理を支える重要な基盤です。自社の規模に合った現実的な体制から整備し、継続的に見直していくことが、インシデント発生時の被害最小化につながります。

    【参考情報】

    編集責任:木下


    サイバーインシデント緊急対応

    サイバーセキュリティ緊急対応電話受付ボタン
    SQAT緊急対応バナー

    ウェビナー開催のお知らせ

    最新情報はこちら


    資料ダウンロードボタン
    年二回発行されるセキュリティトレンドの詳細レポート。BBSecで行われた診断の統計データも掲載。
    お問い合わせボタン
    サービスに関する疑問や質問はこちらからお気軽にお問合せください。

    Security Serviceへのリンクバナー画像
    BBsecコーポレートサイトへのリンクバナー画像
    セキュリティ緊急対応のバナー画像

    Security NEWS TOPに戻る
    バックナンバー TOPに戻る

    セキュリティインシデント発生時の対応 ―初動から復旧まで解説―

    Share
    セキュリティインシデント発生時の対応アイキャッチ画像

    セキュリティインシデントが発生した際は、限られた時間の中で被害拡大を防ぎ、原因を調査し、業務復旧を進める必要があります。しかし、実際の現場では「まず何をすべきか」「どこまで影響が広がっているのか」「誰に報告すべきか」と判断に迷うケースも少なくありません。

    初動対応の遅れや判断ミスは、情報漏えいや業務停止などの被害拡大につながる可能性があります。本記事では、セキュリティインシデント発生時に企業が取るべき対応について、初動対応から復旧までの流れを解説します。

    なお、インシデント管理の全体像については、以下の記事で詳しく解説しています。
    「セキュリティインシデント管理とは?企業が押さえるべき対応フローと体制の全体像」

    インシデント対応が遅れると被害が拡大する―「初動対応」の重要性

    セキュリティインシデントが発生した際、最初に求められるのは「被害の拡大を防ぐこと」です。具体的には、該当システムのネットワーク接続を遮断する、影響範囲を限定する、ログを確保して証拠を保存するといった行動が挙げられます。ここで重要なのは、焦ってシステムを完全に停止させたり証拠を消去したりしてしまわないことです。例えば、感染が疑われるPCを慌てて初期化すると、攻撃経路やマルウェアの痕跡といった重要な調査情報を失うことになり、後続の対応が困難になります。そのため、インシデント発生時には「まず拡大防止と証拠保全を優先する」という基本原則を徹底する必要があります。初動段階での判断ミスが、被害規模や復旧にかかる時間を大きく左右するのです。

    セキュリティインシデント対応の基本フロー

    社内連携と報告体制

    セキュリティインシデントが発生した際、技術的な対応と同じくらい重要なのが「社内連携と報告体制」です。現場担当者が異常を検知した場合、直属の上司や情報システム部門への迅速な報告はもちろん、経営層へのエスカレーションルートを明確にしておくことが不可欠です。さらに、インシデント対応を一部門だけに任せるのではなく、法務・広報・総務など関連部門との連携が欠かせません。例えば、法務部門は法的リスクの確認や外部機関への届出判断を担い、広報部門は顧客や取引先への適切な情報発信を行います。これらが連携できていないと、組織全体としての対応が後手に回り、混乱や信頼失墜を招く恐れがあります。そのため、平常時から「誰が・どのタイミングで・誰に報告するか」を明文化したインシデント対応計画を整備しておくことが重要です。

    被害範囲の特定

    セキュリティインシデントが発生した際に、初動対応で重要なのが「被害範囲の特定」です。単なる障害や一時的な不具合と、外部からの不正アクセスやマルウェア感染といったインシデントを明確に区別する必要があります。具体的には、ログの解析やネットワーク監視、ユーザ報告などを通じて、侵入経路や影響を受けたシステム、漏洩が疑われる情報を洗い出します。この段階で誤った判断を下すと、被害を過小評価して対応が遅れたり、逆に過大評価して不要な混乱を招いたりするリスクがあります。そのため、迅速かつ客観的に状況を評価できる仕組みを整えておくことが欠かせません。

    被害の封じ込め・拡大防止

    被害範囲を特定した後は、被害の「封じ込め」が必要です。これは、インシデントの拡大を防ぎ、さらなる被害を最小限に抑えるための重要なプロセスです。例えば、侵害を受けたサーバをネットワークから切り離す、攻撃者が利用したアカウントを即座に無効化する、通信を一時的に遮断するなどの対応が考えられます。ただし、封じ込めの方法を誤ると、証拠が失われたり、攻撃者に異変を察知されて活動を隠蔽されたりする恐れもあります。そのため、封じ込めの対応はセキュリティチーム内で役割を明確にし、優先順位を付けて慎重に進めることが求められます。

    原因調査・ログ解析・フォレンジック調査

    封じ込めが完了した後は、インシデントの原因を突き止める「原因調査」が不可欠です。攻撃者がどのように侵入したのか、どの脆弱性を悪用したのか、内部関係者の過失や不正が関与していないかなど、多角的な視点から調査を進める必要があります。ログ解析やフォレンジック調査を通じて、攻撃経路や被害状況を正確に把握することが求められます。この段階で調査が不十分だと、再発防止策が不完全となり、再び同様の被害を招く可能性が高まります。そのため、外部のセキュリティ専門家の協力を得るケースも少なくありません。

    復旧対応

    原因が特定された後は、システムやサービスの復旧作業に移ります。ただ単に停止したサービスを再開させるのではなく、原因を取り除き、安全性を確認したうえで再稼働することが重要です。例えば、脆弱性が悪用されていた場合はセキュリティパッチを適用し、不正アクセスで改竄されたデータがあればバックアップから復旧します。また、復旧の際には「段階的な再開」を意識することが推奨されます。いきなり全システムを戻すのではなく、優先度の高いシステムから順に稼働させ、監視を強化しながら正常性を確認することで、再度の障害発生や攻撃再開のリスクを軽減できます。

    関係者への報告・情報共有

    復旧作業と並行して、関係者への適切な報告や情報共有も欠かせません。セキュリティインシデントは自社だけの問題ではなく、取引先や顧客、さらには規制当局にまで影響が及ぶ可能性があります。そのため、影響範囲を正確に把握したうえで、必要な関係者に迅速かつ誠実に情報を提供することが求められます。特に個人情報漏洩が発生した場合、法令やガイドラインに従った報告が義務付けられているケースも多く、対応を怠れば法的リスクや企業の信頼失墜につながります。また、社内向けの情報共有も重要であり、従業員が不安や誤情報に惑わされないよう、明確なメッセージを発信する体制を整えることが望まれます。

    再発防止策の検討

    インシデント対応の最終段階は、再発を防ぐための改善策を講じることです。単に原因を修正するだけでなく、組織全体のセキュリティ体制を見直す機会として活用することが重要です。例えば、脆弱性管理の仕組みを強化する、アクセス制御のルールを見直す、ログ監視やアラートの精度を高めるなど、技術的な改善が挙げられます。また、従業員へのセキュリティ教育や定期的な訓練を実施し、人為的なミスや不注意を減らす取り組みも効果的です。さらに、インシデント対応の流れを記録し、振り返り(ポストモーテム)を行うことで、今後同様の事態が発生した際に迅速かつ適切に対処できる体制を構築できます。

    BBSecでは

    セキュリティインシデントの再発防止や体制強化を確実に行うには、専門家の支援を受けることも有効です。BBSecでは緊急対応支援サービスも提供しています。突然の大規模攻撃や情報漏洩の懸念等、緊急事態もしくはその可能性が発生した場合は、BBSecにご相談ください。セキュリティのスペシャリストが、御社システムの状況把握、防御、そして事後対策をトータルにサポートさせていただきます。

    サイバーインシデント緊急対応

    サイバーセキュリティ緊急対応電話受付ボタン
    SQAT緊急対応バナー

    まとめ

    本記事では、セキュリティインシデントが発生した際に組織が取るべき対応を、初動から原因調査、復旧、関係者への報告、そして再発防止まで段階的に解説しました。インシデント対応は単なる技術的作業ではなく、社内連携や外部機関との調整、法令遵守、そして企業全体の信頼維持といった広範な要素が関わります。特に初動対応の速さや正確さは被害の拡大を防ぐ鍵となるため、日頃からの対応体制の整備や訓練が欠かせません。次回第3回では、インシデントの発生を未然に防ぐ取り組みや、組織全体でのセキュリティ強化策について詳しく解説し、実践的な予防策のポイントを紹介します。

    インシデント発生時の対応を円滑に進めるためには、平時から対応体制を整備しておくことが重要です。
    「インシデント対応体制とは?CSIRTの役割と企業が整えるべき運用のポイント」

    【参考情報】

    公開日:2025年10月8日
    更新日:2026年6月17日

    編集責任:木下


    ウェビナー開催のお知らせ

    最新情報はこちら

    資料ダウンロードボタン
    年二回発行されるセキュリティトレンドの詳細レポート。BBSecで行われた診断の統計データも掲載。
    お問い合わせボタン
    サービスに関する疑問や質問はこちらからお気軽にお問合せください。

    Security Serviceへのリンクバナー画像
    BBsecコーポレートサイトへのリンクバナー画像
    セキュリティ緊急対応のバナー画像

    Security NEWS TOPに戻る
    バックナンバー TOPに戻る

    セキュリティインシデントとは?基礎知識と代表的な事例を解説

    Share

    Security NEWS TOPに戻る
    バックナンバー TOPに戻る

    セキュリティインシデントとは何か?基礎知識と代表的な事例アイキャッチ画像

    サイバー攻撃や情報漏えい、不正アクセス、ランサムウェア感染など、企業を取り巻くセキュリティリスクは年々増加しています。こうした事象は「セキュリティインシデント」と呼ばれ、発生した場合は情報資産の損失だけでなく、事業停止や信用低下につながる可能性があります。

    しかし、「どのような事象がセキュリティインシデントに該当するのか」「企業はどのようなリスクを認識すべきか」を正しく理解できていないケースも少なくありません。

    本記事では、セキュリティインシデントの定義や代表的な事例、企業への影響についてわかりやすく解説します。

    インシデント管理や対応フローの全体像については、関連記事もあわせてご覧ください。
    「セキュリティインシデント管理とは?企業が押さえるべき対応フローと体制の全体像」

    セキュリティインシデントの定義

    セキュリティインシデントとは、情報システムやネットワークにおいて、情報のセキュリティの3要素、「機密性」「完全性」「可用性」を脅かす事象の総称です。具体的には、不正アクセスや情報漏洩、マルウェア感染、サービス運用妨害(DoS)攻撃などが含まれます。近年はクラウドやリモートワークの普及により、攻撃対象や被害の範囲が広がり、セキュリティインシデントの発生リスクは増大しています。国内外で大規模な事件が相次いで報道されるなか、インシデントの発生はもはや大企業に限られた問題ではなく、中小企業や自治体、教育機関に至るまで幅広い組織が直面しています。そのため、経営層から現場担当者に至るまで、セキュリティインシデントへの理解と備えが求められているのです。

    セキュリティインシデントの種類(例)

    一口にセキュリティインシデントといっても、その内容は多岐にわたります。代表的なものとしては、まず「不正アクセス」が挙げられます。攻撃者が外部からシステムに侵入し、機密情報を窃取したり改竄したりするケースです。次に「マルウェア感染」があります。ウイルスやランサムウェアなどの悪意あるソフトウェアにより、データが暗号化され業務が停止する被害が増えています。また、従業員による「内部不正」も見逃せません。権限を持つ社員が意図的に情報を持ち出すケースや、誤操作による情報流出が問題化しています。さらに「情報漏洩」や「サービス停止(DoS/DDoS攻撃など)」も、企業活動を直撃する深刻なインシデントです。このようにセキュリティインシデントは外部攻撃だけでなく、内部要因やシステム障害など多面的に発生し得るため、幅広い視点での備えが不可欠です。

    実際に発生した主なセキュリティインシデント事例

    セキュリティインシデントは国内外で日々多発しています。この表は2025年8月から9月にかけて発生した主要な国内インシデント事例をまとめたものです。ランサムウェア攻撃や不正アクセスによる被害が多く、特に製造業や重要インフラへの影響が深刻化している傾向が見られます。

    被害報告日被害企業概要主な原因影響範囲
    2025年9月国内ガス・電力会社人為的ミスLPガス検針端末の紛失顧客情報6,303件の漏洩等のおそれ*2
    2025年9月国内デジタルサービス運営委託事業者個人情報漏洩受講状況管理ツールへの登録作業ミスリスキリングプログラム受講者1名の個人情報が他の受講者1名に閲覧可能に*2
    2025年9月国内食料品小売業個人情報漏洩サーバへの第三者からの不正アクセス企業情報及び個人情報が流出した可能性*3
    2025年9月委託事業者操作・管理ミスオペレーターの利用者情報取り違い高齢者の見守り・安否確認が行われず*4
    2025年9月国内オフィス機器販売会社個人情報漏洩第三者による不正アクセスカード支払い顧客の情報漏洩の可能性*5
    2025年8月ハウステンボス株式会社システム障害第三者による不正アクセス一部サービスが利用できない状況に*6
    2025年8月国内電力関連会社不正ログインリスト型攻撃(複数IPアドレスから大量ログイン試行)ポイント不正利用444件*7
    2025年8月国内機器メーカー企業不正アクセス海外グループ会社を経由した第三者の不正アクセス一部サービス提供停止(8月16日復旧)*8
    2025年8月医療用メーカー企業マルウェア感染システムのランサムウェア感染2日間出荷停止、その後再開*9
    2025年8月国内建設事業者マルウェア感染システムのランサムウェア感染海外グループ会社の一部サーバが暗号化*10
    2025年8月国内外郭団体乗っ取り第三者による一部メールアドレスの乗っ取り迷惑メール送信元として悪用*11
    2025年8月暗号資産交換事業者クラウド設定ミス顧客データ移転作業中のクラウド設定ミス海外メディアの報道で発覚、アクセス制限不備*12
    2025年8月国内銀行元従業員による情報の不正取得出向職員による電子計算機使用詐欺アコムから出向の元行員が逮捕・懲戒解雇*13
    2025年8月国内病院個人情報不正利用委託職員が診療申込書から電話番号を不正入手LINEで患者に私的メッセージを送付*14
    2024年12月国内総合印刷事業者マルウェア感染VPNからの不正アクセス(パスワード漏洩または脆弱性悪用)複数のサーバが暗号化される被害*15

    これらの事例は「セキュリティインシデントは特定の大企業だけの問題ではない」という現実を示しており、規模や業種にかかわらず備えが不可欠であることを強調しています。

    セキュリティインシデントが企業に与える影響

    セキュリティインシデントが発生すると、企業は多方面に深刻な影響を受けます。最もわかりやすいのは、システム停止や情報漏洩に伴う金銭的損失です。業務が一時的に止まることで売上が減少し、復旧作業や調査にかかる費用も膨大になります。さらに、顧客情報や取引先情報が流出すれば、企業の信頼性が大きく揺らぎ、契約解除や取引停止に直結する可能性があります。また、個人情報保護法や業界ごとのセキュリティ基準に違反すれば、法的責任や行政処分を受けるリスクも高まります。株式市場に上場している企業であれば、セキュリティインシデントの公表によって株価が急落するケースも少なくありません。このように、単なるシステム障害にとどまらず、企業経営全体に打撃を与える点がセキュリティインシデントの恐ろしさといえます。

    セキュリティインシデントを理解したら、次に重要なのは実際に発生した際の対応手順です。初動対応から復旧までの流れについては、以下の記事で詳しく解説しています。
    「インシデント対応フローとは?発生時に企業が取るべき手順と判断ポイント」

    まとめ

    本記事では、セキュリティインシデントの定義や種類、実際に発生した事例、そして企業に及ぼす影響について解説しました。改めて強調すべきは、セキュリティインシデントは大企業だけでなく、中小企業や自治体、教育機関などあらゆる組織にとって現実的な脅威であるという点です。しかも一度発生すると、金銭的損失だけでなく、顧客や取引先からの信頼低下、法的リスク、社会的信用の失墜といった連鎖的な被害を引き起こします。こうした背景から、セキュリティインシデントを「発生してから考える」姿勢ではなく、「発生する前提で備える」姿勢が求められています。次回は、実際にインシデントが発生した際にどのような対応が必要なのか、初動から復旧までの流れを詳しく解説します。

    【関連記事】

    セキュリティインシデントへの理解を深めたい方は、以下の記事もあわせてご覧ください。

    【参考情報】

    公開日:2025年10月1日
    更新日:2026年6月17日

    編集責任:木下


    サイバーインシデント緊急対応

    サイバーセキュリティ緊急対応電話受付ボタン
    SQAT緊急対応バナー

    ウェビナー開催のお知らせ

    最新情報はこちら

    資料ダウンロードボタン
    年二回発行されるセキュリティトレンドの詳細レポート。BBSecで行われた診断の統計データも掲載。
    お問い合わせボタン
    サービスに関する疑問や質問はこちらからお気軽にお問合せください。

    Security Serviceへのリンクバナー画像
    BBsecコーポレートサイトへのリンクバナー画像
    セキュリティ緊急対応のバナー画像

    Security NEWS TOPに戻る
    バックナンバー TOPに戻る